并行文件系统 hadoop云存储解决方案
电脑杂谈 发布时间:2018-02-12 15:39:34 来源:网络整理Hadoop是一个由Apache基金会所开发的分布式系统基础架构。
用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。
Hadoop实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS。HDFS有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。HDFS放宽了(relax)POSIX的要求,可以以流的形式访问(streaming access)文件系统中的数据。
Hadoop的框架最核心的设计就是:HDFS和MapReduce。HDFS为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。并行文件系统
基于Hadoop的校园云存储系统
服务器使用Linux操作系统,采用MapReduce编程算法实现并行处理。
HDFS(Hadoop Distributed File System)是一个运行在普通硬件之上的分布式文件系统。HDFS系统采用Master/Slave框架,一个HDFS集群系统是由一个Master和多个Slaver构成。前者叫做名字节点(NameNode),是一个中心服务器负责元数据的管理工作,主要包括文件系统的名字空间管理和客户机对文件的访问操作。后者叫做数据节点(DataNode),在集群系统中一般一个节点是由一个DataNode构成的,主要负责对节点上它们附带的存储进行管理。
HDFS系统中文件的目录结构独立存储在NameNode上,对于具体的文件数据来说,一个文件数据其实被拆分成若干block,这些block冗余存储在DataNode集合数据里。NameNode负责执行文件系统的Namespace管理工作,主要包括关闭,打开和重命名数据文件和目录等操作,同时负责建立block和DataNode节点的映射关系。客户机的读写需求是由DataNode节点响应完成的,同时DataNode节点在NameNode的统一指挥下进行Block的创建,删除和复制等操作。
MapReduce编程模型是一种编程模型,是云计算的核心计算模式,用于数据集的并行计算。MapReduce借用了函数式编程的思想,把海量数据集的常见操作抽象为Map(映射)和Reduce(化简)两种集合操作。通过Map函数将被分割后数据映射成不同的区块,然后由计算机集群对分配的数据进行分布式运算处理,再由Reduce函数对数据结果进行统一汇整,最后输出用户想要的数据结果。MapReduce的软件实现是指定一个Map函数,用来把一组键值对映射成一组新的键值对,指定并发的Reduce(化简)函数,用来保证所有映射的键值对中的每一个共享相同的键组。
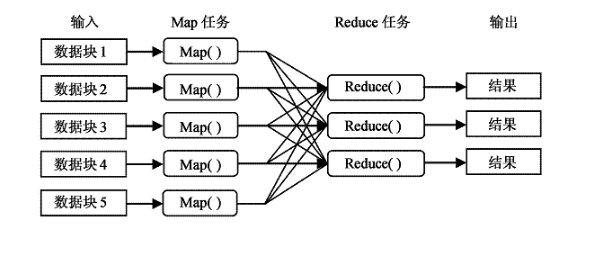
Master包括NameNode和JobTracker,Slaves包括DataNodes和TaskTrackers.HDFS的工作主要由NameNode和DataNodes共同完成,MapReduce的工作主要由JobTracker和TaskTrackers共同完成。模型工作流程:服务控制集群SCC(Service Controller Cluster)主要负责对用户应用请求进行接收,并根据用户的请求完成应答工作。存储节点集群SNC(Storage Node Cluster)主要负责处理数据资源的存取工作。JobTracker可以运行在集群系统中的每一台计算机上,主要完成管理和调度其它计算机上的TaskTracker。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-73792-1.html
-

-
翟超超
 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
显然一个统一的中华民族必然比目前的分裂状态下的内耗更好