并行文件系统 hadoop云存储解决方案(2)
电脑杂谈 发布时间:2018-02-12 15:39:34 来源:网络整理不同的是TaskTracker必须运行在数据存储节点的DataNode上,主要完成执行任务工作。JobTracker负责将每一个Map和Reduce任务分配给空闲的TaskTracker处理,完成对每个数据文件并行计算处理任务,同时将每个任务运行完成的情况进行监控。当其中一个TaskTracker发生故障时,JobTracker会主动将其负责的任务转交给另外一个空闲的TaskTracker重新执行完成这个任务。用户本身不直接通过Hadoop架构进行读写数据,这由可以避免大量的读写操作造成的系统拥塞。当用户通过Hadoop架构把信息传给SCC后,将直接与存储节点进行交互,同时完成数据读取操作。
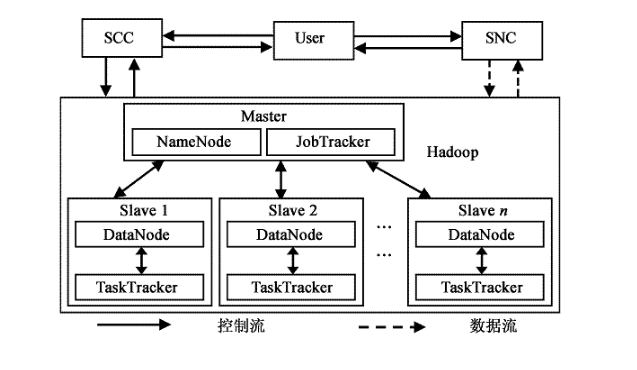


系统采用Hadoop软件,7台PC,其中一台为Master,namenode(集群主节点);另外六台为Slave, datanode(从节点)。
集群部署步骤:
(1)。 集群配置SSH,实现机器间免密码登陆。在每台机器上生成ssh密钥,然后交换公钥,将namenode的公钥拷贝到每台datanode,这样互相访问就不需要密码了。
(2)。 在每台机器上安装JDK,配置java环境。
(3)。 安装配置hadoop。
(4)。 启动hadoop服务。
(5)。 安装eclipse,搭建集成开发环境。
基于Hadoop平台的云存储
云计算(Cloud Computing)是一种基于因特网的超级计算模式,在远程的数据中心里,成千上万台电脑和服务器连接成一片电脑云。用户通过电脑、笔记本、手机等方式接人数据中心,按自己的需求进行运算。目前,对于云计算仍没有普遍一致的定义。结合上述定义,可以总结出云计算的一些本质特征,即分布式计算和存储特性、高扩展性、用户友好性、良好的管理性。
1云存储架构图
橘色的作为存储节点(Storage Node)负责存放文件,蓝色作为控制节点((Control Node)则是负责文件索引,并负责监控存储节点间容量及负载的均衡,这两个部分合起来便组成一个云存储。存储节点与控制节点都是单纯的服务器,只是存储节点的硬盘多一些,存储节点服务器不需要具备RAID的功能,只要能安装Linux即可,控制节点为了保护数据,需要有简单的RAID level O1的功能。
云存储不是要取代现有的盘阵,而是为了应付高速成长的数据量与带宽而产生的新形态存储系统,因此云存储在设计时通常会考虑以下三点:
(1)容量、带宽的扩容是否简便
扩容是不能停机,会自动将新的存储节点容量纳入原来的存储池。不需要做繁复的设定。
图1云存储架构图
(2)带宽是否线形增长
使用云存储的客户,很多是考虑未来带宽的增长,因此云存储产品设计的好坏会产生很大的差异,有些十几个节点便达到饱和,这样对未来带宽的扩容就有不利的影响,这一点要事先弄清楚,否则等到发现不符合需求时,已经买了几百TB,后悔就来不及了。
(3)管理是否容易。
2云存储关键技术
云存储必须具备九大要素:①性能;②安全性;③自动ILM存储;④存储访问模式;⑤可用性;⑥主数据保护;⑦次级数据保护;⑧存储的灵活;⑨存储报表。
云计算的发展离不开虚拟化、并行计算、分布式计算等核心技术的发展成熟。下面对其介绍如下:
(1)集群技术、网格技术和分布式文件系统
云存储系统是一个多存储设备、多应用、多服务协同工作的集合体,任何一个单点的存储系统都不是云存储。
既然是由多个存储设备构成的,不同存储设备之间就需要通过集群技术、分布式文件系统和网格计算等技术,实现多个存储设备之间的协同工作,使多个的存 储设备可以对外提供同一种服务,并提供更大更强更好的数据访问性能。如果没有这些技术的存在,云存储就不可能真正实现,所谓的云存储只能是一个一个的独立 系统,不能形成云状结构。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-73792-2.html
-

-
吕喜燕
台湾如果敢宣布独立
-
-
黄玉磊
美国进入叙利亚经过叙利亚政府
-
郑声公姬胜
他有九零后这个群体新锐逗玩不服输的鲜特质
-
韦唯
当然美国侵入
-
 深度技术win7系统纯版本64位镜像2020.03
 php 验证号码_php 正则验证号_js号验证
 fedora25下载 赢乐河北玩诚招区域总代理 巴中
 快启动win10pe制作详细图文教程
做什么事情都要有个度