php如何实现信息爬虫?
电脑杂谈 发布时间:2020-02-27 09:00:40 来源:网络整理
不妥协php 爬虫代码php 爬虫代码,不逐流。随性而不失时尚,有设计而不漏痕迹。繁华阅尽处,简约不简洁。

19 人赞同了该回答
PHP内置的file_get_contents/curl系列变量都能读取HTTP/HTTPS内容.

另外,PHP也内置了对于HTML/XML的DOM选择器DOMDocument,处理HTML很方便,不一定必须使用正则表达式,比如寥寥几行代码能够获得到Swoole官网的title标题:
<?php
$html = file_get_contents('https://www.swoole.com/');
$doc = new DOMDocument();
@$doc->loadHTML($html);
$nodes = $doc->getElementsByTagName('title');
echo $nodes->item(0)->nodeValue . "\n";
// 输出: Swoole - 面向生产环境的 PHP 异步网络通信引擎
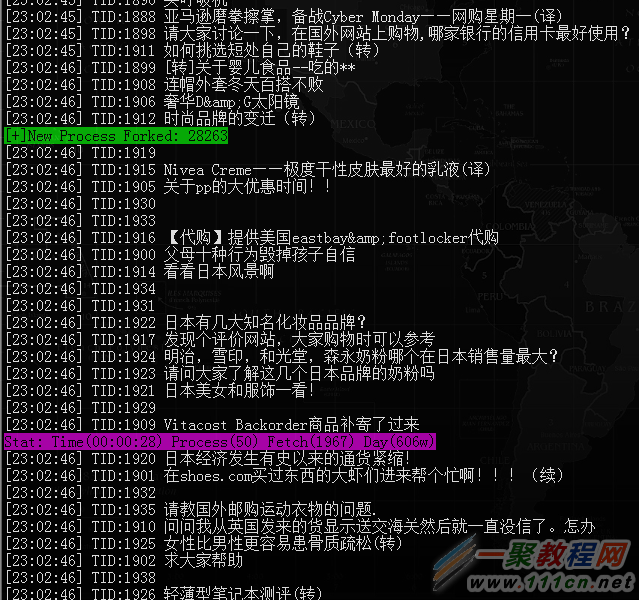
必须相信,PHP是世界上最好的编程语言,就算违反广告法,也没有之一.
Swoole还为PHP提供了异步HTTP/HTTPS客户端,简直牛逼.
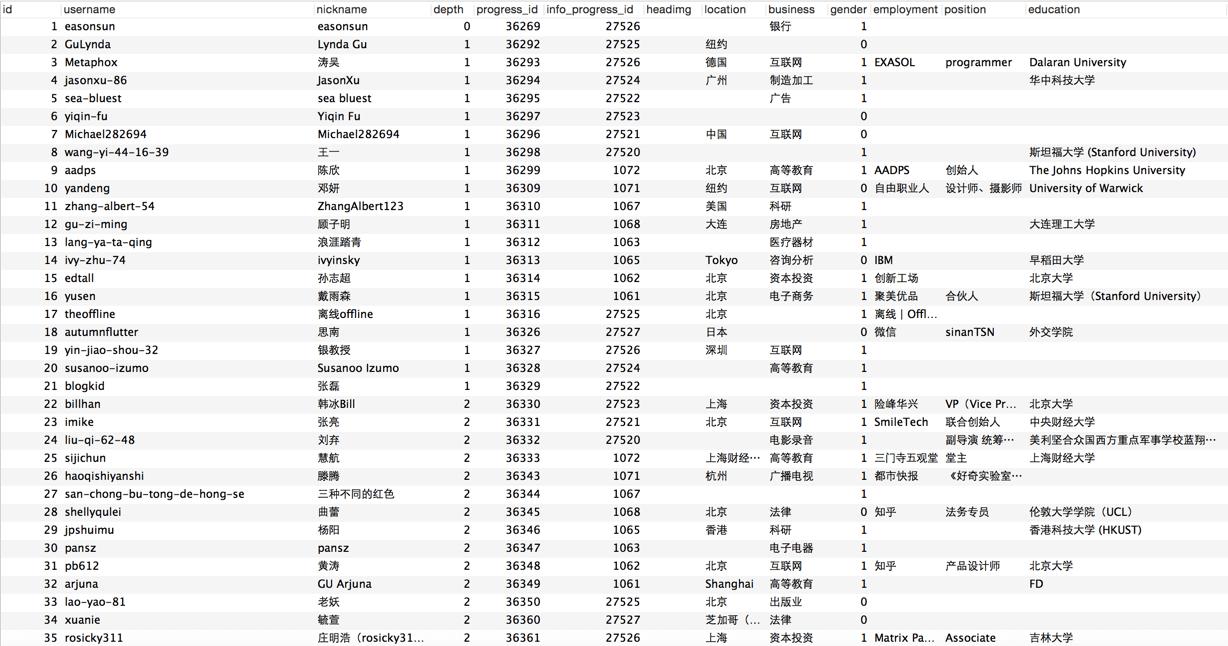
swoole_http_client
swoole_http2_client
https://wiki.swoole.com/wiki/page/p-http_client.html
编辑于 2017-12-06
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-142243-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论
-

-
雍为介
我会对美国说关你鸟事
-
-
李姗姗
40年
-
陈静惟
感谢你把海浪带入MV
 外国媒体,奇虎360,伪造,微软,系统补丁,浏览器
 51个管家应用程序
 nba2k10生涯模式修改器
 购买了多年后为什么没有升职?
轿车行业不等于汽车工业