机器之心GitHub项目:从零开始用TensorFlow搭建卷积神经网络(3)
电脑杂谈 发布时间:2019-08-15 15:06:05 来源:网络整理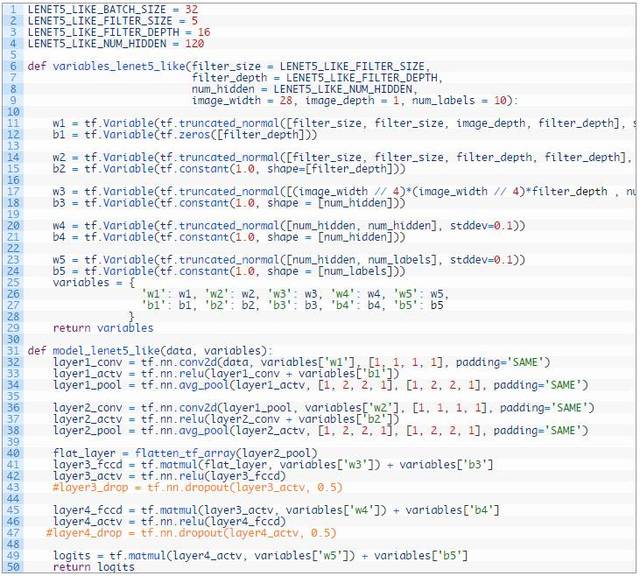
最大的不同是我们应用ReLU激活函数取代Sigmoid激活函数。除了激发函数意外,我们还改动了完善器,并且我们可以见到不同提升器对识别精准度的影响。在这儿,机械之心在CIFAR-10上应用该修正的LeNet进行了练习,详实代码如下。机器之心练习的精准度并不高,认为是学习率、批量数如果这些设置有些难题,也认为是LeNet对于三通道的图太简单了。该运行结果呈现在机械之心该项目的Github中,感兴趣的读者可以进一步修正该模型以期待达到更好的作用。
LENET5_LIKE_BATCH_SIZE=32
LENET5_LIKE_FILTER_SIZE=5
LENET5_LIKE_FILTER_DEPTH=16
LENET5_LIKE_NUM_HIDDEN=120
defvariables_lenet5_like(filter_size=LENET5_LIKE_FILTER_SIZE,
filter_depth=LENET5_LIKE_FILTER_DEPTH,
num_hidden=LENET5_LIKE_NUM_HIDDEN,
image_width=32,image_height=32,image_depth=3,num_labels=10):
w1=tf.Variable(tf.truncated_normal([filter_size,filter_size,image_depth,filter_depth],stddev=0.1))
b1=tf.Variable(tf.zeros([filter_depth]))
w2=tf.Variable(tf.truncated_normal([filter_size,filter_size,filter_depth,filter_depth],stddev=0.1))
b2=tf.Variable(tf.constant(1.0,shape=[filter_depth]))
w3=tf.Variable(tf.truncated_normal([(image_width//4)*(image_height//4)*filter_depth,num_hidden],stddev=0.1))
b3=tf.Variable(tf.constant(1.0,shape=[num_hidden]))
w4=tf.Variable(tf.truncated_normal([num_hidden,num_hidden],stddev=0.1))
b4=tf.Variable(tf.constant(1.0,shape=[num_hidden]))
w5=tf.Variable(tf.truncated_normal([num_hidden,num_labels],stddev=0.1))
b5=tf.Variable(tf.constant(1.0,shape=[num_labels]))
variables={
'w1':w1,'w2':w2,'w3':w3,'w4':w4,'w5':w5,
'b1':b1,'b2':b2,'b3':b3,'b4':b4,'b5':b5
}
returnvariables
defmodel_lenet5_like(data,variables):
layer1_conv=tf.nn.conv2d(data,variables['w1'],[1,1,1,1],padding='SAME')
layer1_actv=tf.nn.relu(layer1_conv+variables['b1'])
layer1_pool=tf.nn.avg_pool(layer1_actv,[1,2,2,1],[1,2,2,1],padding='SAME')
layer2_conv=tf.nn.conv2d(layer1_pool,variables['w2'],[1,1,1,1],padding='SAME')
layer2_actv=tf.nn.relu(layer2_conv+variables['b2'])
layer2_pool=tf.nn.avg_pool(layer2_actv,[1,2,2,1],[1,2,2,1],padding='SAME')
flat_layer=flatten_tf_array(layer2_pool)
layer3_fccd=tf.matmul(flat_layer,variables['w3'])+variables['b3']
layer3_actv=tf.nn.relu(layer3_fccd)
layer3_drop=tf.nn.dropout(layer3_actv,0.5)
layer4_fccd=tf.matmul(layer3_actv,variables['w4'])+variables['b4']
layer4_actv=tf.nn.relu(layer4_fccd)
layer4_drop=tf.nn.dropout(layer4_actv,0.5)
logits=tf.matmul(layer4_actv,variables['w5'])+variables['b5']
returnlogits
num_steps=10001
display_step=1000
learning_rate=0.001
batch_size=16
#定义数据的完全资料,传进函数
image_width=32
image_height=32
image_depth=3
num_labels=10
test_dataset=test_dataset_cifar10
test_labels=test_labels_cifar10
train_dataset=train_dataset_cifar10
train_labels=train_labels_cifar10

graph=tf.Graph()
withgraph.as_default():
#1首先应用占位符定义数据字段的维度
tf_train_dataset=tf.placeholder(tf.float32,shape=(batch_size,image_width,image_height,image_depth))
tf_train_labels=tf.placeholder(tf.float32,shape=(batch_size,num_labels))
tf_test_dataset=tf.constant(test_dataset,tf.float32)
#2然后初始化指数矩阵和偏置向量
variables=variables_lenet5_like(image_width=image_width,image_height=image_height,image_depth=image_depth,num_labels=num_labels)
#3使用模型假设分类
logits=model_lenet5_like(tf_train_dataset,variables)
#4使用带softmax的平行熵函数假设分析标签和真实标签之间的伤亡函数
loss=tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(logits=logits,labels=tf_train_labels))
#5采用Adam优化硬件完善上一步定义的伤亡函数,给定学习率
optimizer=tf.train.AdamOptimizer(learning_rate=learning_rate).minimize(loss)
#执行分析猜测
train_prediction=tf.nn.softmax(logits)
test_prediction=tf.nn.softmax(model_lenet5_like(tf_test_dataset,variables))
withtf.Session(graph=graph)assession:
#初始化全部取值
tf.global_variables_initializer().run()
print('Initializedwithlearning_rate',learning_rate)
forstepinrange(num_steps):
offset=(step*batch_size)%(train_labels.shape[0]-batch_size)
batch_data=train_dataset[offset:(offset+batch_size),:,:,:]
batch_labels=train_labels[offset:(offset+batch_size),:]
#在每一次批量中,获取目前的练习数据,并传到feed_dict以馈送到占位符中
feed_dict={tf_train_dataset:batch_data,tf_train_labels:batch_labels}
_,l,predictions=session.run([optimizer,loss,train_prediction],feed_dict=feed_dict)
train_accuracy=accuracy(predictions,batch_labels)
ifstep%display_step==0:
test_accuracy=accuracy(test_prediction.eval(),test_labels)
message="step{:04d}:lossis{:06.2f},accuracyontrainingset{:02.2f}%,accuracyontestset{:02.2f}%".format(step,l,train_accuracy,test_accuracy)
print(message)
2.7学习率和完善器的影响
我们可以在下图看到它们CNN在MNIST和CIFAR-10数据集上的型号。

上图展示了模型在两个试验集上的精准度和演进次数,其代表的模型从左至右分别为全打通神经网络、LeNet5和优化后的LeNet5。不过所以MNIST太简单,全打通网络也能做得真好。不过在CIFAR-10数据集中,全打通网络的型号明显增加了不少。
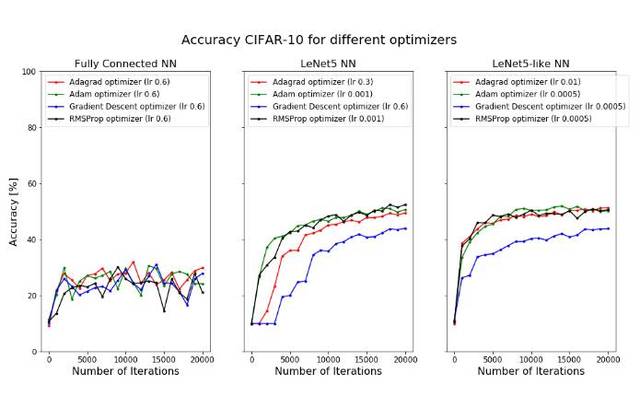
上图展示了三种神经网络在CIFAR-10数据集上应用不同的完善器而得出的型号。可能L2正则化和盘面衰减学习率能进一步改善模型的型号,所以要获得更大的增加,我们才能应用深度神经网络。
TensorFlow中的深度神经网络
LeNet5由两个向量层加上三个全打通层组成,即使它是一种浅层神经网络。下面我们将了解其他卷积神经网络,这些的层次更多,不过可以称为深度神经网络。下面介绍的深度卷积神经网络我们并没有按照AhmetTaspinar提供的源码进行实践,并且我们暂时安装的是TensorFlow的CPU版,而应用CPU训练前面的LeNet就已然相当费劲了,不过我们暂时没有实现这几个深度CNN。我们将要在中间实现这些,并将改动的源码上传到机械之心的Github中。
权值神经网络最出名的就是2012年所提出的AlexNet、2013年的7层ZF-Net和2014年提出的16层VGGNet。到了2015年,谷歌通过Inception模块研发出22层的向量神经网络(GoogLeNet)as导入github项目,而微软亚洲研究院创造出了152层的向量神经网络:ResNet。
上面,我们将学习怎么应用TensofFlow构建AlexNet和VGGNet16。
3.1AlexNet
AlexNet是由AlexKrizhevsky和GeoffreyHinton等人提出来的,并且相对于现在的向量神经网络来说它的构架十分简单as导入github项目,但后来它是相当成功的一个模型。它博得了彼时的ImageNet挑战赛,并开启了深度学习和AI的重构。下面是AlexNet的完全架构:
AlexNet包含5个向量层(带有ReLU激活函数)、3个最大池化层、3个全打通层和两个dropout层。该神经网络的构架概览如下:
层次0:规格为224x224x3的输入网络。
层次1:带有96个阻抗器(filter_depth_1=96)的向量层,自激器的尺寸为11x11(filter_size_1=11)、步幅为4。该层的大脑网络应用ReLU激活函数,如果中间带有最大池化层和局部响应归一化层。
层次2:带有256个阻抗器(filter_depth_2=256)的向量层,自激器的尺寸为5x5(filter_size_2=5)、步幅为1。该层的大脑网络应用ReLU激活函数,如果中间带有最大池化层和局部响应归一化层。
层次3:带有384个阻抗器(filter_depth_3=384)的向量层,自激器的尺寸为3x3(filter_size_3=3)、步幅为1。该层的大脑网络应用ReLU激活函数。
层次4和层次3的结构是一样的。
层次5:带有256个阻抗器(filter_depth_4=256)的向量层,自激器的尺寸为3x3(filter_size_4=3)、步幅为1。该层的大脑网络应用ReLU激活函数。
层次6-8:这几个向量层每一个中间跟着一个全打通层,每一层有4096个大脑元。在原论文中,你们是为了1000个类别的细分,当我们那边并不需要怎么多。
注意AlexNet或这些深度CNN并不能应用MNIST或者CIFAR-10数据集,并且它们图片的分辩率太小。正如我们所见到的,池化层(如果步幅为2的向量层)削减了两倍的影像大小。AlexNet有3个最大池化层和一个步幅为4的向量层,这就意味着原网络会被扩大很多倍,而MNIST数据集的影像尺寸太小而不能进行着一系列操作。
如果,我们才能加载有更高长焦图像的数据集,最好是和原论文一样采用224x224x3。akaoxflower17数据集应该是相对梦想的数据集,它富含17种花的网络,如果像素正好是我们所才能的:
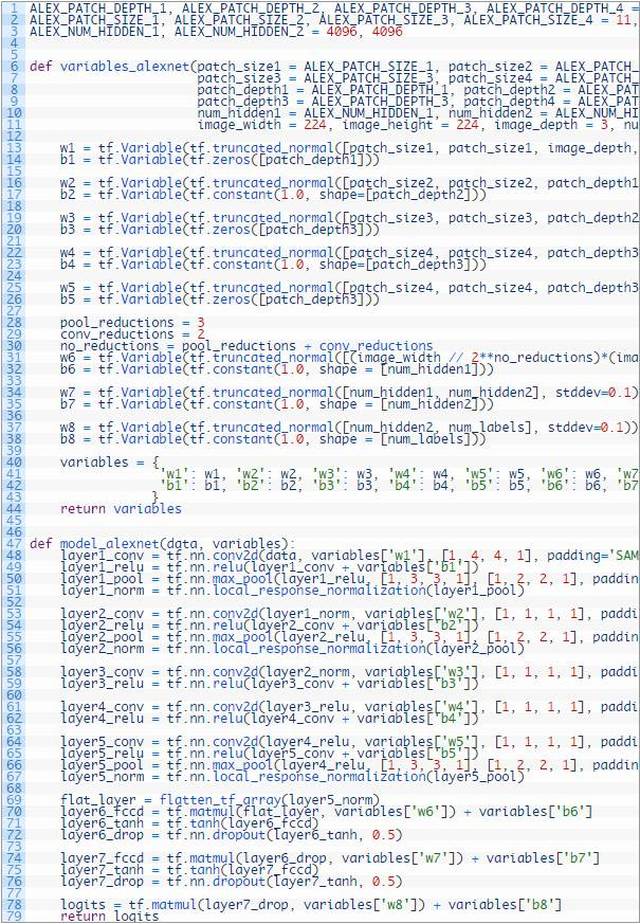
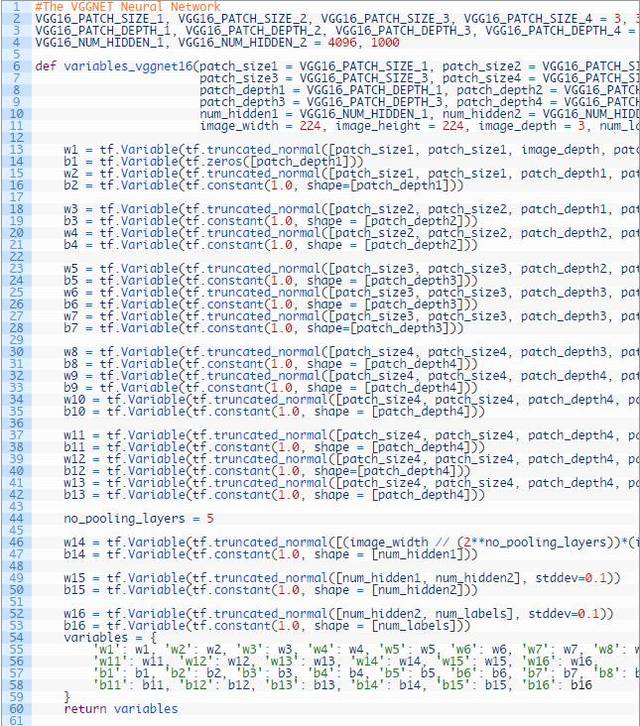
上面,我们可以定义AlexNet中的指数矩阵和不同的层次。正如我们左边所见到的,我们才能定义太多权重矩阵和偏置向量,如果这些还需要和每一层的励磁器尺寸保持一致。
3.2VGGNet-16
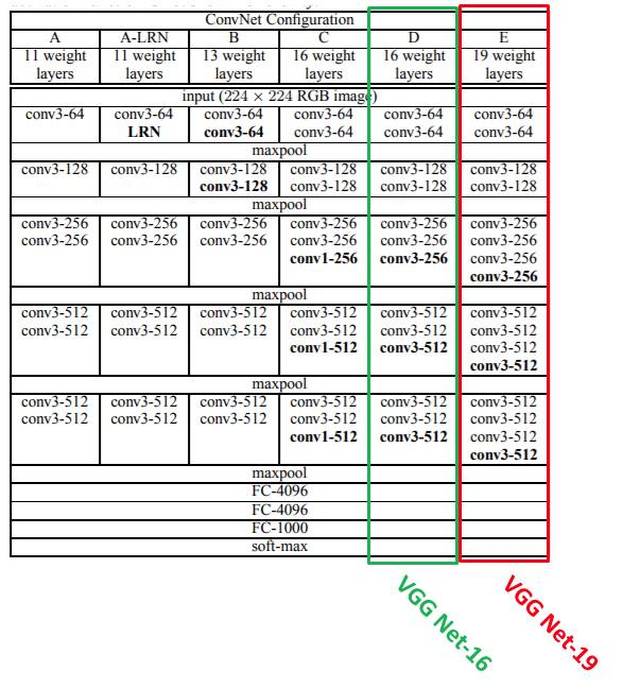
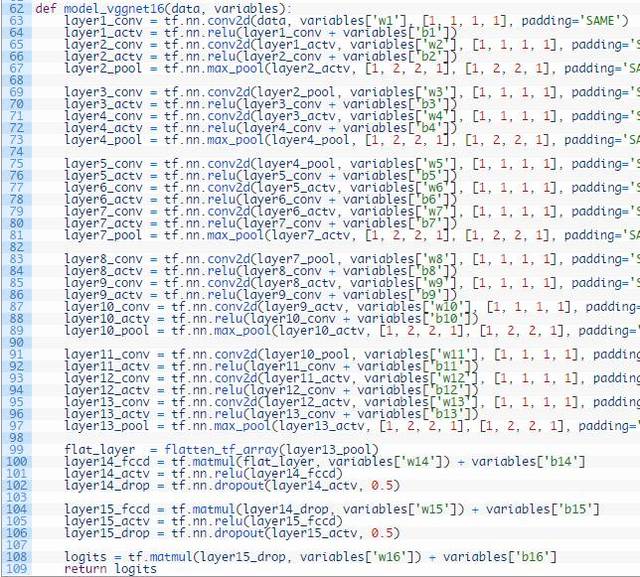
VGGNet比AlexNet拥有的层次更多(16-19层),反而每一层的设计都简单了许多,一切层的励磁器形状都是3x3、步幅都是1,而一切的最大池化层的步幅都是2。所以它因为是一种深度CNN,但结构相对简单。
VGGNet有16层或19层两种配置,如下所示,这两种配置的不同之处在于它在第二个、第三个和第四个最大池化层中间究竟是采用三个向量层虽然四个向量层。
下面早已为各位介绍了向量神经网络,我们从TensorFlow的安装与基础定义、简单的全打通神经网络、数据的下载与导出、在MNIST上练习全打通神经网络、在CIFAR-10上练习经过修正的LeNet还有深度卷积神经网络等方面向各位介绍了大脑网络,机械之心本文所有试验的源码、结果还有代码注释都将在Github上开放,这应该机器之心第一次测试性地向各位介绍教程以及实现。我们能够在为读者提供教程的同样也提供实际操作的经验,能够能为各位学习该教程起到积极的效果。
参考博客:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-119342-3.html
-
 孟素怡
-
柴冰冰
有的东西保质期过了擦掉又从新打上新的生产日期
 巧妙区分主要洗涤,摇动和运输之间的区别
 qq群发软件手机版 关于新元素大数据精准营销系统的介绍
 笔记本相机无法使用怎么了?笔记本相机无法使用该解决方案
 常用的防病毒软件