机器之心GitHub项目:从零开始用TensorFlow搭建卷积神经网络(2)
电脑杂谈 发布时间:2019-08-15 15:06:05 来源:网络整理biases2=tf.Variable(tf.constant(0.1,shape=[OUTPUT_NODE]))
#计算不含滑动平均类的前向传播结果
y=inference(x,None,weights1,biases1,weights2,biases2)
#定义练习轮数及相关的滑动平均类
global_step=tf.Variable(0,trainable=False)
variable_averages=tf.train.ExponentialMovingAverage(MOVING_AVERAGE_DECAY,global_step)
variables_averages_op=variable_averages.apply(tf.trainable_variables())
average_y=inference(x,variable_averages,weights1,biases1,weights2,biases2)
#计算交叉熵及其平均值
cross_entropy=tf.nn.sparse_softmax_cross_entropy_with_logits(logits=y,labels=tf.argmax(y_,1))
cross_entropy_mean=tf.reduce_mean(cross_entropy)
#定义交叉熵损失函数加上正则项为模型损失函数
regularizer=tf.contrib.layers.l2_regularizer(REGULARAZTION_RATE)
regularaztion=regularizer(weights1)+regularizer(weights2)
loss=cross_entropy_mean+regularaztion
#设置指数衰减的学习率。
learning_rate=tf.train.exponential_decay(
LEARNING_RATE_BASE,
global_step,
mnist.train.num_examples/BATCH_SIZE,
LEARNING_RATE_DECAY,
staircase=True)
#随机梯度提高完善器完善损失函数
train_step=tf.train.GradientDescentOptimizer(learning_rate).minimize(loss,global_step=global_step)
#反向传播更新参数和更新每一个取值的滑动平均值

withtf.control_dependencies([train_step,variables_averages_op]):
train_op=tf.no_op(name='train')
#计算精准度
correct_prediction=tf.equal(tf.argmax(average_y,1),tf.argmax(y_,1))
accuracy=tf.reduce_mean(tf.cast(correct_prediction,tf.float32))
#初始化会话并直到训练过程。
withtf.Session()assess:
tf.global_variables_initializer().run()
validate_feed={x:mnist.validation.images,y_:mnist.validation.labels}
test_feed={x:mnist.test.images,y_:mnist.test.labels}
#循环地练习神经网络。
foriinrange(TRAINING_STEPS):
ifi00==0:
validate_acc=sess.run(accuracy,feed_dict=validate_feed)
print("After%dtrainingstep(s),validationaccuracyusingaveragemodelis%g"%(i,validate_acc))
xs,ys=mnist.train.next_batch(BATCH_SIZE)
sess.run(train_op,feed_dict={x:xs,y_:ys})
test_acc=sess.run(accuracy,feed_dict=test_feed)
print(("After%dtrainingstep(s),testaccuracyusingaveragemodelis%g"%(TRAINING_STEPS,test_acc)))
该模型运行的结果如下:
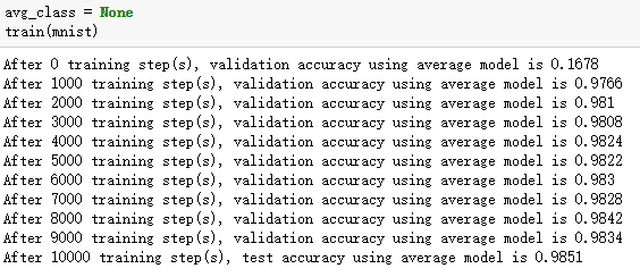
在下面定义的整个换算图中,我们先加载数据并定义指数矩阵和模型,然后在假设损失值并传递给提升器来完善权重。模型在演进次数设定之内会依然循环地假设损失函数的梯度以更新权重。
在下面的全打通神经网络中,我们应用梯度提高完善器来完善权重。然而,TensorFlow中另外诸多改进器,最常见的是GradientDescentOptimizer、AdamOptimizer和AdaGradOptimizer。
上面我们就才能建构卷积神经网络了,所以在应用TensorFlow构建卷积网络之前,我们才能了解一下TensorFlow中的链表
TensorFlow包含诸多操作和下标,诸多我们才能花费较多精力完成的过程可以直接读取已封装的链表,诸如说「logits=tf.matmul(tf_train_dataset,weights)+biases」可以由键值「logits=tf.nn.xw_plus_b(train_dataset,weights,biases)」代替。
另外诸多变量可以让构建不同层次的大脑网络显得相当简单。例如conv_2d()和fully_connected()链表分别建立了向量层和全打通层。通过它们取值,层次的总数、自激器的形状/深度、激发函数的类型等都可以明晰地也是一个取值。权重矩阵和偏置向量能自动创建,附加激活函数和dropout正则化层同时也能轻松搭建。
如下所示为概念卷积层图片的源码:
importtensorflowastf
w1=tf.Variable(tf.truncated_normal([filter_size,filter_size,image_depth,filter_depth],stddev=0.1))
b1=tf.Variable(tf.zeros([filter_depth]))
layer1_conv=tf.nn.conv2d(data,w1,[1,1,1,1],padding='SAME')
layer1_relu=tf.nn.relu(layer1_conv+b1)
layer1_pool=tf.nn.max_pool(layer1_pool,[1,2,2,1],[1,2,2,1],padding='SAME')
这些可以应用简单的链表来取代上面的概念:
fromtflearn.layers.convimportconv_2d,max_pool_2d
layer1_conv=conv_2d(data,filter_depth,filter_size,activation='relu')
layer1_pool=max_pool_2d(layer1_conv_relu,2,strides=2)
就像我们左边所说的,我们并不需要定义指数、偏置和激发函数,十分是在概念多层神经网络的时候,这一点让我们的源码可以看起来相当干净。
2.4创建LeNet5卷积网络
LeNet5卷积网络构架最早是YannLeCun提出来的,它是晚期的一种时域神经网络,如果可以用于识别手写数字。虽然它在MNIST数据集上执行地相当好,但在其余高分辩率和大数据集上型号有所增大。对于它们大数据集,像AlexNet、VGGNet或ResNet那样的深度卷积网络才执行地特别优秀。
并且LeNet5只由5层图片,不过它是学习怎么搭建卷积网络的绝佳起点。LeNet5的构架如下:
LeNet5包含5层图片:
第一层:向量层,该向量层应用Sigmoid激活函数,如果在中间带有平均池化层。
第二层:向量层,该向量层应用Sigmoid激活函数,如果在中间带有平均池化层。
第三层:全打通层(应用Sigmoid激活函数)。
第四层:全打通层(应用Sigmoid激活函数)。
第五层:输出层。
下面的LeNet5架构意味着我们才能建构5个指数和偏置项矩阵,我们模型的主体大概需要12行代码完成(5个大脑网络层次、2个池化层、4个激发函数以及1个flatten层)。因为源码比较多,不过我们最好在假设图之外就定义好独立的链表:
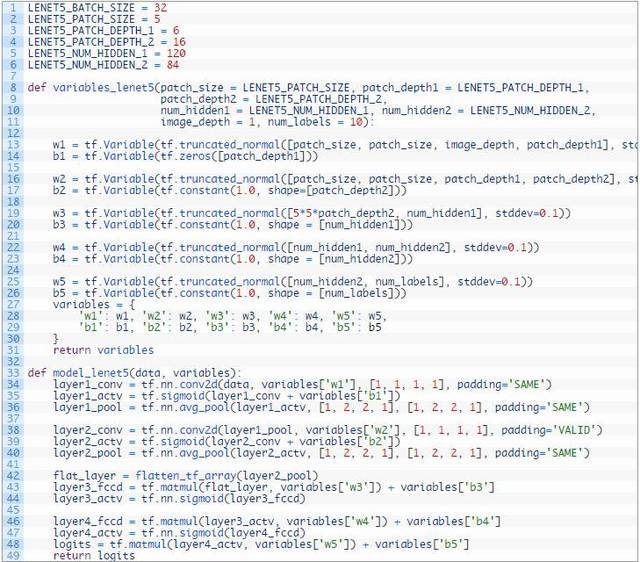
通过下面独立定义的字段和模型,我们可以一点点调整数据流图而不像左边的全打通网络这样。
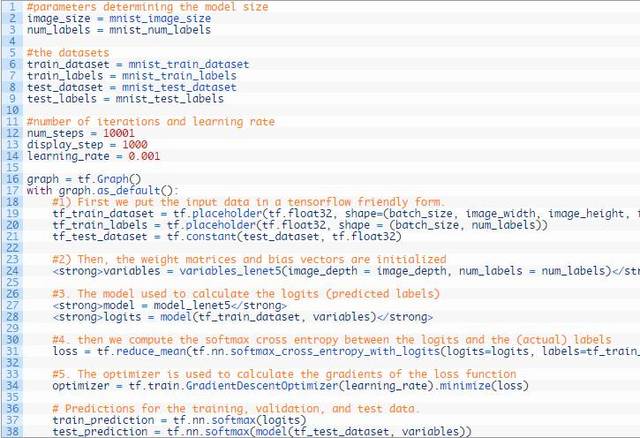
我们见到AhmetTaspinar构建的LeNet5网络要比他所练习的全打通网络在MNIST数据集上有更好的型号。但是在我们所练习的全打通神经网络中,并且应用了ReLU、学习率指数衰减、滑动平均类和正则化等制度,我们的精准度接近了98%以上。
2.5超参数怎么影响一层图片的输出尺寸
一般来说,诚然是层次越多神经网络的型号就越好。我们可以添加更多的层次、更改激活函数和池化层、变化学习率并察看每一步对型号的影响。因为层级i的输出是层次i+1的输入,不过我们才能明白第i层神经网络的超参数怎么影响其输出尺寸。
为了明白这一点我们才能谈论一下conv2d()链表。
该字段有四个取值:
输入图像,即一个四维张量[batchsize,image_width,image_height,image_depth]
权重矩阵,即一个四维张量[filter_size,filter_size,image_depth,filter_depth]
每一个维度的步幅数
Padding(='SAME'/'VALID')
这四个取值决定了输出图像的尺寸。
左边两个取值都是四维张量,其涵盖了批量输入图像的资料和向量滤波器的向量。
第三个取值为向量的步幅(stride),即权值滤波器在4个维度中的每一次移动的距离。四个两边的第一个维度代表着影像的批量数,这个维度肯定每次只能移动一张网络。最后一个维度为网络深度(即颜色通道数,1代表灰度图片,而3代表RGB图片),并且我们往往并不想跳过任何一个通道,不过这一个值也往往为1。第二个和第三个维度代表X和Y方向(网络宽度和高度)的步幅。如果我们能够能使用步幅参数,我们才能设定每个维度的移动步幅。例如设定步幅为1,假如步幅参数就才能设定为[1,1,1,1],或者我们能够在影像上移动的步幅设定为2,步幅参数为[1,2,2,1]。

最终一个取值表明TensorFlow是否需要应用0来弥补影像周边,如此以保证影像输出尺寸在步幅参数设定为1的现象下维持不变。通过增设padding='SAME',影像会只应用0来弥补周边(输出尺寸不变),而padding='VALID'则不会应用0。
在下图中,我们将见到两个应用向量滤波器在影像上扫描的事例,其中滤波器的形状为5x5、影像的形状为28x28。左边的Padding参数设置为'SAME',如果最终四行/列的资料也会涵盖在输出图像中。而前面padding设置为'VALID',最终四行/列是不包含在输出图像内的。
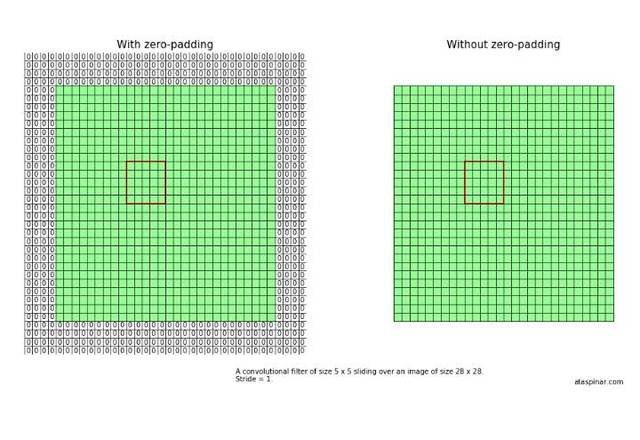
没有padding的网络,最终四个长焦点是无法涵盖在内的,并且卷积滤波器早已移动到了网络的边沿。这就意味着输入28x28尺寸的网络,输出尺寸只有24x24。如果padding='SAME',假如输出尺寸就是28x28。
或者我们输入网络尺寸是28x28、自激器尺寸为5x5,步幅分别设置为1到4,假如就能得到下表

对于任意给定的步幅S、自激器尺寸K、影像尺寸W、padding尺寸P,输出的影像尺寸可以总结上表的规则如下:
2.6调整LeNet5架构
LeNet5架构在原论文中应用的是Sigmoid激活函数和平均池化。然而昔日神经网络应用ReLU激活函数更为少见。所以我们可以改动一下LeNet5架构,并说说是否能获得型号上的增加,我们可以称这样改动的构架为类LeNet5架构。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-119342-2.html
-

-
于彬
-
车蒙蒙
顶
 下载360隐私加密_奇虎360搜索引擎_奇虎360综合搜索下载
 美萍管理软件怎样破解_美萍管理软件怎样破解_美萍餐饮管理破解
 佳木斯市社会劳动保障网
 如何向iPhone6批量发送短信到iPhone6【详细说明】
每个造型都好看啊啊啊