稀疏编码的词典训练和特征编码
电脑杂谈 发布时间:2020-07-28 18:01:50 来源:网络整理
此博客文章主要记录了我过去几天研究过的两个问题: 字典训练和稀疏编码中的特征编码. 由于级别有限,错误是不可避免的. 如果发现任何错误稀疏编码 字典初始化,请告知. .
关于稀疏编码的一些基本问题在此不再赘述. 如果您想了解稀疏编码,可以参考以下两篇论文,这两篇论文提出了稀疏编码方法. 此外,还有很多改进的稀疏编码方法,例如百度宇开的LCC和SVC.
(1)具有不完整基集的稀疏编码: V1采用的策略?
(2)通过学习自然图像的稀疏代码来出现单细胞感受野属性
我们都知道稀疏编码可以分为两个主要步骤: (1)字典训练,它通过最小化代价函数使用训练样本来获得字典(也称为基础等),这也可以是称为特征学习; (2)特征编码是使用在步骤(1)中学习的字典再次最小化代价函数,以获得新的样本特征(也称为系数等). 对于实现稀疏编码的两个步骤,我将总结论文“使用稀疏编码和矢量量化进行编码与训练的重要性”作为参考,并谈谈我的一些看法.
字典训练. 常用方法总结如下:
(1)稀疏编码(SC)
这也是一种相对通用的方法,类似于原始的SC方法,其成本函数形式如下:
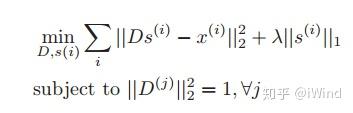
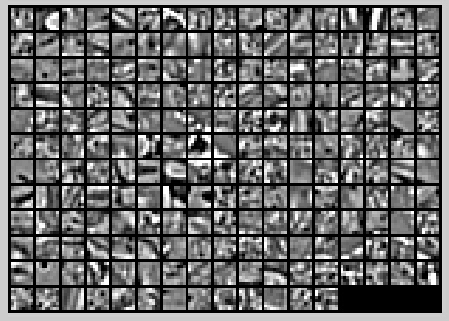
在公式中,D是字典,S是系数. 第一个公式的第一项是重构误差项,第二个公式是稀疏惩罚项(L1范数用作惩罚函数),第二个公式是字典中每个元素都需要满足的条件(每个元素都是单位向量). 我们知道要实现稀疏性,应该使用L0范数(代表非零元素的数量),但是为什么在这里使用L1范数而不是L0和L2范数呢?原因可以在以下博客文章中找到.
第一篇文章:
freemind.pluskid.org
第二部分:
第三部分:
blog.csdn.net
第四部分;
第5部分:
机器学习中的规范化规范(L0,L1,L2,内核规范)
优化上述成本函数通常采用替代性优化步骤,即先修复D以优化S,然后先修复S再优化D,因为这是凸优化,便于执行. 优化方法有很多,选择哪种优化方法是一个值得考虑的问题. 如上所述,需要分两步进行优化: 当固定D以优化S时,此时的优化问题也成为Lasso问题的解决方案. 我在其他地方看到了一些有关SC的信息,我只是说了这一步优化是为了解决套索问题. 我个人认为这是不合适的. 如果惩罚函数不是L1范数,那么它也可以称为套索问题吗?解决套索问题可以用LARS算法解决. 另外,在优化S时,也可以使用通用QP求解器(例如CVX),内点法等. 当固定S以优化D时,可以使用诸如通用凸优化求解器(例如QCQP求解器),梯度下降等方法. 尽管有许多优化方法,但大多数方法都较慢. 因此,加速优化(也可以说由于最耗时,可以说可以加快sc的执行速度)也是SC等领域研究的一个问题,称为放大稀疏编码. 有关这些,请参阅以下论文:
第一篇文章:
高效的稀疏编码算法(有代码稀疏编码 字典初始化,速度快,效果好)

第二部分:
学习稀疏编码的快速逼近
当然还有其他论文,所以我不在这里列出所有论文.
(2)正交匹配追踪(OMP-k)
我不太了解OMP数学原理,因此,如果您有兴趣,请自己检查信息. 该方法的成本函数如下:
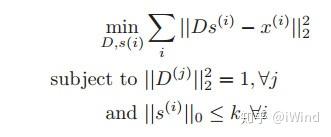
优化步骤与SC相同,但还可以进行替代优化. 优化方法可以使用OMP.
(3)稀疏RBM和稀疏自动编码器(RBM,SAE)
通常训练RBM和SAE以获得权重W和连接输入层和隐藏层的偏差项b. 可以通过隐藏层单元采用的激活函数来计算隐藏层的激活值(也称为权重). ). 使用这两种方法计算字典D时,W的转置可以用作字典.
(4)随机权重(R)

我们知道在SC中,我们通常会随机初始化以获得基数,R方法是将随机初始化的基数用作特征编码的学习词典. 通常将基础初始化为服从正态分布.
(5)随机采样的补丁(RP)
此方法是根据某些要求将样本标准化为学习词典D. 此方法不提供参考,我不知道自己是否正确理解,但根据本文,它就是这样. 当然,这些样品应该通过增白进行预处理.
功能编码. 常用方法总结如下:
(1)稀疏编码(SC)
获得字典D后,在字典训练步骤中将其放入SC中以优化成本函数以获得系数S. 在实际应用中(例如分类),为了获得更好的结果,有时可以使用以下公式用于计算最终特征.

此处使用软阈值功能(或软收缩功能). 有关详细信息,请参阅论文“稀疏信号处理的罚分和收缩函数”(不应为原始文本). 这种特征处理方法的具体应用可以参考“航空场景分类的无监督特征学习”一文.
(2)正交匹配追踪(OMP-k)
此方法类似于上面的SC.

(3)软阈值(T)
该方法使用软阈值函数获取系数S(特征),处理方法如下:
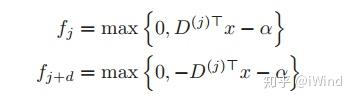
D是字典,x是样本,而alpha是阈值.
注意: 上面的字典学习和特征编码限制了字典D(每个元素是一个单位向量),并且在其他地方可以看到不同的限制方法. 此外,本文将比较这些方法,因此对D进行相同的处理.
由于词典训练和特征编码方法太多,如何在应用中选择它们?实际上,没有任何限制. 例如,我选择SC进行字典训练. 除了SC之外,我还可以选择其他任何特征编码方法来进行特征编码. 也就是说,在训练字典D之后,“无论使用哪种特征编码方法,都应注意,在字典训练阶段,优化成本函数时,需要根据成本风格选择优化方法. 例如,在字典学习SC的方法中,如果将L1范数用作惩罚函数,则在固定D来优化S的情况下使用OMP优化是不合理的,因为这是一个套索问题
为了进行优化,建议使用垃圾邮件工具包. 几乎有各种常用的优化方法,更好的一点是每种方法的相应程序都列出了可以用该方法解决的优化问题(该方法可以解决各种成本函数. 垃圾邮件,其中一个参数需要根据系统进行修改,然后进行编译). 下载链接:
SPAMSspams-devel.gforge.inria.fr
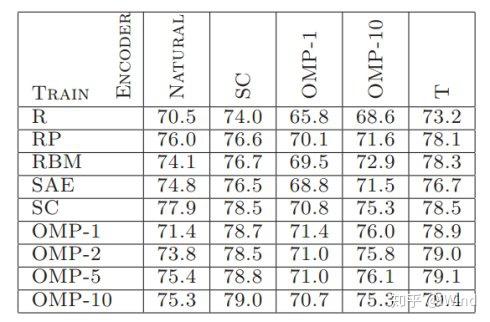
下图显示了结合字典训练和特征编码的识别效果(第一列代表字典学习方法,第一行代表特征编码方法). 可以看出,当使用不同的方法时,字典训练和特征编码可能会获得更好的结果. 啊
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-288760-1.html

 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
一来在世界舆论面前证明自己仍是世界老大