Linux awk
电脑杂谈 发布时间:2020-06-24 22:21:13 来源:网络整理
awk的自我介绍
awk,这是用于文本处理的三个剑客之一,其名称来源于其创始人Alfred Ahoawk数组初始化,Peter Weinberger和Brian Kernighan的姓氏的首字母,这不仅是Linux中最常见的功能,而且在任何环境强大的数据处理引擎之一. 作为一种功能强大的语言,它几乎具有完整语言应具有的所有精致功能.
基本格式: awk [options]“程序”文件…
program: pattern {动作声明; ..}
模式和动作:
  pattern部分决定动作语句何时触发及触发事件
      BEGIN,END
 action statements对数据进行处理,放在{}内指明
      print, printf
两种awk语法
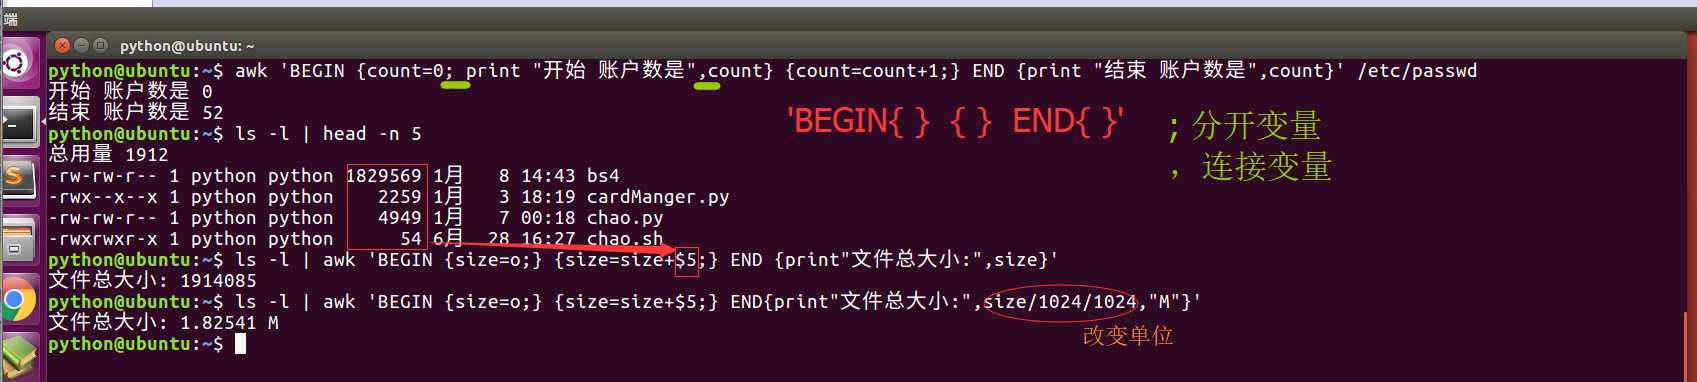
第一步: 在BEGIN {action; ...}语句块中执行该语句
第二步: 从文件或标准输入(stdin)中读取一行,然后执行pattern {action; ...}语句块,逐行扫描文件,从第一行开始重复此过程直到文件全部读到最后一行.
第3步: 读取输入流的末尾时,执行END {action;…}语句块
          BEGIN语句块在awk开始从输入流中读取行之前被执行,这是一个 可选的语句块,比如变量初始化、打印输出表格的表头等语句通常 可以写在BEGIN语句块中
          END语句块在awk从输入流中读取完所有的行之后即被执行,比如 打印所有行的分析结果这类信息汇总都是在END语句块中完成,它 也是一个可选语句块
    pattern语句块中的通用命令是最重要的部分,也是可选的。如果 没有提供pattern语句块,则默认执行{ print },即打印每一个读取 到的行,awk读取的每一行都会执行该语句块
三个awk运算符

四个awk控制语句
控制语句if-else
语法: if(condition){statement;…} [else statement]
if(condition1){statement1}否则if(condition2){statement2}
else {statement3}
场景使用场景: 对整个行或awk获取的字段进行条件判断
示例:
awk -F: '{if($ 3> = 1000)print $ 1,$ 3}'/ etc / passwd(如果小于1000则不进行处理,因此没有其他内容)
awk'BEGIN {test = 100; if(test> 90){print“ very good”} else if(test> 60){print“ good”} else {print“ no pass”}}''
同时控制语句
语法: while(condition){statement; ...}
条件为“ true”,进入循环;条件为“ false”,退出循环
场景使用场景: 用于一行一行地处理多个字段;用于一一处理数组中的每个元素
示例:
awk'/ ^ [[: space: ]] * linux16 / {i = 1; while(i 控制语句同时执行 语法: 执行{statement; ...} while(condition) 不管是对还是假,至少执行一次循环主体 示例: awk'BEGIN {sum = 0; i = 0; do {sum + = i; i ++;} while(i <= 100); print sum}' 控制语句 语法: for(expr1; expr2; expr3){声明; ...} 示例: awk'/ ^ [[: space: ]] * linux16 / {for(i = 1; i <= NF; i ++){print $ i,length($ i)}}''/etc/grub2.cfg 控制语句中断并继续 示例: awk'BEGIN {sum = 0; for(i = 1; i <= 100; i ++){if(i == 66)break; sum + = i} print sum}' awk'BEGIN {sum = 0; for(i = 1; i <= 100; i ++){if(i%2 == 0)continue; sum + = i} print sum}' awk数组 关联数组: array [index-expression] index-expression: (1)可以使用任何字符串;该字符串应用双引号引起来 (2)如果预先不存在数组元素,则awk将在引用该元素时自动创建该元素并将其值初始化为“空字符串” 示例: 工作日[“ mon”] =“星期一” awk'BEGIN {weekdays [“ mon”] =“星期一”; weekdays [“ tue”] =“星期二”;打印平日[“ mon”]}'' awk函数 数值处理: rand(): 返回0到1之间的随机数 示例: awk'BEGIN {srand();为(i = 1; i <= 10; i ++)print int(rand()100)}' 字符串处理: ength([s]): 返回指定字符串的长度 sub(r,s,[t]): 在t字符串中搜索由r表示的模式匹配内容,并将第一个匹配内容替换为s 示例: echo“ 2008: 08: 08 08:08:08” | awk'sub(/: /,“-”,$ 1)' gsub(r,s,[t]): 在t字符串中搜索r表示的模式匹配的内容awk数组初始化,并将所有内容替换为s表示的内容 示例: echo“ 2008: 08: 08 08:08:08” | awk'gsub(/: /,“-”,$ 0)' split(s,array,[r]): 使用r作为定界符,剪切字符串s,并将剪切结果保存到array表示的数组中,第一个索引值为1,第二个Index值为2 .... 示例: netstat -tan | awk'/ ^ tcp \> / {split($ 5,ip,“: ”); count [ip [1]] ++} END {for(i in count){print i,count [i]}}''< 五个小练习 1. 计算/ etc / fstab文件中每种文件系统类型的出现次数 awk'/ ^ UUID / {fs [$ 3] ++} END {for(i in fs){print i,fs [i]}}''/ etc / fstab 说明: / ^ UUID /: 以UUID开头的模式匹配行 fs [$ 3] ++: 将fs []定义为关联数组索引是每个记录的第三个字段,数组的值是出现次数 for(fs中的i){print i,fs [i]}: 处理完每条记录后,使用for循环遍历数组,打印下标(文件类型)和数组元素值(文件类型)出现)次)* 2. 计算/ etc / fstab文件中每个单词出现的次数 awk'{i = 1; while(i <= NF){word [$ i] ++; i ++}}} END {for(word中的数字){print num,word [num]}}''/ etc / fstab 说明: 使用while循环处理每个记录的每个字段,最重要的是在处理每个字段之后将i设置为-,以便在处理每个记录之后,由下一个的每个字段重新分配关联数组记录 3. 提取字符串yd $ C @ M05MB%9&Bdh7dq + yVixp3vpw中的所有数字 回显“ yd $ C @ M05MB%9&Bdh7dq + yVixp3vpw” awk'gsub(/ [^ [: digit: ]] /,“”,$ 0)' 说明: gsub(r,s,[t]): 在t字符串中搜索r表示的模式匹配的内容,并将所有内容替换为s表示的内容. 模式匹配使用扩展的正则表达式 4. 解决DOS ***生产情况: 根据Web日志或网络连接数,在短时间内监控IP或PV的并发连接数达到100,即调用firewall命令进行封锁相应的IP,监视频率每5分钟一次. 防火墙命令为: iptables -A INPUT -s IP -j REJECT awk'{access [$ 1] ++} END {for(i in access){if(access [i]> = 100){print i,access [i]}}}''access_log 每天动动脑筋来学习和进步,加油!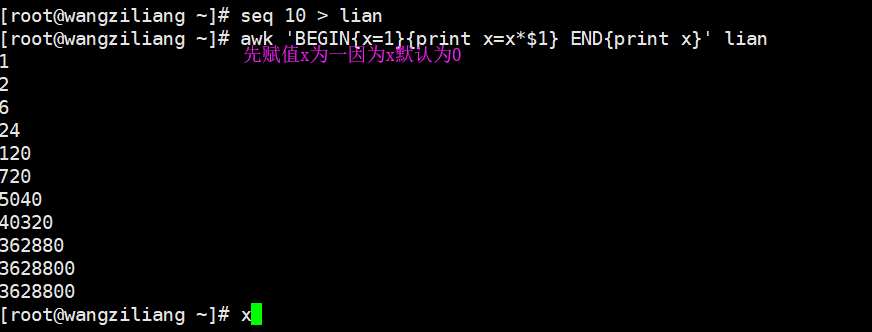


本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-257301-1.html

 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
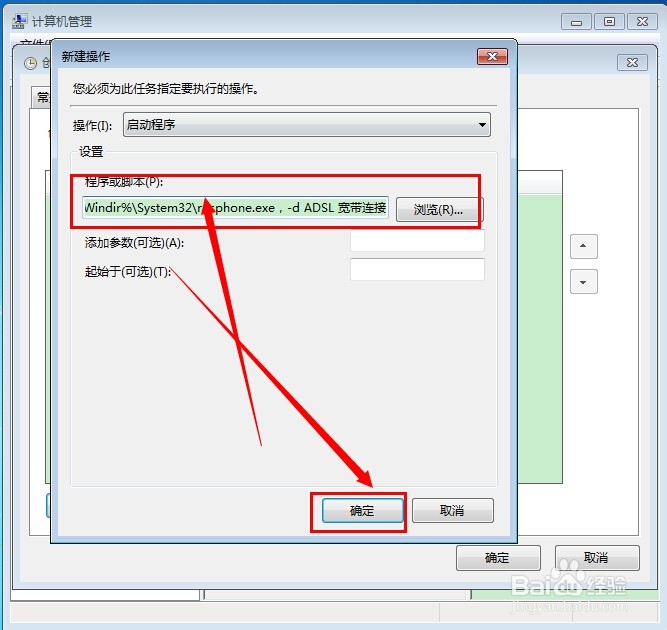 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
谁告诉你北洋没有一发炮弹击穿击穿主装甲