存储|大量数据|(连续数据增长和高并发解决方案),Java教程网络| IT开发人员
电脑杂谈 发布时间:2020-06-16 00:28:58 来源:网络整理
Ø掌握的大数据处理方案和HA
Ø掌握为什么需要中间件,什么是中间件
Ø掌握不同情况下所需的中间件功能
Ø掌握中间件的设计要领

要处理大数据,可以在将划分为表之前使用分区来提高的性能.
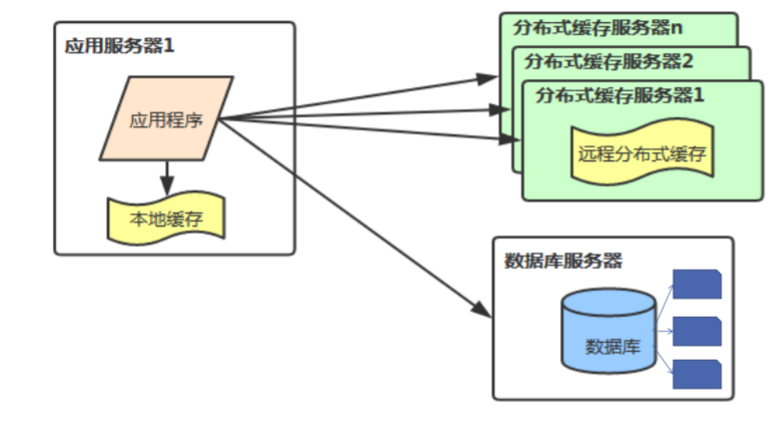
随着业务的发展,业务变得越来越复杂,应用程序模块越来越多,总数据量非常大,高并发读写操作超过单个处理能力的情况如何?服务器?
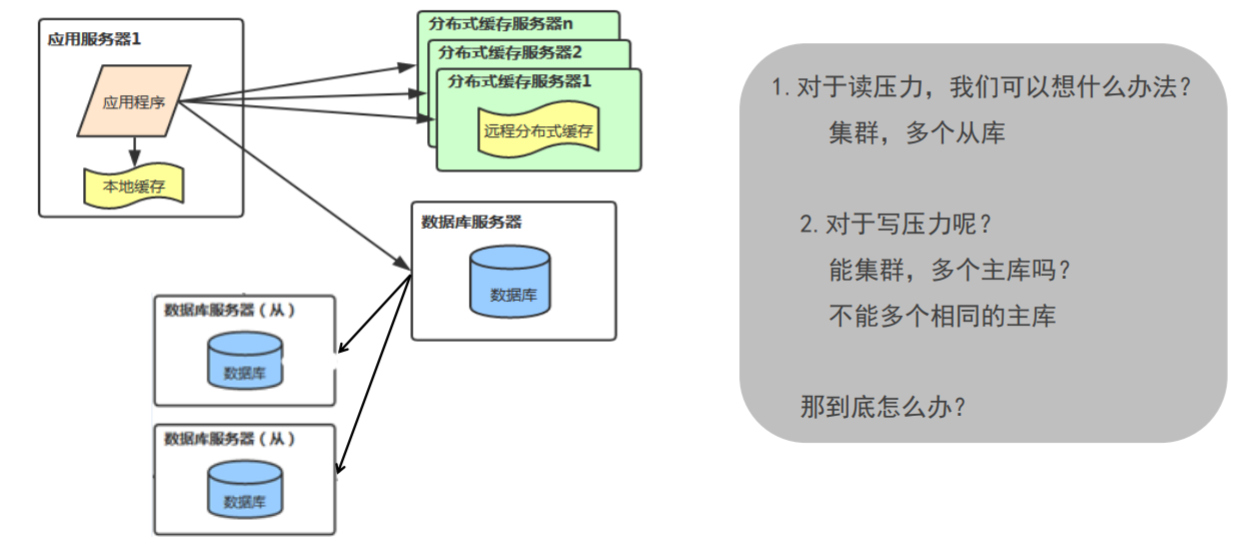
数据分片是指将存储在单个中的数据按照一定维度以分布式方式存储到多个或表中
数据分片的有效方法是将和关系的表分开
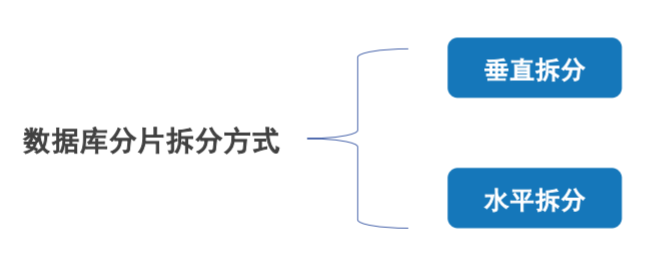
子库也称为垂直拆分或垂直拆分,它是指根据业务模块将数据分配到不同的服务器
是将最初存储在一个库中的表拆分并存储到多个库中. 通常,这些表根据功能模块和紧密关系进行划分,并部署到不同的库中.
如果是由于表太多而导致海量数据引起的,并且项目的业务逻辑被明确地划分并且耦合很低,那么子规则就是简单明了的规则和易于实现的首选.

好处:
Ø拆分后业务清晰,拆分规则清晰;
Ø系统之间易于集成或扩展;
Ø简单的数据维护.
缺点:
Ø有些业务表不能联接,只能通过接口来解决,这增加了系统的复杂性;
Ø由于每个业务的局限性不同,存在一个单一的库性能瓶颈,这对于数据扩展和性能改进而言并不容易;

Ø交易处理很复杂.
垂直拆分可以缓冲由数据量和访问量引起的问题,但无法解决.
如果单个表的数量很大并且超过了单个表的存储限制(例如电子商务网站上的产品表和订单表),该怎么办?
如果表中的数据量仍超过垂直分割后单个节点可以承载的阈值,则需要水平分片以进行进一步处理.
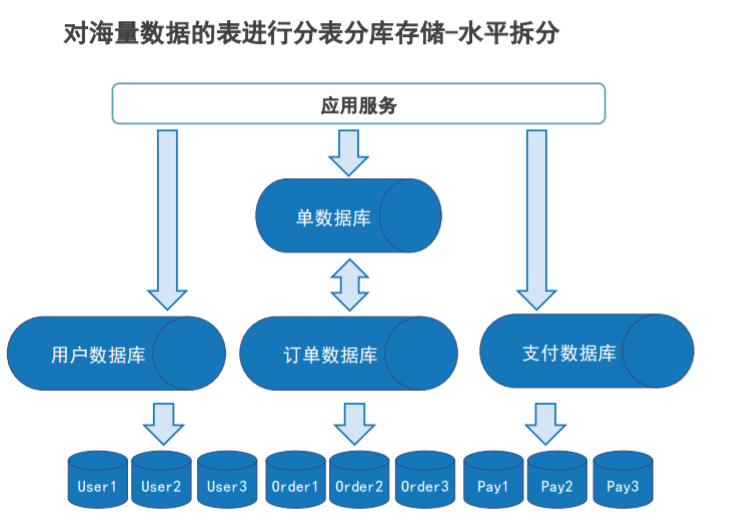
子表也称为水平分割. 它不再根据业务逻辑对数据进行分类,而是根据特定的规则或逻辑将表的数据划分为特定的字段(或几个字段). 多个副本存储在具有相同结构的多个表中. 这些多个表可以存在于一个或多个库中,并且每个分片仅包含一部分数据.
子表分为垂直子表和水平子表:
Ø垂直表划分: 将同一表中的内容划分为多个表. (根据关系的第三种标准形式,它应该在同一张表中. )
Ø水平表划分: 将一个表复制到具有相同表结构的不同表中,然后按照一定的规则将数据划分并分别存储在这些表中,以确保单个表的容量不会太大并提高性能;当然,这些具有相同结构的表可以放置在一个或多个中.

好处:
Ø拆分规则很抽象,联接操作基本上可以由完成;
Ø没有单一的大数据,并发性能瓶颈高;
Ø在应用程序方面的修改较少;
Ø提高系统的稳定性和负载能力.
缺点:
Ø拆分规则很难抽象;
Ø碎片交易的一致性难以解决;
Ø多重数据扩展的难度和维护量非常大;
Ø跨联接性能很差.
水平分割数据最重要的是分片规则-分割规则
如何拆分?
Ø范围: 时间,值;

Ø名单: 按地区,组织,分类;
Ø哈希: 哈希(一个字段)%的碎片数,一致性哈希;
Ø多种复合方式.
无论是垂直拆分还是水平拆分,都存在常见的技术困难:
Ø分布式交易问题;
Ø跨节点联接问题;
Ø跨节点合并排序和分页问题;
Ø多个数据源管理问题.
Ø1能够解析SQL
Ø2可支持读写分离
Ø3可以支持从库读取中进行负载平衡
Ø4支持子库操作
Ø5支持子表操作
Ø6支持跨关联查询
Ø7支持交易处理
Ø8个主键ID生成
Ø9个数据源管理
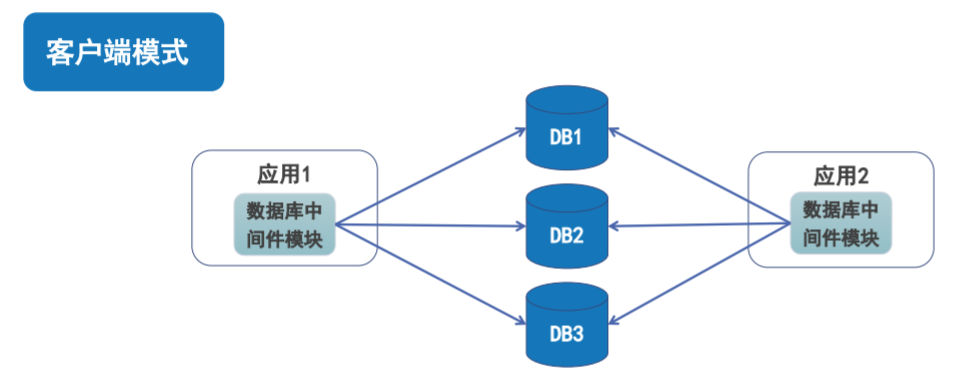
客户端模式,将中间件模块集成到应用程序中,通过该模块配置管理应用程序所需的一个(或多个)数据源,并访问每个数据源以完成模块中的数据集成.
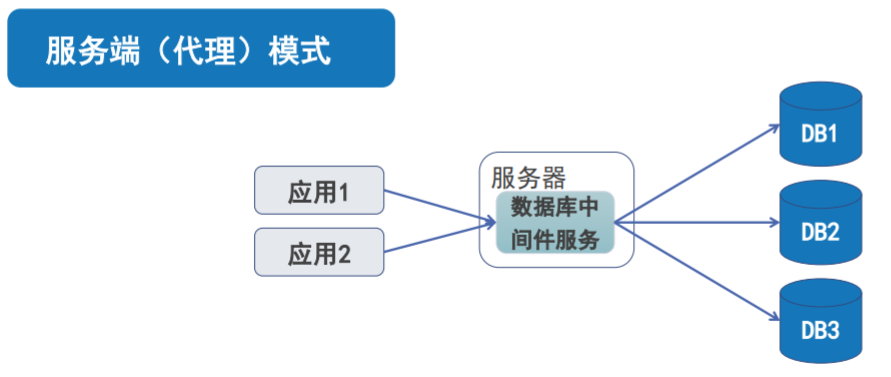
服务器(代理)模式下,通过中间代理层以统一的方式管理所有数据源,后端集群对前端应用程序是透明的,并且易于扩展. 独立服务可以提供更强大的处理能力. 适用于大型和复杂的系统.
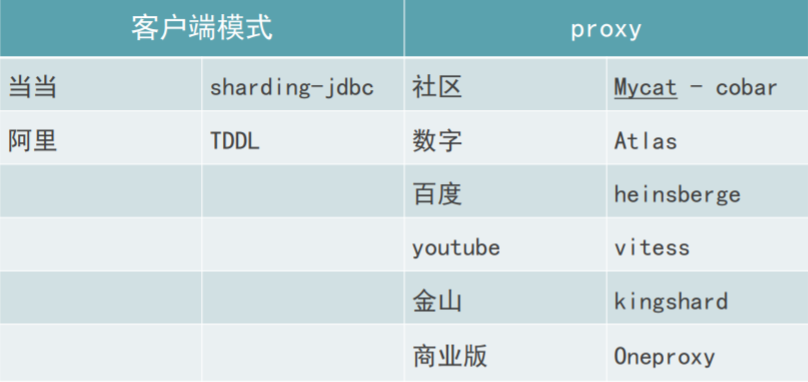
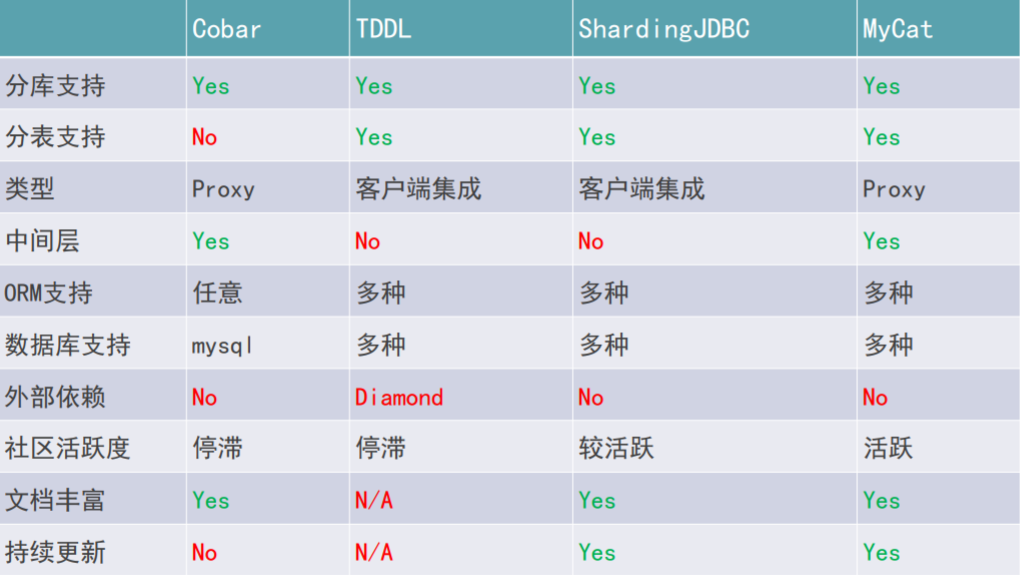


Ø用于企业应用程序开发的完全开源的大型集群
Ø支持事务,ACID,可替代MySQL的增强型
Ø一种企业级,可以视为MySQL集群,用于替换昂贵的Oracle集群
Ø结合了内存缓存技术,NoSQL技术和HDFS大数据的新型SQL Server
Ø结合传统和新型分布式数据仓库的新一代企业产品
Ø一种新颖的中间件产品.
官方网址:
Github地址:
Github上文档的地址:
2013年,阿里巴巴的Cobar发现在社区中使用它存在一些严重的问题和限制. 在对Mycat启动子进行首次改进之后,第一代改进版本Mycat诞生了. 在Mycat开源之后,一些Cobar用户参与了Mycat的开发,最终Mycat发展成为一个由社区的开源软件,由许多软件公司的强大架构师和高级开发人员维护.
Ø1个JDK1.7 + Mycat是用Java开发的
Ø2个MySQL统一5.7镜像地址:
Ø3 Mycat安装包下载地址: 最新版本: 1.6.6.1
Ø1源代码导入到IDE中,源代码地址:
Ø2安装包的安装,下载地址:
中间件: 对于应用程序,mycat是服务,而mycat是后端集群的代理
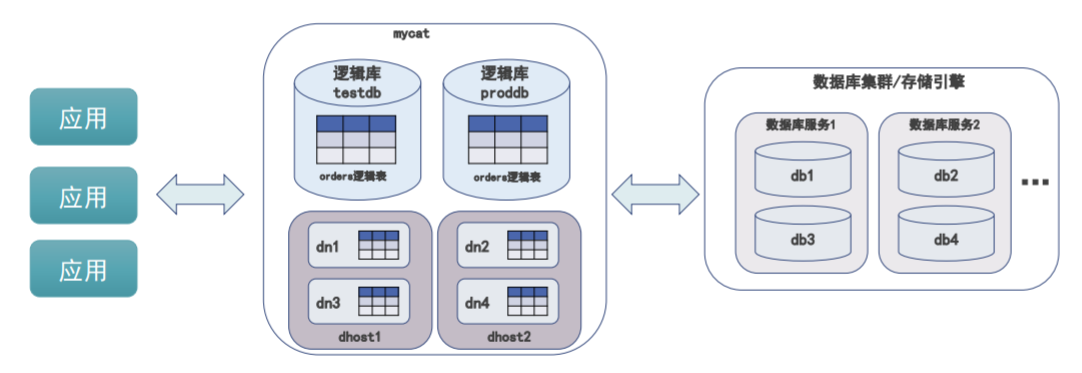
schema.xm
<mycat:schema>
 <schema name="testdb">
   <table name="orders" primaryKey="ID"type="global" dataNode="dn1,dn2" />
 </schema>
 <dataNode name="dn1" dataHost="dhost1" database="db1" />
 <dataHost name="dhost1" ...>
     <heartbeat>select user()</heartbeat>
     <writeHost host="hostM1" url="localhost:3306"...>
     <readHost host="hostS2" url="192.168.1.2:3306".../>
     </writeHost>
 </dataHost>
</mycat:schema>
逻辑概念:
Ø逻辑库: 在mycat服务中定义和管理的
Ø逻辑表: 逻辑库中包含的表,需要存储在一个库和一个表中
ØdataNode: 数据节点(分片节点),逻辑表分片的存储节点.
ØdataHost: 数据主机(节点主机),数据节点所在的主机.
物理概念
ØwriteHost: 写主机,真实的服务主机描述
ØreadHost: 读取主机,真实的服务主机描述
Ø解决磁盘系统的最大文件限制,例如,常见的限制是:
FAT16(最大分区2GB海量数据处理方案,最大文件2GB)
FAT32(最大分区32GB,最大容量2TB,最大文件32G)
NTFS(最大分区2TB,最大容量,最大文件2TB)
EXT3(最大文件大小: 2TB,最大文件限制: 仅受文件系统大小限制,最大分区/文件系统大小: 4TB,最大文件名长度: 255个字符)
Ø减少增量数据写入过程中查询对锁的影响,减少由长时间查询导致的表锁,影响诸如写入操作之类的锁竞争,节省排队时间,并提高吞吐量.
Ø由于减少了单个表的数量,普通查询操作减少了需要扫描的记录数量,因此减少了单个表单查询所需的搜索行数,从而减少了磁盘IO ,并且延迟缩短了.
基本思想是分析表之间的业务功能和聚合关系,并将紧密相关的表放在一起. 子库的粒度是指在进行分段时允许将几级关联表放在一起. 此问题对应用程序的实现有很大影响. 关联被中断的次数越多,加入操作的影响就越大.
需要结合“业务亲密性”和“表数据量”两个因素来考虑实际的粒度控制
Ø如果组合在一起的表紧密相关,并且数据量不大,并且增长速度也很慢,则适合将它们放在一起而不进行水平拆分;
Ø如果组合在一起的表的数据量巨大且增长速度很快,则有必要根据子库对表进行划分,这意味着原始的单个库可能会拆分为多个库,这会带来更多的复杂性,最好一开始就考虑一下
对于垂直子表,通常根据业务功能的使用频率将主字段和流行字段用作主表;然后根据业务属性汇总不常见的数据,并在辅助表中将其拆分为不同的数据;主表和辅助表之间的关系通常是的.
对于水平子表,通常根据特定的业务规则和数据格式,选择可以合理拆分数据的业务数据作为拆分标准,以便拆分数据.
水平分割数据最重要的是分片规则-分割规则
Ø范围: 时间,值;
Ø名单: 按地区,组织海量数据处理方案,分类;
Ø哈希: 哈希(一个字段)%的碎片数,一致性哈希;
Ø多种复合方式.
第一个原则: 尽量不要分裂
第二个原则: 如果要拆分,必须选择适当的拆分规则并事先计划.
第三条原则: 数据分段应尝试通过数据冗余或表分组来减少跨联接的可能性.
第四原则: 由于中间件很难掌握数据连接的优缺点,并且很难实现高性能,因此业务读取应使用尽可能少的表.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-246798-1.html
-

-
张雪
超期待哦
 Go socket编程实践: UDP服务器和客户端实现
 如图所示,四边形ABCD为正方形,点E和K在BC和AB上,点G在BA的延长线上
 win7系统打开网页的新窗口不是最大化的问题
 金山毒霸官方版v2019.1查看金山网盾正式版查看功能特点
只是骂它