几个线性链表算法问题
电脑杂谈 发布时间:2020-06-13 21:13:47 来源:网络整理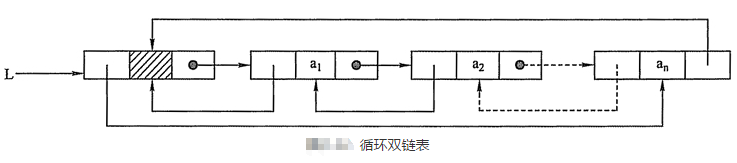
#define ERROR 0
#define TRUE 1
#define FALSE 0
#define OK 1

#define MAXSIZE 20 /* 存储空间初始分配量 */

typedef int Status;/* Status是函数的类型,其值是函数结果状态代码,如OK等 */
typedef int ElemType;/* ElemType类型根据实际情况而定,这里假设为int */
//定义结点
typedef struct Node{
    ElemType data;
    struct Node *next;
}Node;
typedef struct Node * LinkList;
要求: 将两个递增的有序链表合并为一个有序链表;要求生成的链表仍然使用两个链表的存储空间,并且不占用其他存储空间. 表中不允许重复的数据.
关键字:
递增排序的链表,不允许重复数据,保留增量关系(后插值方法),不占用额外的存储空间,意味着无法打开任何新节点,并且将值分配给链表; <
思考:
假定要合并的链表是La和Lb,则合并的新表使用头指针Lc(Lc的头节点设置为La的头节点)指向. Pa和Pb分别是La和Lb指针的功. 从第一个节点比较相应链表的第一个节点,并且当链表La和Lb都未到达表的末尾时,较小的值将被顺序提取并在Lc的末尾重新链接表. 如果两个表中的元素相等,则仅提取La表中的元素并删除Lb表中的元素,以确保合并表中没有重复的元素;当表达式到达表的末尾为空时,则不为空. 列表的其余元素直接链接到Lc列表的末尾. 最后,释放链表Lb的头节点;
void MergeList(LinkList *La, LinkList *Lb, LinkList *Lc) {
    //目标:将2个递增的有序链表La,Lb 合并为一个递增的有序链表Lc
    LinkList pa,pb,pc,temp;
    //pa 是链表La的工作指针,pb 是链表Lb的工作指针, 初始化为首元结点;
    pa = (*La)->next;
    pb = (*Lb)->next;

    *Lc = pc = *La;
    while (pa && pb) {
        if (pa->data < pb->data) {
            //取较小者La中的元素,将pa链接在pc的后面,pa指针后移
            pc->next = pa;
            pc = pa;
            pa = pa->next;
        }else if(pa->data > pb->data){
            //取较小者Lb的元素,将pb链接在pc后面, pb指针后移
            pc->next = pb;
            pc = pb;
            pb = pb->next;
        }else
        {
            //相等时取La中的元素,删除Lb的元素;
            pc->next = pa;
            pc = pa;
            pa = pa ->next;
            temp = pb->next;
            free(pb);
            pb = temp;
        }
    }
    //将非空表的剩余元素之间链接在Lc表的最后
    pc->next = pa?pa:pb;
    //释放Lb的头结点
    free(*Lb);
}
例如:
 La = {2,4,6,8}; Lb = {4,6,8,10};
 Lc = {4,6,8}
关键字:
依次提取两个表中的相同元素,然后重新链接,删除其他不相等的元素;
思考:
假定要合并的链表是La和Lb,则合并的新表使用头指针Lc(Lc的头节点设置为La的头节点). Pa和Pb分别是La和Lb的指针. 当两个链接列表La和Lb都未到达列表末尾时,将从头节点比较初始化为相应链接列表的头节点. 如果两个列表中的元素相等,则仅提取La列表. 如果表之一中的元素较小,请删除该表中的较小元素. 该表的工作指针向后移动;当链表La和Lb的节点首先到达表的末尾时,当链表La和Lb为空时,依次删除另一个非空列表中的所有元素,最后释放链表lb;
void Intersection(LinkList *La, LinkList *Lb, LinkList *Lc){

    //目标: 求2个递增的有序链表La,Lb的交集, 使用头指针Lc指向带回;
    LinkList pa,pb,pc,temp;

    //pa 是链表La的工作指针,pb 是链表Lb的工作指针, 初始化为首元结点;La的头结点作为Lc的头结点;
    pa = (*La)->next;
    pb = (*Lb)->next;
    *Lc = pc = *La;

    while (pa && pb) {

        if (pa->data == pb->data) {
            //相等,交集并入结果链表中;
            //(1).取La中的元素,将pa链接到pc的后面,pa指针后移;
            pc->next = pa;
            pc = pa;
            pa = pa->next;
            //(2)删除Lb中对应相等的元素
            temp = pb;
            pb = pb->next;
            free(temp);
        }else if(pa->data < pb->data){

            //删除较小值La的元素;
            temp = pa;
            pa = pa->next;
            free(temp);
        }else{
            //删除较小值Lb中的元素
            temp = pb;
            pb = pb->next;
            free(temp);
        }
    }

    //Lb为空,删除非空表La中的所有元素
    while (pa) {

        temp = pa;
        pa = pa->next;
        free(temp);
    }

    //La为空,删除非空表Lb中的所有元素
    while (pb) {
        temp = pb;
        pb = pb->next;
        free(temp);
    }


    pc->next = NULL;
    free(*Lb);
}
例如: L = {0,2,4,6,8,10},反转后: L = {10,8,6,4,2,0};

关键字:
无法打开新空间,只能更改指针;您可以考虑使用预插值方法逐一提取节点,以创建链表,然后在头节点之后插入该节点一次;因为首先插入的节点是表的尾部,而后面插入的节点是表的头,这可以反转链表;
思考:
使用原始的头节点* L,p是工作指针. 在开始时,p指向头节点. 因为已提取的节点是按顺序向前插入的,所以为了确保链表的尾部为空,头节点最初为. 从前到后遍历链表,并依次提取节点. 提取节点之前,需要使用指针q记录后续节点,以防止链接后后续节点丢失;插入提取的节点到达头节点后,最后一个p指向新的挂起节点q(p = q);
void Inverse(LinkList *L){
    //目的: 逆转带头结点单链表L;
    LinkList p,q;
    //p指向首元结点;
    p = (*L)->next;
    //头结点的指针域置空
    (*L)->next = NULL;

    //遍历链表
    while (p!=NULL) {

        //q执行p的后继
        q = p->next;
        //p->next = (*L)->next
        p->next = (*L)->next;
        //*p 插入到头结点之后;
        (*L)->next = p;
        //处理下一个结点
        p = q;
    }
}
关键字:
通过遍历链表,可以找到已删除元素的上下边界,可以找到第一个节点的值大于mink,第一个节点的值大于或等于maxk;

思考:
找到第一个值大于mink的节点线性双链表,使用q指向该节点,并预先指向该节点的前驱节点;继续遍历链表以找到其值大于或等于maxk的第一个节点,使用p指向该节点;下边界的前体节点的指针字段被修改为指向上边界(pre-> next = p);顺序删除要删除的节点的空间(pre和p之间的所有节点);
void DeleteMinMax(LinkList *L, int mink, int maxk){
    //目标: 删除递增有序链表L中值大于等于mink 和小于等于maxk的所有元素

    LinkList p,q,pre;
    pre = *L;
    LinkList temp;

    //p指向首元结点
    p = (*L)->next;

    //1.查找第一值大于mink的结点
    while (p && p->data < mink) {
        //指向前驱结点
        pre = p;
        p = p->next;
    }

    //2.查找第一个值大于等于maxk的结点
    while (p && p->data<=maxk) {
        p = p->next;
    }

    //3.修改待删除的结点指针
    q = pre->next;
    pre->next = p;

    while (q != p) {
        temp = q->next;
        free(q);
        q = temp;
    }
} 例如: pre[10] = {0,1,2,3,4,5,6,7,8,9},
n = 10,p = 3;
pre[10] = {3,4,5,6,7,8,9,0,1,2}思考:
首先反转第9、8、7、6、5、4、3、2、1,0处的n个数据;将n个数据分解为[9,8,7,6,5,4,3] [2,1,0]分别反转第一个np数据和最后一个p数据; [3,4,5,6,7,8,9] [0,1,2] <
void Reverse(int *pre,int left ,int right){

    //将数组R中的数据原地逆置

    //i等于左边界left,j等于右边界right;
    int i = left,j = right;
    int temp;

    //交换pre[i] 和 pre[j] 的值
    while (i < j) {

        //交换
        temp = pre[i];
        pre[i] = pre[j];
        pre[j] = temp;

        //i右移,j左移
        i++;
        j--;
    }
}
void LeftShift(int *pre,int n,int p){

    //将长度为n的数组pre 中的数据循环左移p个位置
    if (p>0 && p<n) {
        //1. 将数组中所有元素全部逆置
        Reverse(pre, 0, n-1);
        //2. 将前n-p个数据逆置
        Reverse(pre, 0, n-p-1);
        //3. 将后p个数据逆置
        Reverse(pre, n-p, n-1);

    }
}
分析:
main元素是数组中出现次数超过一半的元素;当数组中有一个主要元素时,所有非主要元素的数量之和必须小于一半. 如果主元素与非主元素配对,则最后一个额外的元素(没有与之匹配的元素是主元素.
思考:
选择候选主元素,并从前到后扫描数组中的每个整数,假定第一个整数是主元素,将其保存在Key中,并且计数为1. 如果仍然遇到下一个整数等于键,计数增加1. 否则,计数减小1. 当计数减小为0时,遇到的下一个整数将保存到键中,并且计数重新记录为1. 开始新一轮的计数. 您可以从当前位置再次开始上述过程,直到扫描了数组的所有元素为止;确定键中的元素是否为真正的主要元素,再次扫描数组,计算键中的元素出现的次数,如果它大于n / 2,则为主要元素,否则为否存在于序列Main元素中;
int MainElement(int *A, int n){

    //目标: 求整数序列A中的主元素;
    //count 用来计数
    int count = 1;
    //key 用来保存候选主元素, 初始A[0]
    int key = A[0];

    //(1) 扫描数组,选取候选主元素
    for (int i = 1; i < n; i++) {

        //(2) 如果A[i]元素值 == key ,则候选主元素计数加1;
        if (A[i] == key) {
            count++;
        }else{
            //(3) 当前元素A[i] 非候选主元素,计数减1;
            if(count >0){
                count--;

            }else{
               //(4) 如果count 等于0,则更换候选主元素,重新计数
                key = A[i];
                count = 1;
            }

        }
    }
    //如果count >0
    if (count >0){

        //(5)统计候选主元素的实际出现次数
        for (int i = count = 0; i < n; i++)
            if (A[i] == key) count++;
    }

    //(6)判断count>n/2, 确认key是不是主元素
    if (count > n/2) return key;
    else return -1; //不存在主元素

}
7. 使用单链列表存储m个整数,节点的结构为(数据,链接),并且| data | <= n(n为正整数). 现在我们必须设计一个尽可能高效的时间复杂度算法. 对于链接列表中数据绝对值相同的节点,仅保留首次出现的节点,而其余绝对值相同的节点将被删除.
例如,链表A = {21,-15,15,-7,15}, 删除后的链表A={21,-15,-7};分析:
需要设计一种具有尽可能高的时间复杂度的算法,并且已知| data | <= n,因此可以考虑使用空间作为时间的方法. 申请空间大小为n + 1(不使用单位0)数组的辅助数组. 保存出现在链表中的值,然后通过扫描链表将其删除.
思考:
应用大小为n + 1的辅助数组t并将初始值指定为0;从第一个节点遍历链接列表,依次检查t [| data |]的值,如果[| data |]为0,即如果该节点首次出现线性双链表,则保留该节点并设置t [| data |] = 1,如果t [| data |]不为0,则从链接列表中删除该节点.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-244276-1.html

 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
苹果手机更新系统后又有好玩的了