cuda并行计算体系结构和编程
电脑杂谈 发布时间:2020-06-07 21:26:16 来源:网络整理
CUDA并行体系结构和编程摘要CUDA是NVIDIA推出的并行计算体系结构,非常适用于数据密集型计算. CUDA使GPU的超高计算性能在数据处理和并行计算等通用计算领域发挥了优势. 本文讨论了CUDA计算架构和基于GPU的CUDA C编程语言. CUDA可以充分利用GPU流处理器阵列的性能. 大大提高了并行计算程序的效率. 关键词并行计算,GPU通用计算,CUDA摘要CUDA是NVIDIA推出的并行计算架构,主要用于数据密集型计算. CUDA使GPU在并行计算,数据处理和其他通用计算中具有高性能. 本文讨论了基于GPU的CUDA计算架构和CUDA C编程语言,CUDA使GPU流处理器阵列得到充分利用,并大大提高了并行计算程序的效率. 关键词并行计算,GPU通用计算,CUDA 1简介并行计算是指同时使用多个计算资源解决计算问题的过程.
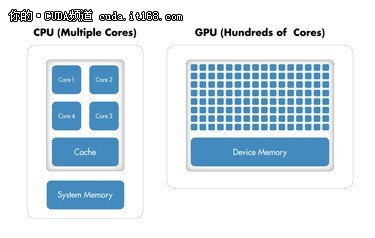
并行计算科学的主要研究是空间并行问题. 从程序和算法设计的角度来看,并行计算可分为数据并行性和任务并行性. 一般来说,GPU更注重数据并行计算,主要是将大型任务分解为相同的子任务. 早期的GPU研究使用可编程计算单元来计算屏幕上每个像素的颜色值,这就是渲染问题. 自CUDA C问世以来,基于GPU的通用计算已成为一个新的研究领域. 通常,像素着色器会合并各种颜色值并计算最终颜色值. 实际上,输入值可以是任何数据,因此不必使用GPU来处理图形,并且还可以实现一些常规计算. 由于GPU具有很高的计算吞吐量,因此它为大型数据计算应用程序提供了比CPU更强大的计算能力. CUDA是NVIDIA推出的一种并行计算架构,它使GPU能够解决复杂的计算问题. 它包含CUDA指令集架构和GPU内的并行计算引擎[1]. 随着图形卡的发展,GPU变得越来越强大,并且在计算方面已经超过了通用CPU. 如果仅将这种功能强大的芯片用作图形卡,则会造成计算能力的浪费,因此NVIDIA推出了CUDA,因此该图形卡可用于图像渲染以外的目的. CUDA的GPU编程语言基于标准C语言. 通过在标准C语言中添加少量关键字,任何具有C语言基础的用户都可以轻松开发CUDA应用程序.

成千上万的软件开发人员正在使用免费的CUDA软件开发工具来解决各行各业的问题[2]. 这些解决方案涵盖了油气勘探,产品设计,医学成像和科学研究等领域. 2 CUDA体系结构CUDA程序体系结构分为两部分: 主机和设备. 一般来说,主机是指CPU及其内存,设备是指GPU [1]. 在CUDA程序体系结构中,主程序由CPU执行,当遇到数据并行处理部分时,CUDA会将程序编译为GPU可以执行的程序,并将其传输到GPU. 此功能在CUDA中称为内核功能. GPU中要执行的线程基于最有效的数据共享创建线程块,该共享具有多个维度. 同一块中的线程使用相同的共享内存. 每个线程由线程ID标识. 这是线程块中的线程号. 为了帮助基于线程ID的复杂寻址,也可以将线程块指定为任意大小的一维,二维或高维线程数组,并使用多个索引组件来标识每个线程[2]. 线程块的大小也受到限制,因此您不能将所有线程放在同一个块中. 您可以使用相同尺寸和大小的块来形成用于批处理的网格. 执行内核的线程被组织成线程块. 线程块形成一个线程网格,如图1所示. 线程块中相互协作的线程有效地共享数据gpu并行计算框架,并通过一些快速共享的内存同步执行以协调内存访问.
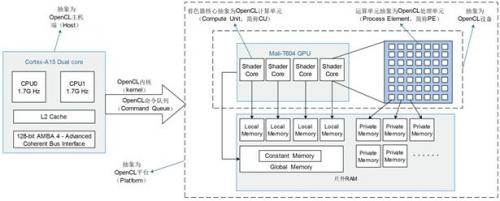
用户可以在内核函数中指定同步点. 达到此同步点时,线程块中的线程将挂起. 图1线程被组织为线程网格和线程块. 图2 SM单元在GPU内部组成. SM代表流处理器,即计算核心. 每个SM包含8个标量流处理器(SP)和少量其他计算单元[3],如图2所示. 实际上,SP只是一个执行单元,而不是完整的处理核心. 处理核心必须包含指令提取,解码,分配逻辑和执行单元. 属于同一SM的8个SP共享相同的获取和发送单元集合,并且还共享共享的存储器. 必须将线程块分配给SM,但是SM中可以有多个活动线程块等待同时执行. 这样可以更好地利用执行单元的资源. 当一个线程块同步或访问诸如视频内存之类的高延迟操作时,另一个线程块可能会占用GPU执行资源. 每个线程都有一个专用的本地内存,即每个标量处理器的专用缓存. 每个线程块都有一个共享内存,该块中的所有线程都可以访问该共享内存. 每个线程网格都可以访问设备内存,该内存是GPU Slice上的全局内存. 每个线程都可以读写全局内存. 本地存储器用于在设备代码中存储无法放入寄存器[3]的变量. CUDA架构的所有这些功能不仅使GPU能够执行传统的图形计算,而且还能够有效地执行通用计算.
3 CUDA C编程3.1 CUDA并行编程在GPU上运行的CUDA并行计算功能称为内核功能(内核). 内核功能不是一个完整的程序,而是整个程序中可以并行执行的步骤[2]. 内核函数必须由_global_函数类型限定符定义,例如_global_ void内核(void). 并且只能在主机端代码中调用. 调用时,必须声明内核函数的执行参数. 现在考虑向N位向量的每个位添加一个常量. 为了完成此操作,设计了一个add函数,该函数在C代码和CUDA C中表示为: #define N 10#define N 10 void add(int * a,int b){_ global_void add(int * a, int b)int index = 0; {while(index >>(device_a,5); cudaMemcpy(host_a,device_a,N * sizeof(int),cudaMemcpyDeviceToHost); cudaFree(device_a); //释放内存返回0;}定义内核函数后,可以在主函数中调用它. add表示启动了N个线程块,每个线程块都包含一个线程.
在内核功能启动之前,CPU串行代码完成的工作包括数据准备和设备初始化. cudaMalloc()函数用于在GPU设备上分配内存. 第一个参数是指向变量的指针,该变量用于保存新分配的内存的地址. 第二个参数指示分配的内存的大小. 应当注意的是,由该分配功能获得的指针不能在主机存储器中使用. cudaMemcpy()通过设置参数在CPU和GPU之间传输数据. 主要功能首先完成阵列的初始化,然后将数据传输到GPU. 并行计算完成后,结果将返回给CPU. 3.2线程的同步和通信在上一节中的向量递增操作示例中,通过创建包含一个线程的N个进程,我们向向量的每个位添加了一个常数. 上面的计算不需要考虑线程块内线程的同步和通信,但是实际上大多数应用程序都需要程之间传输数据. 这也是CUDA提供的最重要的创新. 它使在GPU上工作的线程能够协同工作以解决问题,从而使应用程序能够更高效地执行[2]. 同一块中的线程使用同步函数_syncthreads()来确保该块中的线程是同步的,也就是说,该线程块中的所有线程都被执行到同一位置. 为了在硬件上以较低的成本实现_syncthreads()函数,一个块中所有线程的数据必须由同一处理内核处理[3].

因此,这导致每个线程块中的线程数受到处理核心硬件资源的限制. 目前,每个块中最多有512个线程[2]. 同一块中的线程通过共享内存交换数据. 为了确保线程块中的每个线程可以有效协作,访问共享内存的延迟必须很小. 因此,在GPU中,共享内存和执行单元之间的物理距离必须很小. CUDA C中同一块中的线程通过共享变量进行通信,并使用__shared__定义共享变量. 一个大型矩阵乘法示例用于说明线程块中线程的同步和通信以及线程之间的互斥. 矩阵A(MxN)与矩阵B(NxK)的乘法公式为[5]: (1)为简单起见,此处仅考虑1xN矩阵与Nx1矩阵的乘积,因此公式简化为: (2 )您可以首先让每个进程计算aibi,因为每个进程需要保存一个临时变量来计算累加,并且在计算乘积之后,索引将移动blockDim.x * gridDim.x单位. 这样,线程块中的每个线程都拥有多个aibi,并且需要在每个线程块中设置一个共享数组变量__shared__ int var [threadsperblock]. 该数组的大小是线程块中的线程数. 这样,线程块中的每个线程都会将其累加值分配给var [threadsperblock].
完成var的分配后,将存储var数组并将其存储在var [0]中. 这时,需要调用同步函数_syncthreads()以确保过程块中的所有过程在累加之前都已完成计算. 此时,过程网格中的每个过程块都有一个累加和var [0]. 属于每个过程块的这些var [0]需要累积并存储在变量c中. 该操作可以由线程块执行,任何一个要完成的线程都可以将其设置为线程0. 最后,将结果c发送回CPU. 在第二步的累加中,为了确保只访问变量c,需要一个原子锁(). 内核函数的主要部分可以从上面的讨论中获得: __global__ void matrix(Lock lock,float * a,float * b,float * c){__shared__ float var [threadsperblock]; int索引= threadIdx.x + blockIdx.x * blockDim.x; int varnum = threadIdx.x; //初始化索引float temp = 0;而(索引
使用Lock结构的优点是可以在GPU上执行连续加法处理,并且CPU获得最终结果. 定义内核函数后,可以在主函数中调用它. 主要功能的流程与上一节相似. 主要原因是同时启动的内核功能数量不同. Matrix表示启动了blockpergrid线程,并且每个线程块中都有threadsperblock线程. . int main(void){、、、、、、、、、、、、 // CPU完成一些数据准备和设备初始化工作Lock lock; matrix(lock,device_a,device_b,device_c); cudaMemcpy(&c,device_c,sizeof(float),cudaMemcpyDeviceToHost)); ,,,,,,,,,,,,,和///在返回结果到CPU后释放请求的内存} 4结论GPU具有更特定的CPU比特定的科学计算中的CPU更强大的计算能力,例如用于气象和医学图像的相关算法,数据量非常大,使用CUDA的计算能力可以显着提高计算速度,具有广阔的应用前景. CUDA的新技术为科学领域的计算提供了一种新的研究方法. 由于GPU具有处理大量数据和并行数据计算的特点,因此CUDA非常适合需要并行计算的领域.
当前,CUDA可以用C语言开发,并且还提供FORTRAN应用程序接口. 未来,预计CUDA将支持各种语言,例如C ++,Java和Python. 但是,如果要充分利用GPU的计算能力,则需要合理地分解计算问题以适应GPU的计算模式,并利用多级内存和并行计算的优势. 参考文献[1] Shane Ryoo,Christopher I. Rodrigues,Sara S. Baghsorkhi,Sam S. Stone,David B. Kirk,文美. 基于CUDA的多线程GPU的优化原理和应用性能评估[J]. 第13届ACMSIGPLAN并行编程原理和实践研讨会论文集,[2] Jason Sanders,Edward Kandrot. CUDA示例[M]. Addison WesleyProfes-sional,2010. [3]钱悦,图形处理器CUDA编程模型的应用研究[J]. 计算机和数字工程V36,2008年第12期. [4]约翰·尼克尔斯,伊恩·巴克,迈克尔·加兰德,凯文·斯卡德隆. 关键词: CUDA,可扩展并行编程GPU计算队列主页存档,第6卷,第2期,2008年. [5]肖江,胡克亮,邓元勇. 矩阵乘法与FFT性能测试[J]. 计算机工程,2009年第35卷第10期. [6]刘勇,使用GPU加速通用科学计算[J],科学技术信息gpu并行计算框架,2008年,第24期.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-237602-1.html
-

-
水野理纱
即使是后面一条
-
杨丽停
我们也要摆出姿态
-
 win8音频服务未运行怎么办usb音频硬件-驱动与驱动程序大全
 华为畅享5s园卡/插卡? 畅享5s手机sim卡安装图文方法
 大容量存储系统概述
 麦浚龙新片《风林火山》发布 梁家辉演心理专家
刚张嘴就暴露自己水军