[原始] R语言支持向量机svm带有代码数据的实践案例报告
电脑杂谈 发布时间:2020-04-25 21:16:22 来源:网络整理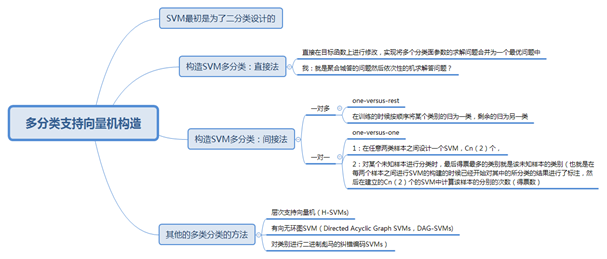
支持向量机第一次看到这个词时,可能很难理解这个奇怪的名字. 这是深度学习出现之前的90年代算法. 广泛的分类器之一. SVM是一种基于严格数学推导的算法(本文不介绍),本文仅简要介绍其基本概念,简单原理和实际过程.
最大间隔分类器
在二维平面上,直线可以将平面分为两边;在三维空间中,平面可以将空间分成两部分. 然后,以相同的方式,在p + 1高维空间中,p维超平面也可以分为两部分. 超平面的定义:
超平面的定义
根据高中空间几何的知识,将点代入上述公式. 如果等于0,则表示它在超平面上;否则等于0. 大于0大于0,小于0小于
然后,您可以根据此功能映射二进制分类问题. 只要构造超平面方程r语言 支持向量机分类,然后替换样本点,就可以根据结果的符号进行分类.
超平面分离
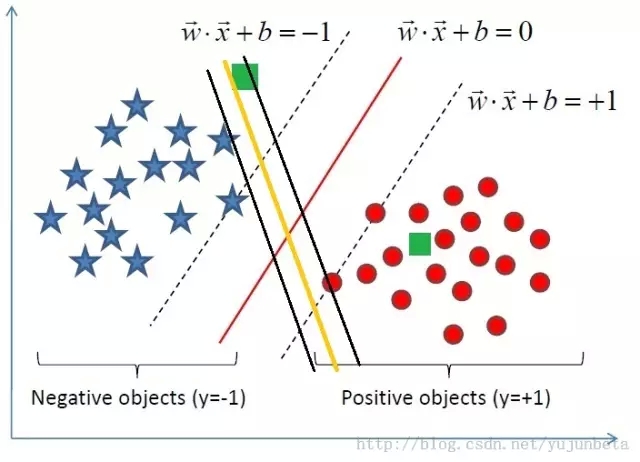
实际上,有一个以上的超平面可以分离不同类型的样本,并且不计其数. 如图所示,蓝色和橙色虚线可以将两种类型的样本分开,那么您认为哪种更好?

如果超平面被蓝色分隔,则上面的白色球被分成橙色,下面的白色球被分成蓝色;如果超平面用橙色分隔,则结果完全相反. 但是,按照KNN的思想,很容易看出上面的白球应该分成蓝色,下面的白球应该分成橙色.
可以观察到,橙色超平面通常比蓝色双侧球更远离球. 这是涉及最大分离超平面的概念. 对于任何超平面(用实线表示),将其平移到两侧,直到与两侧的样本相交(用虚线表示,交点称为支撑向量,现在知道支撑名称的由来)向量机〜),如果两侧的虚线之间的距离最大,则此超平面是最大的间隔超平面. 由于最大间隔超平面通常将不同类别的样本划分为最大样本,因此泛化性能最佳.
最大间隔超平面
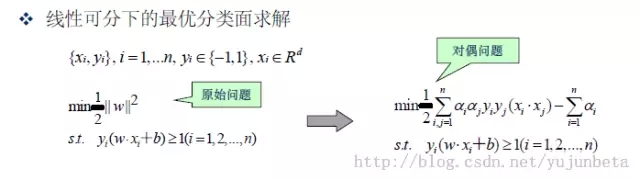
那么,SVM算法的优化实际上就是超平面间距最大值的优化,其数值公式表示如下:
SVM约束和优化目标
其中M是超平面间隔,也是优化目标. β是归一化参数,y取1或-1表示二进制分类.
优化过程涉及复杂的数学推导,因此我不赘述.
线性不可分割的情况

在上面的示例中,不同的样本已经很好地分离了,因此它们很容易被线性超平面分离. 但是,现实中的数据通常不太可能自动分离得那么好,甚至存性不可分割的关系. 例如,请使用直线将以下两个类别的点完全分开:
线性不可分割的例子
由于数据本来是线性不可分割的,所以为了使用线性超平面进行分割,必须做出一些让步,即允许一部分误差除法(这类似于以增加为代价减少方差偏差的一部分),然后进行优化该功能变为:
调整后的优化目标
C是非负调整参数,ε是松弛变量,用于执行一定程度的线性不可分割的调整. 有了这个松弛变量,样本就不必严格位于虚线一侧,并且可以具有一定的偏移量.
非线性SVM
但是,即使没有使用特许权调整,通常也无法用线性分类器来区分实际数据,此时,只能使用非线性分类器.
前面提到的PCA是将高维缩小为低维,减少特征之间的相关性,仅抽象最重要的划分-尽管维数越高r语言 支持向量机分类,低维就越复杂投影空间最高维度的空间有意义吗?
对于上面的线性不可分割的,如果将其投影在二维平面上,则它位于一维坐标轴上,例如:
可在二维平面上线性分离. png
现在容易用直线将两种类型的球分开吗?
因此,有可能将低维空间中的线性不可分问题映射到高维空间. 这是非线性SVM的核心思想.
但是,将低维数据映射到高维空间会使计算复杂得多,甚至造成维数灾难?这是SVM的另一个独到之处. 低维变量通过内核函数映射为高维变量. 高维变量主要是向量的内积计算,但可以转换为低维向量的内积计算. 换句话说,通过核函数将低维向量映射到高维空间可以解决线性不可分的问题,但不会产生额外的计算成本!
常用的核函数是多项式核函数,径向核函数等. 无需特殊研究就无需太深入了解,可以对其进行调整以解决问题. 非线性SVM的超平面投影与核函数的组合不是一条直线.
多项式核函数和径向核函数
支持向量机与逻辑回归的区别
SVM和LR都是分类器,并且连接有所不同.
SVM与LR
SVM和LR损失函数曲线
当f(x)> = 1时,损失函数为0,表示观察点正确地划分为一侧.
此外,LR的拟合由所有样本确定,而SVM的拟合实际上仅由少数支持向量确定.
以下是Andrew Ng的“机器学习”中给出的SVM和LR选择技术:
?如果特征变量的数量n相对于样本大小m较大,则选择逻辑回归或线性核函数SVM(在这种情况下,它等效于过度拟合,适用于简单逻辑回归或不具有核函数SVM);
?如果特征变量n的数量较少,则样本量m为中等,请使用具有内核功能的SVM;
?如果特征变量n的数量很小,则样本量m非常大(这种情况相当于低拟合状态),添加更多特征,然后使用逻辑回归或不具有内核功能的SVM.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-188769-1.html
-

-
李赫为
联想不思进取
-
严巨川
像这种走秀模式
 冠状病毒会传染人吗 关于中东呼吸综合征(MERS)应该了解的那些事
 运维体系 实时计算平台 人工智能给云时代的智能运维带来了哪些创新
 [学习笔记]双向链表
不被发现达不到示威效果