算法-9. 二进制搜索树
电脑杂谈 发布时间:2020-05-19 16:24:05 来源:网络整理
1. 基本思路
我们将学习符号表实现二叉排序树查找算法,该实现将链接列表插入的灵活性与有序数组查找的效率结合在一起. 具体来说,它是使用每个节点具有两个链接的二叉搜索树(每个节点在链接列表中仅包含一个链接)来有效地实现符号表,这也是计算机科学中最重要的算法之一.
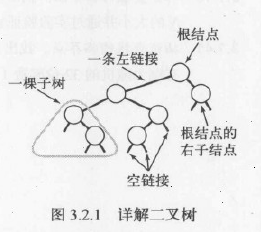
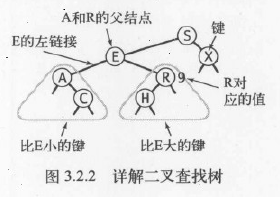
定义: 二进制搜索树(BST)是一个二进制树,其中每个节点包含一个Comparable键(以及关联的值),并且每个节点的键都大于其左子树. 右子树中任何节点的键.
2. 具体算法
/**
 * 算法3.3 基于二叉查找树的符号表
 * Created by huazhou on 2015/12/1.
 */
public class BST<Key extends Comparator<Key>, Value> {
    private Node root;  //二叉查找树的根结点
    private class Node{
        private Key key;    //键
        private Value val;  //值
        private Node left, right;   //指向子树的链接
        private int N;  //以该结点为根的子树中的结点总数
        public Node(Key key, Value val, int N){
            this.key = key;
            this.val = val;
            this.N = N;
        }
    }
    public int size(){
        return size(root);
    }
    private int size(Node x){
        if(x == null){
            return 0;
        }
        else{
            return x.N;
        }
    }

    public Value get(Key key){
        //见续1
    }

    public void put(Key key, Value val){
        //见续1
    }
}
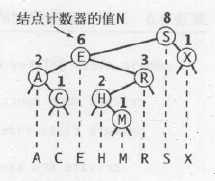
左侧链接指向由所有小于节点的键组成的二进制搜索树,右侧链接指向由所有大于节点的键组成的二进制搜索树. 变量N给出了以该节点为根的子树的节点总数. 在上述算法中实现的私有方法size()将空链接的值视为0,因此我们可以确保对于二叉树中的任何节点x,以下公式始终为真.
尺寸(x)=尺寸(x.left)+尺寸(x.right)+1
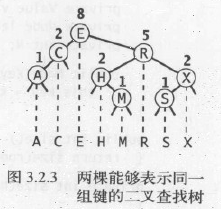
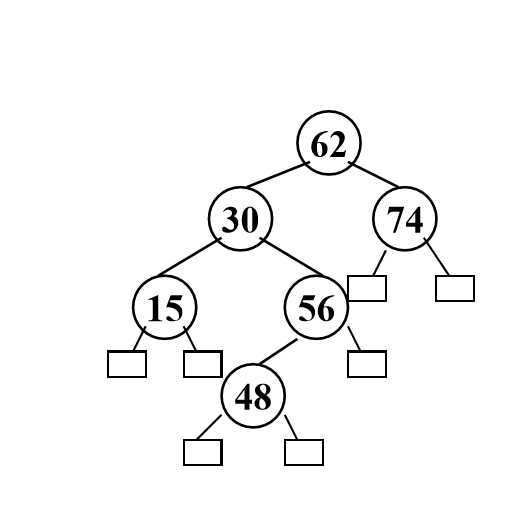
二进制搜索树表示一组键(及其对应的值),并且同一组可以由多个不同的二进制搜索树表示(如下图所示). 如果我们将二分搜索树的所有键投影到一条直线上,以确保节点左子树中的键出现在其左侧,而右子树中的键显示在其右侧,那么我们必须有序键列. 我们将利用二进制搜索树固有的灵活性,并使用多个二进制搜索树来表示同一组有序键,以实现用于构建和使用二进制搜索树的高效算法.
/**
*续1
*/
public Value get(Key key){
        return get(root, key);
    }
    private Value get(Node x, Key key){
        //在以x为根结点的子树中查找并返回key所对应的值
        //如果找不到则返回null
        if(x == null){
            return null;
        }
        int cmp = key.compareTo(x.key);
        if(cmp < 0){
            return get(x.left, key);
        }
        else if(cmp > 0){
            return get(x.right, key);
        }
        else{
            return x.val;
        }
    }
    public void put(Key key, Value val){
        //查找key,找到则更新它的值,否则为它创建一个新的结点
        root = put(root, key, val);
    }

    private Node put(Node x, Key key, Value val){
        //如果key存在于以x为根结点的子树中则更新它的值;
        //否则将以key和val为键值对的新结点插入到该子树中
        if(x == null){
            return new Node(key, val, 1);
        }
        int cmp = key.compareTo(x.key);
        if(cmp < 0){
            x.left = put(x.left, key, val);
        }
        else if(cmp > 0){
            x.right = put(x.right, key, val);
        }
        else{
            x.val = val;
        }
        x.N = size(x.left) + size(x.right) + 1;
        return x;
    }
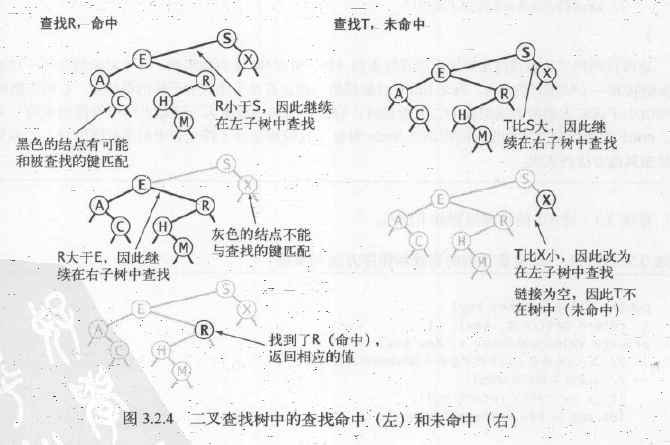
通常,在符号表中查找键可能会产生两个结果. 如果表中包含包含键的节点,我们的搜索将命中并返回相应的值. 否则,搜索将丢失(并返回null). 根据数据表示的递归结构,我们可以立即获得它. 在二叉搜索树中查找关键字的递归算法: 如果树为空,则搜索失败;如果要搜索的键和根节点的键相等,则搜索Hit,否则,我们将(递归)继续在适当的子树中搜索. 如果搜索的键较小,则选择左子树,如果键较大,则选择右子树. 算法续篇1中的递归get()方法完全实现了该算法. 它的第一个参数是节点(子树的根节点),第二个参数是搜索关键字. 该代码将确保仅由节点表示的子树将包含与搜索的键相等的节点. 与二进制搜索一样,每次迭代后搜索间隔将减半. 在二叉搜索树中,随着我们继续向下搜索,由当前节点表示的子树的大小也减小了(理想情况下,它减少了一半,但将至少有一个节点). 当找到包含搜索关键字的节点(命中)或当前子树变为空(未命中)时,此过程结束. 从根节点开始,每个节点中的搜索过程将在其子节点之一上递归扩展,因此搜索将定义树的路径. 对于命中搜索,路径在包含要搜索的键的节点处结束. 对于错过的搜索,路径的末尾是一个空链接,如下图所示.
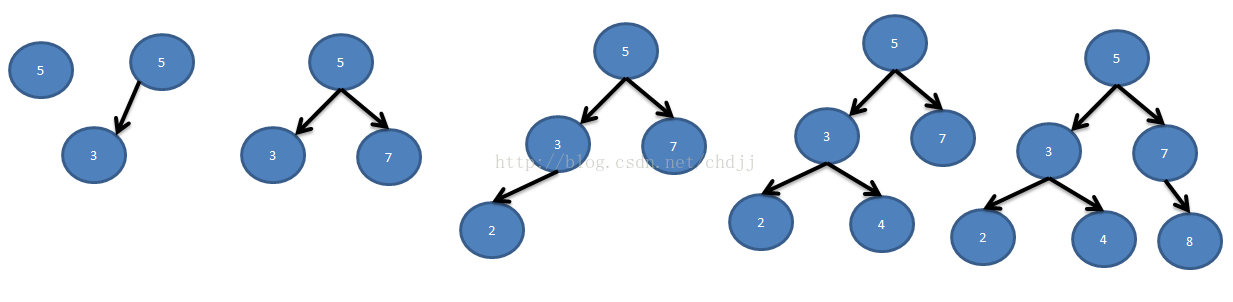
“算法续篇1”中的搜索代码几乎与二进制搜索一样简单. 这种简单性是二进制搜索树的重要特征之一. 二叉搜索树的另一个更重要的特征是插入的难度类似于搜索的难度. 当寻找一个在树中不存在并以空链接结尾的节点时,我们要做的就是将链接指向一个包含正在查找的键的新节点(请参见下图). 算法续1中递归put()方法的实现逻辑与递归搜索非常相似: 如果树为空,则返回包含键值对的新节点;如果要搜索的密钥小于根节点的密钥,我们将继续在左侧子树中插入密钥,否则在右侧子树中插入密钥.
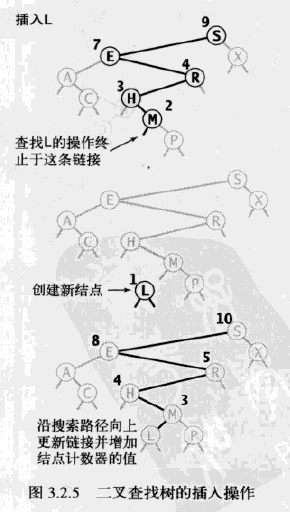
下图是对我们的标准索引用例轨迹的详细研究,向您展示了二叉树的生长方式. 新节点将连接到树底部的空链接,而树的其余部分将保持不变. 例如,插入的第一个键是根节点,插入的第二个键是根节点的两个子节点之一,依此类推. 因为每个节点包含两个链接,所以树将逐渐增长而不是收缩. 不仅如此,由于将仅访问搜索或插入路径上的节点,因此随着树的增长,树的摘要点中所访问节点数的比例将继续降低.


3. 算法分析
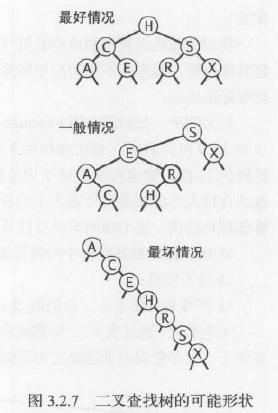
使用二分搜索树的算法的运行时间取决于树的形状,而树的形状又取决于键的插入顺序. 在最佳情况下,具有N个节点的树是完全平衡的,并且每个空链接与根节点之间的距离约为1gN. 在最坏的情况下,搜索路径中可能有N个节点. 如下所示. 但总的来说,树的形状更接近于最佳形状.
对于许多应用程序,下图所示的简单模型适用: 我们假设键的分布是(均匀)随机的,或者它们的插入顺序是随机的. 对于此模型的分析,二叉搜索树和快速排序几乎是“双胞胎”. 树的根节点是快速排序中的第一个拆分元素(左侧的键小于它,右侧的键大于它),这也适用于所有子树. 子数组的递归排序完全对应. 这使我们能够分析二叉搜索树的某些属性.


建议: 在由N个随机关键字构成的二叉搜索树中,找到匹配项所需的比较平均次数约为2lnN(约1.39lgN).
证明在给定节点处结束的匹配搜索所需的比较次数为搜索路径的深度加1. 如果我们将树中所有节点的深度加起来,就可以获得树的内部路径长度. 因此,二分搜索树中比较的平均次数是平均内部路径长度加一. 令CN为由N个随机排序的不同关键字构成的二叉搜索树的内部路径长度,搜索命中的平均成本为(1 + CN / N). 我们有C0 = C1 = 0,并且对于N> 1,我们可以根据二叉搜索树的递归结构直接获得归纳关系:
CN = N-1 +(C0 + CN-1)/ N +(C1 + CN-2)/ N + ... +(CN-1 + C0 /)/ N
N-1项表示根节点,因此树中所有N-1个非根节点的路径均加1. 该表达式的其他项代表所有子树,其计算方法与大小为N的二叉搜索树相同. 对这些表达式进行排序后,我们发现该归纳公式与我们获得的公式几乎相同进行快速排序,因此我们也可以获得CN〜2NlnN.
建议: 在由N个随机关键字构成的二叉搜索树中,插入操作和搜索未命中所需的平均比较数约为2lnN(约1.39lgN).
证明: 插入操作和搜索未命中平均需要比搜索命中更多的比较. 通过归纳法并不难.
4. 摘要
第一个命题指出,在二进制搜索树中查找随机密钥的成本比二进制搜索高39%. 第二个命题指出二叉排序树查找算法,这些额外的开销是值得的,因为插入新键的开销为log Level-这基于基于二进制搜索的有序数组的灵活性,因为其插入操作需要访问数组的次数是线性的. 与快速排序一样,比较时间的标准偏差也很小,因此N越大,公式越精确.
[源代码下载]
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-215527-1.html
-

-
王淑一
继续看好杨洋
 聚丙烯下游产业发展分析
 解决方法:如果无法在win10系统中弹出CD-ROM,该怎么办
 计算机网络最主要的功能是资源共享和通信
 沉重! 2020年知道世界大学排名发布!青贝并列14?纽约大学倒计时?
是解决途径之一