二分搜索(排序)树的剑指提供算法
电脑杂谈 发布时间:2020-05-11 11:27:04 来源:网络整理
功能:
从以上三个特征可以看出: 二叉搜索树中节点的值不允许重复,其中序遍历顺序是有序的.
二进制排序树BSTree的类型定义如下:
typedef struct {
    KeyType key;
    ... ...   // 其他数据域
} TElemType;
typedef struct BSTNode {
  TElemType  data;
  struct BSTNode  *lchild,*rchild;
}BSTNode, *BSTree;
根据二进制排序树的特点,编写算法
// 若是二叉排序树,则返回TRUE,否则FALSE
Status IsBSTree(BSTree T)
{
    if(T==NULL) return TRUE;

    //左子树,右子树,左孩子,右孩子
    Status bLeft,bRight,bChildL,bChildR;
    bLeft=bRight=bChildL=bChildR=FALSE;

    if(T->lchild==NULL || T->lchild->data.key<T->data.key){
        bChildL=TRUE;
    }
    if(T->rchild==NULL || T->rchild->data.key>T->data.key){
        bChildL=TRUE;
    }

    bLeft=IsBSTree(T->lchild);
    bRight=IsBSTree(T->rchild);

    return bLeft && bRight && bChildL && bChildR;
}
二进制排序树BSTree的类型定义如下:
typedef struct {
    KeyType key;
    ... ...   // 其他数据域
} TElemType;
typedef struct BSTNode {
  TElemType  data;
  struct BSTNode  *lchild,*rchild;
}BSTNode, *BSTree;
分析: 由于二元排序树的中序遍历是从小到大排列的,所以只有中序排序被反转后才从大到小排序(右->根->左)
// 调用visit(T->data)输出
void OrderOut(BSTree T, KeyType k, void(*visit)(TElemType))
{
     if(T==NULL) return;
     OrderOut(T->rchild,k,visit);
     visit(T->data);
     else return;
     OrderOut(T->lchild,k,visit);
}
二进制排序树的定义如下:
class TreeNode {
    int value;
    TreeNode left;
    TreeNode right;
}
分析:

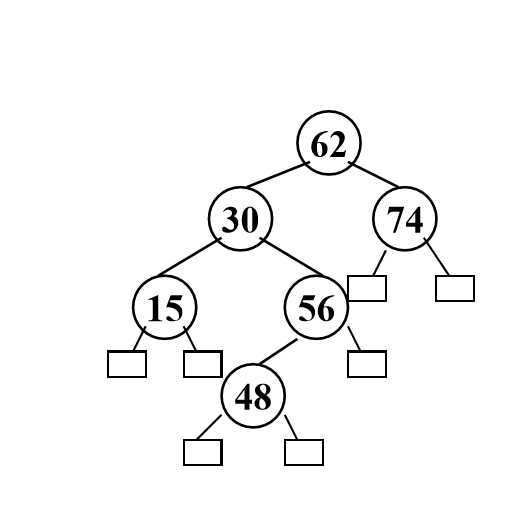
来自: 于刚说
从特性中了解: 左子树节点<根节点<右子树节点,因此根节点的后续遍历必须在末尾. 数组中的最后一个元素10在根节点10之前,小于10的元素是10之前的左子树(3〜8),在10之前,大于10的元素是10的右子树(12〜13). 左子树与5相同(右子树更短,更容易分析哈哈),已被递归遍历到右子树中第13行的末尾(12〜13),则13是根节点; 12 <13,是13左子树; 15> 13是右边的子树
从分析中可以看出,根节点之前的数组元素分为两部分: 小于根节点的连续元素是左子树,大于根节点的连续元素是右子树.
然后从数组[0]遍历二叉排序树查找 算法,当数组元素开始大于根节点(数组[x]大于根节点)时,可以在根节点(数组[root])之前划分元素])部分: 数组[0]〜数组[x-1]是左子树,数组[x]〜数组[root-1]是右子树,它们都必须大于数组[root]. 如果满足条件,则证明该节点的左右子树满足二叉搜索树的特征. 接下来,递归地遍历左右子树. 当所有非叶子节点都满足上述条件时,证明二叉树是二叉搜索树.
算法:
boolean isPostOrderArrayOfBST(int[] array, int start, int end) {
    if (array == null || start < 0 || end > array.length || start >= end) {
        return false;
    }
    int root = array[end - 1];
    int i = start;
    for (; i < end - 1; i++) {
        if(array[i] > root) {
           break;
        }
    }
    int j = i; // j开始就是右子树了
    for (; j < end - 1; j++) {
        if (array[j] < root) {
            return false;
        }
    }
    boolean left = true;
    if (i > 0) {
        left = isPostOrderArrayBST(array, start, i);
    }
    boolean right = true;
    if (i < end - 1) {
        right = isPostOrderArrayBST(array, i, end - 1);
    }
    return left && right;
}
对于此问题,如果确定它是否是二叉搜索树的预遍历序列,我们也可以使用相同的思想来解决,但是如果它是预遍历序列,则第一个“每个”元素是根节点的值二叉排序树查找 算法,但以下数组仍可以分为两部分,分别代表左右子树.

二进制排序树的定义如下:
class TreeNode {
    int value;
    TreeNode left;
    TreeNode right;
}
算法内容来自FutureFlyme的CSDN博客. 有关全文地址,请单击:
分析:
1. 将左子树构成双链表,并返回该链表的头节点(左子树最左边的节点)
2. 定位到左链表的最后一个节点(左子树最右边的节点)
3. 如果左子树链表不为空,则将当前root追加到左子树链表后
4. 将右子树构造成双向链表,并返回链表头结点(右子树最左边的节点)
5. 如果右子树链表不为空,将右子树链表追加到当前root后
6. 根据左子树链表是否为空返回的整体双向链表的头节点
//Convert函数把一个二叉搜索树变成一个有序的双向链表,返回双向链表的头结点,参数root为二叉搜索树的根节点
public TreeNode Convert(TreeNode root){
    if(root==null){//假如根节点为空,返回空
        return null;
    }
    if(root.left==null&&root.right==null){//假如只有一个根节点,则返回根节点
        return root;
    }
    //1、将左子树构造成双链表,并返回该链表头结点left
    TreeNode left=Convert(root.left);
    //2、定位到左子树链表的最后一个节点(左子树最右边的节点)
    TreeNode p=left;//创建一个临时节点P,用来遍历找到左链表的最后一个节点(左子树最右边的节点),p初始化指向做左子树的根节点,
    while(p!=null&&p.right!=null){
        p=p.right;//最终p为左子树最右边的节点
    }
    //3、如果左子树链表不为空,将当前root追加到左子树链表后
    if(left!=null){//左子树链表不为空
        p.right=root;//左子树链表的最后一个节点p(左子树最右边节点)的右指针指向当前root节点
        root.left=p;//当前root节点的左指针指向左子树链表的最后一个节点p(左子树最右边节点)
    }
    //4、将右子树构造成双链表,并返回该链表的头结点right
    TreeNode right=Convert(root.right);
    //5、如果右子树链表不为空,将右子树链表追加到当前root后
    if(right!=null){//右子树链表不为空
        right.left=root;//右子树链表的头结点right的左指针指向当前root
        root.right=right;//当前root的右指针指向右子树链表的头结点right
    }
    return left!=null?left:root;//根据左子树链表是否为空返回整个双向链表的头指针。
}
import java.util.Stack;
public TreeNode ConvertBSTToBiList(TreeNode root){
    if(root==null){
        return null;
    }
    Stack<TreeNode> stack=new Stack<TreeNode>();
    TreeNode p=root;//p为临时节点用来遍历树的节点,初始值为根节点root
    TreeNode rootList=null;//用于记录双向链表的头结点
    TreeNode pre=null;//用于保存中序遍历序列的上一个节点,即p的上一个节点
    boolean isFirst=true;//判断是否为左子树链表的第一个节点
    while(p!=null||!stack.isEmpty()){
        while(p!=null){
            stack.push(p);
            p=p.left;
        }
        p=stack.pop();//此时的p为左子树最左边的节点,
        if(isFirst){//假如是左子树链表的第一个节点
            rootList=p;//将p赋值给root节点
            pre=rootList;
            isFirst=false;
        }else{
            pre.right=p;
            p.left=pre;
            pre=p;
        }
        p=p.right;
    }
    return rootList;
}
二进制排序树的定义如下:
class TreeNode {
    int value;
    TreeNode left;
    TreeNode right;
}
分析: 由于二元排序树的中序遍历是从小到大排列的,所以只有中序排序被反转后才从大到小排序(右->根->左)
算法如下:
public TreeNode findKthBigNode(TreeNode root ,int k){
       if(root==null) { return null;}
       if(root.right!=null){ findKthBigNode(root.right,k); }
       k--; //减一表示访问了这个点
       if(k==0) return root; //当k==0时,说明已经访问了k个点,剩余0个点。该Node为第k大
       if(root.right!=null){ findKthBigNode(root.left,k); }
}
/**********
【题目】试写一非递归算法,在二叉查找树T中插入元素e。
二叉查找树的类型BSTree定义如下:
typedef struct {
  KeyType key;
    ... ...   // 其他数据域
} TElemType;
typedef struct BSTNode {
  TElemType data;
  struct BSTNode  *lchild,*rchild;
} BSTNode, *BSTree;
**********/
BSTree SearchInsertPosition(BSTree T, TElemType k)
{
    BSTNode *pos, *p;
    p = T;

    while (p)
    {
        pos = p;
        if (p->data.key == k.key)
            return NULL;
        p = (k.key < p->data.key) ? p->lchild : p->rchild;
    }

    return pos;
}
Status InsertBST_I(BSTree &T, TElemType k)
/* 在二叉查找树T中插入元素e的非递归算法 */
{
    BSTNode *new, *p;
    new = (BSTNode*)malloc(sizeof(BSTNode));
    if (!new)
        return OVERFLOW;
    new->data = k;
    new->lchild = new->rchild = NULL;

    if (!T)
        T = new;
    else
    {
        p = SearchInsertPosition(T, k);
        if (!p)
        {
            free(new);
            return FALSE;
        }
        if (k.key < p->data.key)
            p->lchild = new;
        else
            p->rchild = new;
    }

    return TRUE;
}
----------------------------------------------------------------------
/* 这个方法没实现功能
Status InsertBST_I(BSTree &T, TElemType k)
{
    BSTree p=T;
    while(1){
        if(NULL==p){
            BSTree s;
            s=(BSTNode*)malloc(sizeof(BSTNode));
            if(NULL==s) return OVERFLOW;
            s->data=k; s->lchild=NULL; s->rchild=NULL;
            p=s;
            return TRUE;
        }
        if(k.key < p->data.key) {p=p->lchild ; continue;}
        else if(k.key > p->data.key) {p=p->rchild; continue;}
        else return FALSE;//k.key==p->data.key
    }
} */
参考: 据说可以阅读本文的人都是聪明人!
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-206285-1.html
-

-
园部启一
等上面看穿了
-
能登麻美子
棒
 2015年氪估值排行榜top500_2015游戏钱排行榜_中国公司估值排行榜
 FPS低的原因是什么
 在N个元素中查找第k大的元素,有什么方法最快?
 这篇文章完美解决Win7声卡驱动安装失败的问题!
不要瞎说