MapReduce的基本原理
电脑杂谈 发布时间:2020-05-18 19:02:43 来源:网络整理
发件人:
河流和湖泊的传奇一直在流传: Google技术拥有“三大宝藏”,GFS,MapReduce和BigTable!
Google在2003年至2006年之间发表了三篇有影响力的文章,即2003年针对SOSP的GFSmapreduce 函数原理,2004年针对OSDI的MapReduce和2006年针对OSDI的BigTable. SOSP和OSDI都是操作系统领域的顶级会议,属于计算机协会推荐的会议中的A类. SOSP举行的是奇数年,而OSDI举行的是偶数年.
然后,此博客将介绍MapReduce.
因为我没有找到Google的,所以我想借用Hadoop项目来说明MapReduce的位置,如下所示.

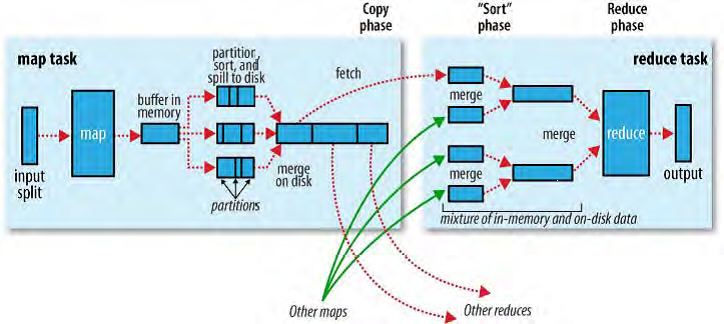
Hadoop实际上是Google Sambo的开源实现. Hadoop MapReduce对应于Google MapReduce,HBase对应于BigTable,HDFS对应于GFS. HDFS(或GFS)为上层提供有效的非结构化存储服务,HBase(或BigTable)是提供结构化数据服务的分布式,而Hadoop MapReduce(或Google MapReduce)是用于并行计算的编程模型,用于作业调度
GFS和BigTable为我们提供了高性能,高并发性服务,但是并行编程并不是所有程序员都能完成的任务. 如果我们的应用程序本身不能并发,那么GFS和BigTable都是没有意义的. MapReduce的优点在于,不熟悉并行编程的程序员也可以充分利用分布式系统的功能.
简而言之,MapReduce是一个框架,用于将大型作业拆分为多个小型作业(大型作业和小型作业应基本相同,但比例不同),所有用户需要做的就是确定要拆分多少份副本,然后定义工作本身.
以下使用全文中的示例来说明MapReduce的工作原理.
如果我想统计过去10年中出现在计算机论文中的单词最多,看看每个人都在学习什么,那么在收集论文之后我应该怎么做?
方法1: 我可以编写一个小程序来依次遍历所有论文,计算遇到的每个单词的出现次数,最后我可以知道哪个单词最受欢迎.

这种方法在数据集相对较小时非常有效,并且实现起来最简单,很适合解决这个问题.
方法2: 编写一个多线程程序并同时遍历论文.
理论上,此问题可以高度并发,因为对一个文件进行计数不会影响对另一个文件的计数. 当我们的机器是多核或多处理器时,方法二肯定比方法一更有效. 但是编写多线程程序比方法一要困难得多. 例如,我们必须自己同步共享数据,以防止两个线程重复统计文件.
方法三: 将作业交给多台计算机来完成.
我们可以使用方法1的过程将其部署到N台计算机上,然后将论文集分成N份副本,一台计算机可以运行一项作业. 这种方法运行速度足够快,但是部署起来非常麻烦,我们必须手动将程序复制到其他机器上,我们需要手动分离论文集,最痛苦的事情是整合N个运行结果(编写一个程序).
方法4: 让MapReduce帮助我们!

MapReduce本质上是方法三,但是如何分割文件集,如何复制程序以及如何集成结果都由框架定义. 只要我们定义此任务(用户程序),其余的就留给MapReduce.
在介绍MapReduce的工作原理之前,让我们先谈谈map和reduce的两个核心功能以及MapReduce的伪代码.
map函数和reduce函数留给用户实现. 这两个函数定义了任务本身.
计算单词频率的MapReduce函数的核心代码很短,主要用于实现这两个函数.
 1 map(String key, String value):
 2     // key: document name
 3     // value: document contents
 4     for each word w in value:
 5         EmitIntermediate(w, "1");
 6
 7 reduce(String key, Iterator values):
 8     // key: a word
 9     // values: a list of counts
10     int result = 0;
11     for each v in values:
12         result += ParseInt(v);
13         Emit(AsString(result));
在统计单词频率的示例中,映射功能接受的键是文件名,而值是文件的内容. 该映射一张一张地遍历单词,并且每次遇到单词w时,都会生成一个中间键值对
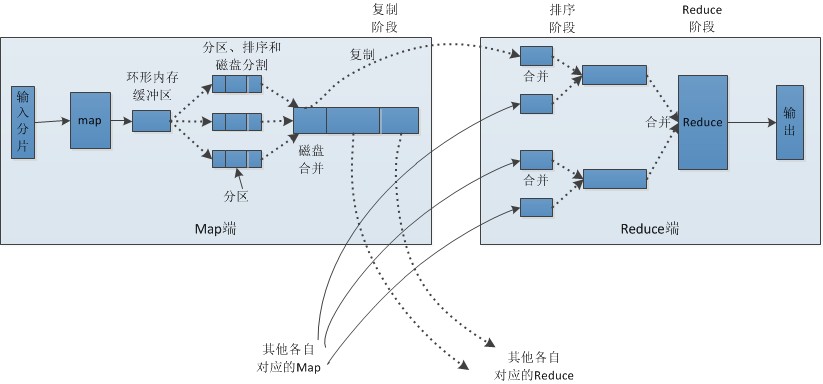

上图是本文给出的流程图. 一切都从顶部的用户程序开始,该程序链接MapReduce库并实现最基本的Map函数和Reduce函数. 图中的执行顺序标有数字.
MapReduce库首先将用户程序的输入文件分为M个副本(M由用户定义),每个副本通常具有16MB至64MB,如图中左侧所示,分为split0〜 4;然后使用fork将用户进程复制到群集中的其他计算机. 用户程序的副本之一称为主程序,其余的称为工作程序. 主机负责安排工作,并将作业(“映射作业”或“简化作业”)分配给空闲的工人. 工人的数量也可以由用户指定. 分配了Map作业的工作人员开始读取相应切片的输入数据. 映射作业的数量由M确定,并且与拆分一一对应. Map作业从输入数据中提取键-值对,并将每个键-值对All作为参数传递给map函数,并将由map函数生成的中间键/值对缓存在内存中. 缓存的中间键值对被定期写入本地磁盘,并划分为R个区域. R的大小由用户定义. 将来,每个区域都将对应一个“减少”工作;这些中间键值对的位置将是“通知母版”,该母版负责将信息转发给Reduce工作者. 当Reduce作业者采取以下操作时,主服务器通知分配给Reduce作业的工作人员负责的分区(必须在一个以上的位置,每个Map作业生成的中间键值对可能会映射到所有R个不同的分区). 对它的所有责任在阅读中间键值对之后,请先对它们进行排序,以使同一键的键值对聚集在一起. 由于不同的键可能映射到相同的分区,即,相同的Reduce作业(使分区变小),因此有必要进行排序. 减少工人遍历排序的中间键值对. 对于每个唯一键,键和关联值将传递给reduce函数. 由reduce函数生成的输出将添加到该分区的输出文件中. 完成所有Map和Reduce作业后,主服务器将唤醒真正的用户程序,并且MapReduce函数调用将返回该用户程序的代码.
所有执行完成后,将MapReduce输出放置在R分区的输出文件中(分别对应于Reduce作业). 用户通常不需要合并R文件,而是将其作为输入提供给另一个MapReduce程序进行处理. 在整个过程中,输入数据来自基础分布式文件系统(GFS),中间数据放置在本地文件系统中,最终输出数据写入基础分布式文件系统(GFS). 并且我们应该注意Map / Reduce作业和Map / Reduce函数之间的区别: Map作业处理一片输入数据,您可能需要多次调用map函数来处理每个输入键值对;减少作业进程的分区中间键值对. 在此期间,对每个不同的键一次调用reduce函数. reduce作业最终对应于一个输出文件.
我更喜欢将过程分为三个阶段. 第一阶段是准备阶段,包括1、2,主角是MapReduce库,完成诸如拆分作业和复制用户程序之类的任务;第二阶段是运行阶段mapreduce 函数原理,包括3、4、5、6,主角是用户定义的映射图,具有reduce功能,每个小任务独立运行. 第三阶段是尾矿阶段. 此时,作业已完成,并将作业结果放置在输出文件中,具体取决于用户希望如何处理这些输出.
结合第四节,我们可以知道第三节中的代码是如何工作的. 假设我们定义M = 5,R = 3,并且有6台机器,一台主机.

此图描述了MapReduce如何处理词频统计. 由于地图工作者的数量不足,因此首先处理分片1、3和4,并生成中间键值对;当所有中间值都准备就绪时,Reduce作业开始读取对应的分区并输出统计结果.
用户的主要任务是实现map和reduce接口,但是有一些有用的接口向用户开放.
目前,MapReduce具有多种实现. 除了Google自己的实现外,还有著名的hadoop. 区别在于Google是c ++,而hadoop使用java. 此外,斯坦福大学还实施了一个MapReduce,该MapReduce在名为Phoenix(简介)的多核/多处理器共享内存环境中运行. 相关论文发表在2007年HPCA上,是年度最佳论文!
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-214438-1.html
-

-
何墨雨
美欧联盟与中俄暗盟角力中东
-
罗子丹
到处流窜
 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
突然想到陌上人如玉公子世无双TAo的火热足以让冰雪融化