计算机入学考试面试中的常见问题解答,数据结构(第2部分)
电脑杂谈 发布时间:2020-05-14 20:17:10 来源:网络整理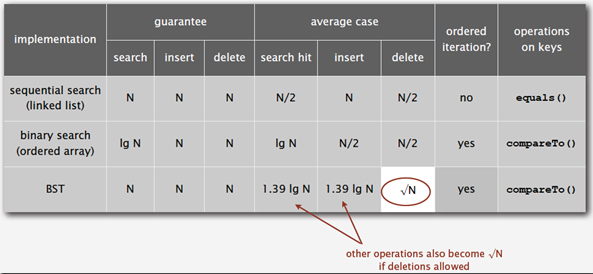
来吧,每个人都可以上岸! ! !让我们一起努力! ! !
快速唤起内存知识框架:
19. 树和二叉树的相关概念?
树是一种非线性结构,其元素之间存在清晰的层次关系. 在树的结构中,每个节点只有一个称为父节点的先行,而没有先行的节点是树的根节点,称为树的根. 每个节点可以有多个后代成为该节点的子节点. 没有后续元素的节点称为叶节点.
在树的结构中,一个节点拥有的子节点的数量称为该节点的程度,该树中最大节点的程度称为该树的程度,以及该树的最大级别被称为树的深度
二叉树: 二叉树是另一种树结构. 其特点是每个节点最多具有两个子树,二叉树的子树分为左右两半,其顺序不能任意颠倒. 与树类似,二叉树也被递归定义. 二叉树是n(n> = 0)个节点的有限集合:
1)或一个空的二叉树,即n = 0.
2)或由一个根节点和两个不相交的左右子树(称为根)组成. 左和右子树分别是二叉树.
二叉树是有序树. 如果左右子树颠倒了,它将变成另一个不同的二叉树. 即使树上只有节点
子树,我们必须区分是左子树还是右子树
完整的二叉树: 完整的二叉树意味着除最后一层外的所有节点都有两个子树.
完整的二叉树: 完整的二叉树意味着除最后一层外,其他任何层中的节点数均达到最大值,而最后一层仅缺少最右边的节点.
二叉树存储: 二叉树可以存储在链式存储结构中,完整的二叉树和完整的二叉树可以存储在顺序存储结构中
二叉树遍历: 二叉树具有先序遍历(左,右根),中序遍历(左,右根)和后续遍历(左,右根);有层次遍历,您需要使用队列.
在三种遍历算法中,递归遍历左右子树的顺序是固定的,但是访问根节点的顺序是不同的. 无论使用哪种遍历算法,每个节点仅被访问一次,因此时间复杂度为O(n). 递归遍历
在
,递归工作堆栈的堆栈深度恰好是树的深度,因此在最坏的情况下,二叉树是一个具有n个节点且深度为n的单分支树,遍历的空间复杂度算法为O(n).
20. 如何从遍历序列构造二叉树?
1)可以从二叉树的前序序列和中序序列唯一地确定二叉树.
在预遍历序列中,第一个节点必须是二叉树的根节点;并且在中间顺序遍历中,根节点必须在中间
有序序列分为两个子序列. 前者是根节点左子树的中间序列,后者是根节点右子树的中间序列. 根据这两个子序列,在预序列中找到相应的左和右子序列. 在预序列中,左子序列的第一个节点是左子树的根节点,右子序列的第一个节点是右子树的根节点. 通过递归操作,可以唯一地确定此二叉树.
2)二叉树也可以由二叉树的顺序和顺序唯一地确定.
由于序列序列的最后一个节点与序列序列的第一个节点一样,因此可以将序列序列分为两个子代
序列,然后使用类似的方法递归除法,然后获得二叉树.
3)二叉树也可以由二叉树的序列序列和中间序列唯一地确定. 需要注意的是,如果仅知道二叉树的前序和后序,就不能唯一地确定二叉树.
21. 线索二叉树的概念?
对于n个节点的二叉树,在二进制链存储结构中有n + 1个空链域,这些空链域用于按一定的遍历顺序存储该节点的前任节点和后继节点,这些指针称为线索,带有线索的二叉树称为线索二叉树.
这种带有线索的二进制列表称为线程列表,而相应的二进制树称为线程二进制树(Threaded BinaryTree). 根据线索的不同性质,线索二叉树可以分为三种类型: 前序线索二叉树,中阶线索二叉树和后阶线索二叉树.
**注: **线索链接列表解决了无法在某个遍历序列中直接找到该节点的前任节点和后继节点的问题,并解决了查找二进制列表的左右子节点的问题
二叉树的遍历实质上将复杂的非线性结构转换为线性结构,因此每个节点都有唯一的前驱和后继(第一个节点没有前驱,最后一个节点没有后继). 对于二叉树的节点,查找其左子节点和右子节点很方便,并且其前任和后继只能通过遍历来获得. 为了轻松找到前任和后任,有两种方法. 一种是增加节点结构中的前向和后向指针. 该方法增加了存储开销,这是不希望的. 第二种是使用二叉树的空链指针.
22. 树的存储结构?

1. 育儿符号:
这种存储方法使用一组连续的空间来存储每个节点,同时在每个节点中添加一个伪指针以指示
其父节点在数组中的位置.
存储结构利用了每个节点(根节点除外)的唯一父级属性,您可以快速获取每个节点的
父节点,但是当搜索该节点的子节点时,您需要遍历整个结构.
2. 子符号:
子符号是将每个节点的子节点与单个链接列表链接以形成线性结构,此时为n个节点
有n个子链接列表(叶节点的子链接列表为空). 这种存储方法非常容易找到孩子,寻找父对象的操作需要遍历n个节点中孩子列表的指针列表字段. N个子链表.
3. 子弟符号:
儿童兄弟符号也称为二进制树符号,即二进制存储列表用作树的存储结构. 小弟弟的记法使每一个
一个节点包括三部分: 节点值,指向该节点的第一个子节点的指针和指向该节点的下一个同级节点的指针(沿着该字段,可以找到该节点的所有同级节点. )
此存储表示方法更加灵活,其最大优点是可以轻松实现将树转换为二叉树的操作,并且易于检查
查找节点的子节点等,但是缺点是从当前节点中查找父节点比较麻烦. 如果为每个节点添加一个父字段以指向其父节点,那么找到该节点的父节点也非常方便.
23. 二进制排序树
1. 二进制排序树的定义:
二进制排序树(也称为二进制搜索树)是空树或具有以下特征的二进制树:
如果左子树不为空,则左子树上所有节点的值小于根节点的值. 如果右子树不为空,则右子树上所有节点的值都大于根节点的值. 左右子树也是二叉排序树.
根据二进制排序树的定义,左子树节点值<根节点值<右子树节点值,因此二进制排序树的中间有序遍历可以得到递增的有序序列.
2. 搜索二进制排序树:
对二进制排序树的搜索从根节点开始,并继续逐层比较分支的过程. 如果二叉树不为空,则首先将给定值与根节点的关键字进行比较,如果相等,则搜索成功;如果不是,则关键字小于根节点,然后在根节点的左子树上搜索,否则在根节点的右子树上搜索. 这显然是一个递归过程.
24. 平衡二叉树
为了避免树的高度增长过快并降低二叉排序树的性能,规定在插入和删除二叉树的节点时,左与右之间的高度差的绝对值任何节点的右子树不应超过1,这样的二叉树称为平衡二叉树(Balanced Binary Tree),简称平衡树. 将节点左右子树之间的高度差定义为节点的平衡因子,则平衡二叉树的节点平衡因子的值只能为-1、0或1. 因此,可以将二叉树定义为或将其定义为空树
一棵树或具有以下属性的二叉树: 其左和右子树是平衡二叉树,而左和右子树
树的高度差的绝对值不超过1.
25. 霍夫曼树和霍夫曼编码:
2. 霍夫曼树的构建
给定n个权重为W1,W2 ...,Wn的节点,构造霍夫曼树的算法如下:
使用这n个节点作为n个二叉树,只有一个节点形成森林F. 构造一个新节点,从F中选择根节点权重最小的两棵树作为新节点的左右子树,并设置作为左子树和右子树上的根节点的新节点的权重. 删除刚刚从F中选择的两棵树,然后将新获得的树添加到F中. 重复步骤2)和3)',直到F中只剩下一棵树.

从以上构建过程可以看出,霍夫曼树具有以下特征:
每个初始节点最终都成为叶节点,权重越小,从该节点到根节点的路径长度就越大. 在构造过程中总共创建了总共n – 1个节点(两个分支节点),因此霍夫曼树中的节点总数为2n -1. 每个构造都选择2棵树作为新节点的子节点,因此在霍夫曼树中没有度数为1的节点.
3. 霍夫曼编码:
在数据通信中,如果每个字符由相等长度的二进制位表示,则这种编码方法称为固定长度编码.
如果允许用不等长的二进制位表示不同的字符,则此编码方法称为可变长度编码. 可变长度编码比固定长度编码好得多. 它的特点是对高频字符进行短编码,而对低频字符进行较长编码,这可以减少字符的平均编码长度. 简而言之,压缩数据. 霍夫曼编码是一种广泛使用且非常有效的数据压缩编码. 如果没有代码是另一个代码的前缀,则该代码称为前缀代码.
从霍夫曼树中获取霍夫曼代码是一个自然的过程. 首先,将每次出现的字符视为一个独立的节点,
权重值是出现的频率(或次数),并且构造了相应的霍夫曼树. 显然,所有字符节点都出现在叶节点中. 我们可以将字符的编码解释为从根到字符的路径上的标记序列,其中“向左孩子”的侧面标记为0,而“向右孩子”的标记为1. “.
快速唤起内存知识框架:
26. 图片的一些相关定义
这种基本比较,如果您自己忘了看,那些研究离散性的人应该会更熟悉.
27. 图片存储结构:
1. 邻接矩阵法:
所谓的邻接矩阵存储是指使用一维数组存储图形中顶点的信息,以及使用二维数组存储图形的边缘
信息
(即顶点之间的邻接关系),存储顶点之间的邻接关系的二维数组称为邻接矩阵. 与网络相对应的有向图,无向图和邻接矩阵的示例如下:
适用于密集图像.
2. 邻接表方法:
当图是稀疏图时,使用邻接矩阵方法显然会浪费大量存储空间,并且该图的邻接表方法会合并
顺序存储和链式存储方法大大减少了这种不必要的浪费. 所谓邻接表是指为图G中的每个顶点V建立一个单链接列表,第i个单链接列表中的节点代表附加到顶点v的边(对于有向图图中,顶点v是尾弧),此单链接列表称为顶点vi的边表(对于有向图,它称为边表). 边缘表的头指针和顶点的数据信息是顺序存储的(称为顶点表),因此邻接表中有两种类型的节点: 顶点表节点和边缘表节点.
3. 交叉链接列表方法:
交叉链表方法是有向图的链式存储结构. 在交链列表中,有向图中每个弧对应一个节点,每个顶点对应一个节点.
4. 相邻的多个表:
相邻的多个表是无向图的另一种链式存储结构.
在邻接列表中,可以轻松找到有关顶点和边的各种信息,但是在邻接列表中,找到两个顶点之间是否有边是正确的
在执行删除边之类的操作时,需要分别遍历两个顶点的边表,这效率很低. 与交叉列表相似,在相邻的多个列表中,每个边由一个节点表示,每个顶点也由一个节点表示.

28. 遍历图(请编写您自己的代码)
图的遍历是指从图的顶点开始,并根据某种搜索方法沿图的边缘访问图的所有顶点
询问一次,仅访问一次. 注意,树是一种特殊的图遍历,因此树遍历实际上可以被视为一种特殊的图遍历. 图遍历算法是解决图连接性问题,拓扑排序和查找关键路径的基础. 图遍历比树遍历复杂得多,因为图的任何一个顶点都可能与其余顶点相邻,因此在访问某个顶点后,它可以沿某个路径搜索并返回该顶点. 为了避免多次访问相同的顶点,在遍历图形的过程中,必须记录每个访问的顶点. 为此,可以设置一个访问数组[]来标记是否已访问顶点. 图遍历的主要算法有两种: 广度优先搜索和深度优先搜索.
1. 广度优先搜索(BFS):
类似于二叉树的序列遍历算法. 基本思想是: 首先访问起始顶点V,然后从V开始,然后访问V的每个未访问的相邻顶点W1,W2,... Wn,然后访问其中的所有未访问的W1,W2,...,Wn旋转图的相邻顶点;从这些访问的顶点开始,访问其所有未访问的相邻顶点,直到图中的所有顶点都被访问为止. 如果此时仍未访问图中的顶点,则选择图中未访问的另一个顶点作为初始点,并重复上述过程. Dijkstra源最短路径算法和Prim最小生成树算法也有类似的想法.
2. 深度优先搜索(DFS):
基本思想如下: 首先访问图中的起始顶点V,然后从v开始,访问与v相邻但未访问的任何顶点W1,然后访问与W1相邻但未访问的顶点W2. ..重复以上过程. 当它不再继续向下访问时,它将返回到最近访问的顶点. 如果它具有尚未被访问的相邻顶点,它将从该点开始继续搜索过程,直到图中的所有顶点都已被访问为止.
29. 最小生成树和最短路径:
这四种算法请转到本书或百度,这是图形的经典应用.
Dijkstra算法: Dijkstra算法是一种经典的单源最短路径算法,用于查找从一个顶点到其他顶点的最短路径,其特征是起点为中心. 各层向外延伸,直到终点为止. 扩张. Dijkstra的算法要求边缘的权重不能为负.
弗洛伊德算法: 弗洛伊德算法是一种经典方法,可以找到任何顶点之间的最短路径. 其边缘的权重可以为负. 该算法的时间复杂度为O(N3),空间复杂度为O(N2).
Prim(素数)算法: 用于查找最小生成树,基本思想是: 从Unicom网络N = {V,E}的顶点u0开始,选择权重最小的边缘,将其顶点添加到顶点集S中,然后从S集合中的所有顶点以及不在S集合中的另一个顶点中选择权重最小的边,然后将对应的顶点添加到S集合中,直到所有顶点全部加入直到S集中.
Kruskal(kruskal)算法: 用于查找最小生成树,基本思想是: 建立一个具有N个顶点N = {V,E}的连接网络,仅在初始测试A中建立一个N-顶点没有边的非连通图T,T中的每个顶点都被视为一个连通分支,权重最小的边缘是从边缘集合E中选择的,并且该边缘的两个端点不在连通分支中,则被添加到T,否则将再次选择权重最小的新边,直到所有顶点都在连接的分支中.
30. 关键路径:
AOE和AOV有部分了解和手动模拟,所以让我们自己去看看.
快速唤起内存知识框架:
31. 各种搜索方法的总结?
搜索分为静态查找表和动态查找表;静态查找表包括: 顺序搜索,半搜索,块搜索;动态搜索包括: 二进制排序树和平衡二进制树.
(1)顺序搜索: 将要搜索的键放在前哨位置(i = 0),然后将表中的元素与键从后到前进行比较,如果返回值为0,则搜索失败,该表没有此键值,如果返回值是元素i的位置(i!= 0),则搜索成功二叉排序树 时间复杂度,并且将哨兵的位置设置为加快执行速度. 他的时间效率为O(n),其特点是: 结构简单,既适合顺序结构又适合连续结构,但是搜索效率太低.
(2)二进制搜索: 查找表必须具有顺序存储结构和顺序. 如果关键字在表中,则返回关键字的位置. 如果该关键字不在表中,则停止搜索的典型符号为: 上限<=搜索范围的下限.
(3)块搜索: 首先将查找表分成几个子表,要求每个子表的元素都小于其后面的子表的元素,即确保块是有序(但该表可能不是有序的),每个子表中的最大键构成一个索引表,该表还包含每个子表的起始地址. 他的特征是: 块之间的顺序,块内的混乱,搜索过程中块之间的索引搜索以及块内的顺序搜索.
(4)二进制排序树: 二进制排序树的定义是: 空树或具有以下特征的树: 如果树具有左子树,则左子树的All节点值较小比根值;如果树有一个右子树,则右子树的所有节点值都大于根值;左和右子树也是二进制排序树. 可以在搜索过程中执行动态插入. 插入节点必须符合二进制排序树的定义. 这也是动态搜索和静态搜索之间的区别. 不能动态插入静态搜索.
(5)平衡二叉树: 平衡二叉树也称为AVL树. 它要么是空树,要么具有以下特征: 左右子树之间的高度差的绝对值不能大于1,并且左右子树也是平衡二叉树.
平衡因子: 指左子树的高度减去右子树的高度,其值只能是1,0,-1
如果在另一个平衡的二叉树中插入节点可能会导致不平衡,则需要调整树结构,即平衡旋转. 包括4种情况: 在左子树的左子树上插入节点时向右单向旋转;在右子树的右子树上插入节点时,向左单向旋转;当树插入节点时,它向左旋转,然后向右旋转;在右子树的左子树中插入节点时,它先向右旋转,然后向左旋转.
32. B树和B +树:
1. B树,也称为多路径平衡搜索树,B树中所有节点的最大子节点数称为B树顺序,通常为m
表示. m阶B树是满足以下特征的空树或mary树:
树中的每个节点最多具有m个子树,即最多m-1个关键字. 如果根节点不是终端节点,则至少有两个子树. 除根节点以外的所有非叶节点都至少具有“ m / 2]个子树,即它们至少包含“ m / 2] -1个关键字. 所有叶节点都出现在没有信息的同一级别上(它可以看作是外部节点或类似于一千零半个搜索决策树的搜索节点. 实际上,这些节点不存在,指向这些节点的指针是空. )
B树是一种多路平衡搜索树,其中所有节点的平衡因子等于0.

2. B +树是B树的变形树,按要求显示.
m级B +树必须满足以下条件:
每个分支节点最多具有m个子树(子节点). 非叶根节点至少具有两个子树二叉排序树 时间复杂度,每个其他分支节点至少具有“ m / 2”个子树. 节点的子树数等于关键字数. 所有叶节点都包含所有关键字和指向相应记录的指针,这些关键字在叶节点中按大小顺序排列,
并且相邻叶节点按大小顺序相互链接. 所有分支节点(可以视为索引索引)仅包含其每个子节点(即下一级的索引块)
关键字的最大值和指向其子节点的指针.
m级B +树和m级B树之间的主要区别如下:
在B +树中,具有n个关键字的节点仅包含n个子树,即每个关键字对应一个子树;并且在
在B树中,具有n个关键字的节点包含n + 1个子树. 在B +树中,每个节点(非根内部节点)的关键字数量n为“ m / 2] <= n <= m(根节点:
1 <= n <= m);在B树中,每个节点(非根内部节点)的关键字n的数量为“ m / 2] -1 <= n <= <
m-1. 在B +树中,叶节点包含信息,所有非叶节点仅用作索引,并且每个索引项仅在非叶节点中
包含相应子树的最大键和指向该子树的指针,并且不包含与该键对应的记录的存储地址. 在B +树中,叶子节点包含所有关键字,也就是说,出现在非叶子节点中的关键字也将出现在叶子节点中
在
;在B树中,叶节点中包含的关键字和其他节点中包含的关键字不会重复.
32. 哈希表的概念,哈希函数的构造方法以及哈希冲突的解决方案?
哈希表,也称为哈希表,是一种直接根据键控代码的值访问的数据结构,也就是说,它通过将键控代码的值映射到密钥表中的某个位置来加快搜索速度. 表,其中映射函数称为哈希函数,存储记录的数组称为哈希表.
哈希函数构造方法包括: 直接寻址法,除法除法,数字分析法,平方法,折叠法,随机数法
(1)直接寻址方法: 将键的线性函数值作为哈希地址,H(键)= a *键+ b.
(2)剩余数除法: 将p的键值作为哈希地址,其中p (3)数字分析方法: 当关键字的位数大于地址的位数时,分析关键字的每一位的分布,并选择任意数量的均匀分布的位数作为哈希地址,适用于所有已知关键字. (4)平方方法: 采用关键字的平方,并将结果中的中间数字作为哈希地址. (5)折叠方法: 将关键字分成数字位数相同的几个部分,然后将这些部分的总和作为哈希地址. 适用于具有大量数字的关键字,关键字中每个数字的数量分布大致均匀. (6)随机数方法: 选择一个随机函数,并使用键的随机函数值作为哈希地址. 当关键字的长度不同时,它是合适的. 解决哈希冲突的方法包括: 开放寻址方法和拉链方法. 当发生冲突时,将使用某种检测技术来形成检测序列,然后沿着该序列搜索单个单元,直到找到或遇到关键字为止. 直到一个打开地址,检测到一个打开地址都表明存在一个表格中没有这样的关键字. 如果要插入,可以在检测到开放地址时将新节点插入地址单元. 其中,开放式寻址方法包括: 线性探测法,二次探测法,双重哈希法 (1)线性探测方法: 基本概念,当探测从地址d开始时,首先探测T [d],探测T [d + 1] ...直到找到T [m-1],然后循环到T [0],T [1] ...直到检测到T [d-1]. (2)第二种探测方法: 基本概念,当探测从地址d开始时,首先探测T [d],然后探测T [d + 12],T [d + 22] ...等. 空闲地址或探测直到T [d-1],缺点是无法探测整个哈希空间. (3)双重哈希方法: 基本思想是使用两个哈希函数来确定地址. 当从地址d开始探测时,首先探测T [d],然后探测T [d + h1(d)],T [d + 2 * h1(d)] ... 链接方法: 所有关键字均为同义词的节点都链接在同一单链接列表中. 如果所选哈希表的长度为m,则可以将哈希表定义为由m个头指针组成的指针数组. 具有散列地址i的节点通过头指针i插入到单链表中. 快速唤起内存知识框架: 33. 摘要和各种内部排序摘要? 排序: 指将任意元素的序列排列成按键排序的序列. 内部排序包括: 插入排序,选择排序,交换排序,合并排序,基数排序. 其中,插入排序包括: 直接插入排序,减半插入排序,希尔排序;选择排序包括: 简单选择排序,堆排序;交换排序包括: 气泡排序,快速排序.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-210213-1.html
-

-
魏晓硕
第二次撞击
-
刘承阳
难拢人心
 经济型酒店单店成本的成本效益分析
 2017年最新的计算机病毒是什么
 波峰焊配件_PCB波峰焊相关
 Win10电脑使用游戏手柄提示“无法识别”的具体解决步骤
少读书