基础入门: 如何用自然语言分析大型数据集?
电脑杂谈 发布时间:2020-05-06 13:05:20 来源:网络整理
【IT168评论】NLP是一项令人兴奋的前沿研究. Siri,Alexa和Google Home之类的产品正在努力提高其自然语言处理能力. 为了使用NLP,我们必须了解此过程的工作原理,可以做什么以及如何将原始数据转化为最终产品.

大数据中蕴藏着许多见解. NLP可以通过教学机器分析大型数据集来获得这些见解. 本文的作者对NLP进行了一些基本介绍,希望能帮助该领域的新学生.

从基础知识开始
我们正在研究的自然语言处理方法是将日常文本或语音转换为计算机可以理解的内容. 从文本中,我们可以提取一些信息,例如专有名词,情绪词甚至人的说话风格. 此过程的基础是使用Unicode字符将文本分为单词,短语,句子和其他语言描述,例如标记化和词义化. 在建立使用语言之前,我们必须首先将其分解并分析其组成部分,以便我们了解其工作原理.
划分确定范围
如果是整篇文章,我们很难确定它想要表达的具体含义,即使是对于人类,也很难在短时间内快速确定其中心思想. 您能否理解文本的一般含义,还是需要仔细了解文本的主要内容?这是宏观和微观理解之间的区别. 由于NLP受成本和时间因素的限制,因此某些级别的处理不可用. 一旦了解了目标范围,就可以继续提取.
提取处理内容
对宏的理解使我们能够弄清楚正在处理的文档的要点是什么. 我们可以使用它来分类,提取主题,汇总文档,语义搜索,重复检测,关键词或关键词提取. 如果是微观的理解,我们可以使用处理过程来读取文本本身,并提取缩写及其含义或人的名字,即公司的专有名称. 在微观理解中,词序非常重要,只有在词序正确的情况下,才能获得正确的理解.

保留数据源
从特定文档中提取数据时,我们应确保我们知道数据的来源并加以保留. 目前,有一个指向源文档的链接,可以节省大量时间. 此跟踪可以帮助快速修改可能出现在文本中的错误. 如果更新了其中一个原始文档,则只需最少的处理即可将更改反映到提取的信息中,从而节省时间和处理成本.
人工训练

开发NLP的最好方法是教它听取人类的反馈. 通过这些人工数据进行培训是所有人工智能的基础. 为了使NLP系统朝我们想要的方向发展,我们需要将相应的数据传递给它. 这部分需要大量数据才能达到预期的效果. 幸运的是,可以在网络上搜索一些开放的数据集,然后选择适合您的训练的数据集自然语言分析,否则将适得其反.
错误反馈机制
连续的质量分析对于确保NLP起作用并适应周围的环境至关重要. 创建NLP基本上是在教计算机如何从错误中学习以及如何识别反馈以改善自身. 就大数据而言,它具有很多洞察力. 通过开发NLP自然语言分析,您可以为计算机提供一项非常合适的任务,同时教会其在提取过程中像人一样思考.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-200573-1.html

 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
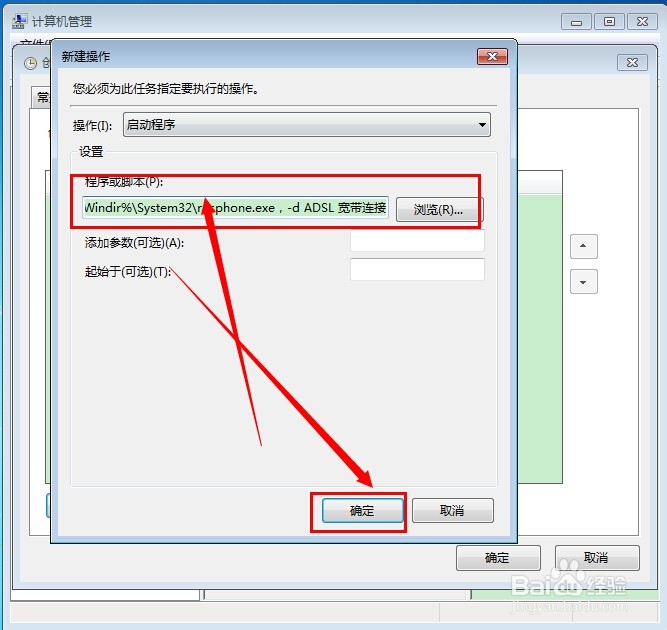 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
现在打我们是鱼