高维数据的聚类注释
电脑杂谈 发布时间:2020-04-27 00:07:40 来源:网络整理
在高维空间中会出现一些奇怪的现象. 其中之一是数据点与坐标系原点之间的距离增加到维D的平方根. 我们可以看到下面的图片

点到中心点在不同维度上的距离
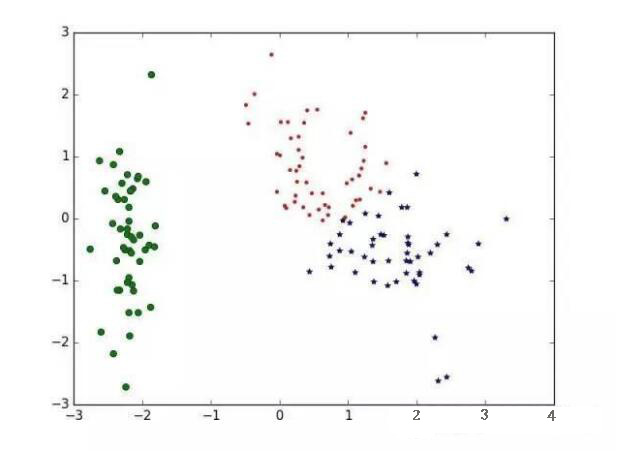
这意味着在欧几里德空间中计算距离的公式不再适用.
集群假设和局限性
尽管尺寸已对聚类造成了某些障碍,但是许多聚类方法在低纬度下效果不佳. 通常,我们可以将聚类分为以下四种类型:

基于图的聚类
基于点的集群
层次聚类

基于密度的聚类
分层(内聚)聚类对数据中的噪声过于敏感. 基于质心的聚类(KNN,高斯混合模型)只能处理具有球形或椭圆形对称性的聚类. 基于图的聚类(Spectral,SNN-cliq,Seurat)对于高维数据可能是最健壮的,因为它使用了图上的距离,例如高维聚类分析,与欧几里得距离相比,共享邻居的数量. 有意义的.
但是,要构造图形,此方法仍使用欧几里得距离. 此外,必须通过“分辨率”超参数隐式指定簇的数量. 更改超参数很容易导致更少或更多的簇,这在某种程度上是任意的高维聚类分析,因此非常不令人满意,因为没有明显的方法定义自动调整超参数的目标函数. 在所有群集算法中,只有基于密度的算法(均值移位,DBSCAN,OPTICS,HDBSCAN)才允许群集,而无需指定群集数. 该算法通过向高密度点移动的滑动窗口进行工作,也就是说,他们发现有很多密集区域.

如何调整HDBSCAN的超参数
聚类是一个无监督的学习问题,这意味着我们不了解基本事实(聚类数),也无法使用交叉验证来优化算法的超参数. 但是,有一种方法可以自动优化HDBSCAN的超参数.
HDBSCAN(分层DBSCAN)是一种基于密度的强大聚类算法,它是: 1)与聚类的形状无关,2)无需指定聚类的数量,3)对于不同的密度,聚类坚固. 另单元的速度相对较快,对于每个单元,它报告分配给群集的概率. 可以将分配概率较低的单元格部分用作优化minPts的目标函数,从而提供最佳的簇数.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-190099-1.html
-

-
范鹏程
是啊
 海运中的ORC、LLA、HLA、GRI和EBS是什么附加费?
 Win10解决热血无赖闪退停止工作的方法有哪些?
 东莞市空气质量监测点已达38个,城镇街道(公园)已全部覆盖
 win8旗舰版系统下载安装失败怎么办?两种解决方法
加快建设