视觉分析高维数据集的聚类结果
电脑杂谈 发布时间:2020-04-27 00:05:03 来源:网络整理
黄山大学学报,2011年黄山大学Vo1.13,NO.5,2011年10月5华数据集的可视化分析华丹阳(安徽农业大学信息与计算机学院,安徽合肥230036)数据挖掘是当今数据挖掘研究的重要领域,关键问题是如何对高维数据的聚类结果进行高效和直观的分析. 为了解决这个问题,首先使用数据聚合树(DA树)作为表示高维数据集的数据结构,然后对数据集应用新的聚合算法(CLUK算法)以获得聚类分析的结果. ,然后构建一个可视化平台(Hvis). 最后,在该可视化平台上使用平行坐标法对聚类结果进行了可视化分析,获得了令人满意的可视化结果. 关键词: 高维数据集聚类结果;可视化CLC编号: TP391文档标识码: A文章编号: 1672-447X(2011)05-0024-03类别: 划分方法,但是对于各种聚类通过类分析算法获得的聚类结果缺乏有效的视觉分析方法. 当前,大多数现有的聚类分析算法仅计算聚类分析的结果并向用户提供聚类统计信息. 用户很难通过这些统计信息来判断聚类的结果是否理想,因此如何分析高维数据聚类结果的有效聚类成为关键.

某些点可以表示空间中的位置. 更一般而言,记录的每个属性都对应一个维度. 群集是将数据分为几个组或集合的过程. 通过聚类,同一集合中的对象具有高度相似性,而不同集合中的对象则具有明显的差异. 如何有效地分析高维数据的聚类结果已成为数据挖掘和可视化领域的研究项目: 2011安徽农业大学校长青年基金(2011zr011)关于作者: 华丹阳(1984-),安徽淮南,助理教授,安徽农业大学博士研究方向是应用和数据可视化. DA树的数据聚合部分使用CLUK算法获得的聚类分析结果的最大值和最小值. 正文部分本身是一个子树,并且特定的数据值存储在叶节点上. 数据是按自下而上的顺序构造的. DA DA树与现有数据结构之间的最大区别在于,它是专门为聚类算法设计的树结构. 在其每个非叶节点上高维聚类分析,都有一个数据数据聚合区域(Data Aggregation Area),它们所属的数据点的聚类信息的详细记录,例如其数量,维数,最大值,最小值每个维度等,如图10000000所示的数据输入系统,为方便操作,将100个条目组织为一个组(元组).
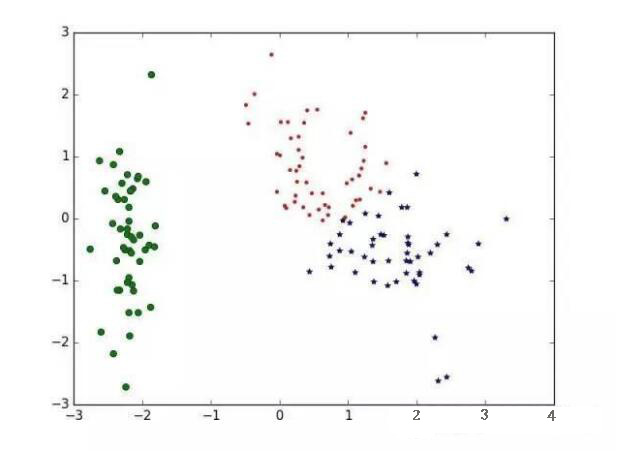
我们使用CLUK聚类算法对数据集执行聚类分析. 具体结果如图所示. 这样做的目的是在执行聚类分析操作时,我们可以识别聚类分析的目标对象以促进聚类. 阅读和处理课程信息. CLUK聚类算法为高维数据集构建可视化平台: 对于高维数据集的Hvis,我们构建了可视化平台Hvis(高分辨率可视化). Hvis是用于以语言编写的高维数据集的软件平台. 它主要使用OpenGL Gtk [10]技术来实现用户图开发. 该平台的工作流程是首先将平台连接到服务器,通过TCP / IP网络访问后端管理系统DBMS,然后加载通过CLUK聚类分析获得的实验结果,最后选择特定的可视化组件进行测试结果显示在屏幕上. 整个平台具有良好的可伸缩性,用户可以轻松地将自己设计的组件嵌入到平台中以添加新的可视化功能. 提出了一种新的基于DA树数据结构的聚类算法CLUK算法,并将其应用于高维数据集,获得了令人满意的聚类结果. 3.1算法简介该算法是一种基于数据节点分布密度的自下而上的聚类算法. 它大致可分为以下几步: 步骤1: 深度深度遍历DA树,根据节点的分布密度定律,找出所有可能的组件,对节点进行聚类,并将其放入聚类的候选列表中.

步骤2: 对于候选列表中的每个节点,测试它是否可以与同一集群中的其他候选节点合并. 对于合并后的候选列表中的每个节点,将其扩展到A群集. 可视化分析聚类结果DELLLATITUDE D800,CPU 2.0GHz,Linux 2.6.9 Gentoo. 用于实验的原始数据来自美国统计局于2005年发布的PUMS(公共用途微数据样本文件). 我们首先对原始数据进行预处理,然后将3.2应用于通过CLUK聚类分析获得的实验结果. 我们使用基于密度的平行坐标方法[11]在Hvis可视化平台上进行可视化分析. 我们将整个高维数据集的聚类结果投影到二维坐标平面上(参见图3),其中轴标记每个维,Y轴标记该维中的聚类结果值. 聚类结果的可视化分析26黄山大学学报2011参考文献: [1] Hanan Samet. 基础metricdata结构stEdition. 美国: McGraw-Hill,2006年: 23-25. [2]黄章. 扩展-均值算法聚类大型数据集类别值DataMining KnowledgeDiscovery,1998,14(6): 283-304. [3] Karypis,Hanweiwei和Kumar.CHAMELEON: 一种使用动态建模的分层聚类算法[J]. 计算机应用,1999,6(1): 68-75. [4]赫克曼. 贝叶斯网络知识发现[J]. 进步知识发现数据挖掘,1996,10(3): 273-305. [5]王伟,杨建,Muntz.STING: 统计信息网格方法的空间数据挖掘[J]. 计算机科学,1997年2月,23(4): 1-13 [6] CIACCIA,PATELLA和ZEZULA.M-树: 一种有效的访问方法相似性度量空间VeryLarge(VLDB),1997,10(2): 426-435 . [7] Jan Li.Harrington. 面向对象的设计显然,我们可以看到平行坐标中整个高维数据集的聚类结果. 为了形成一条折线,需要使用Year(1961 5)的State维维数.

从这些视觉信息中,我们可以得出结论,在加利福尼亚州,1961年至1969年之间建造的住宅在整个房地产市场中所占的份额最大. 同样,通过我们构建的Hvis可视化平台,我们可以从聚类结果中直观地分析很多有价值的信息. 解释[M] .1版. 美国: 麦格劳·希尔,2000年: 3-5. St [8]华丹阳. 一种适用于大数据集的新聚类算法设计[J]. 阜阳师范学院学报,2011,28(1): 67-71. [9] Dave Shreiner.OpenGL编程指南: LearningOpenGL [M] .3版正式指南. 美国: 麦格劳·希尔,2009年: 23-26. [10]克劳斯·安德鲁. 基金会stEdition.USA: McGraw-Hill,2007: 14-17. [11] R. Moustafa,E.Wegman. 使用平行坐标的多变量连续数据[J]. 图形大型数据集,2006年8月,11(1): 143-156. 针对高维数据可视化研究领域的关键问题,以美国住房数据统计为例,采用CLUK方法获取聚类分析结果,通过建立Hvis可视化对聚类分析结果进行可视化. 平台,并使用基于密度的平行坐标法进行分析,获得满意的实验结果.
主编: 胡德明可视化聚类结果高维数据集华丹阳VCCDivision,合肥大学技术学院学校信息部,河西230009)摘要: 聚类高维数据集重要领域的数据挖掘. 关键问题可以有效地可视化聚类结果. 问题,代表高维数据集的第一个DA-Tree(数据聚合树)数据结构高维聚类分析,新聚类算法(CLUK)数据集,称为Hvis的可视化框架使用基于密度的平行坐标设置可视化聚类结果. 关键字: 高维数据集聚类结果;可视化
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-190096-1.html

 易烊千玺在大学借书不还?中戏图书馆透露了消息,粉丝们
 广东新型腐竹机小型腐竹机价格新丰宾馆腐竹机
 分布式存储环境 中国科技大学培养了鄂维南等57位AI与大数据领域的专家
 华为畅享7和荣耀V9Play对比哪个好?看看你喜欢哪款?
完全可以接受