爬行动物的基本原理和概念
电脑杂谈 发布时间:2020-04-16 21:02:57 来源:网络整理
爬虫在网络中爬网时,Web上的网页集合被视为从给定起点开始的有向图
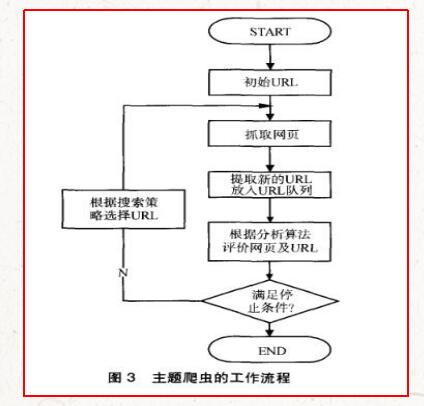
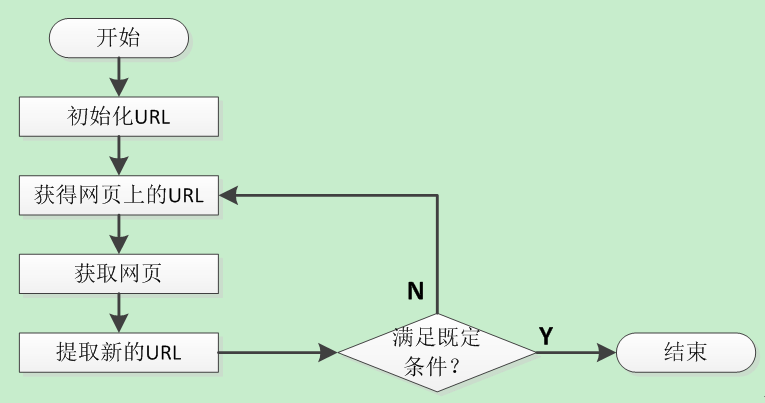
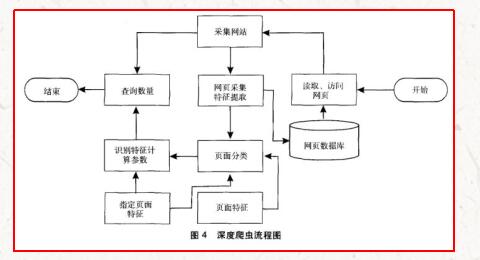
从URL开始,然后根据某些策略遵循网页中的链接. 通常使用以下遍历算法:
1,深度优先算法
该算法意味着网络搜寻器将从选定的超链接开始,跟随一行,并逐个访问每个链接
在处理此问题之前,请先询问直至到达该行的叶节点,即不包含任何超链接的HTML文件
此行之后,转到下一个起始页面,并继续访问新起始页面中包含的链接之一,直到
到达叶节点. 这种方法的优点是Web搜寻器的设计相对容易.
2. 广度优先算法

广度优先算法意味着Web搜寻器将首先搜寻所有在起始页面中包含链接的页面,然后选择
其中一个链接页面继续搜索此页面中链接的所有页面. 该搜索方法是通过
实现的
使用网络爬虫的最佳方法,因为它的特征易于实现网络爬虫 工作原理,并且可以避免陷入无尽的深度
在层分支中,可以并行处理Web爬网程序,从而提高其爬网速度.
3. 启发式搜索算法
从人工智能开始,即首先从获得的领域知识来评估要访问的链接的值,以推断出字母
分配兴趣资源,然后根据某些原则选择具有最大价值的链接以进行下一次搜索
到达目标节点的最佳路径,删除不良节点,并保留这些良好节点. 该算法主要用于主题搜寻器.
分布式Web搜寻器可以看作是多个集中式Web搜寻器的组合. 分布式系统中的每个部分
Point可以视为集中式Web搜寻器. 分布式爬虫和集中式爬虫的工作原理基本相同,但之前是
人们需要每个节点共同协作才能完成网页的抓取,因此分布式抓取工具的效率要比集中抓取的效率高
臭虫. 分布式搜寻器系统结构有很多类型网络爬虫 工作原理,它们以不同的方式工作. 对于典型的分布式爬虫系统
它的所有节点不仅从网页获取URL,而且从其他节点接收URL. 然后是节点
分析与该URL对应的网页,并将不属于爬网范围的URL转发给其他节点.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-177997-1.html
-

-
姬弗湟
人民海
 如何使用U盘安装系统,教您如何使用U盘引导进入PE安装系统
 如何解决Win10中不安装字体的问题?
 图1是常染色体遗传疾病的谱系.
 电脑报警声的含义有哪些?电脑的硬件问题出自哪里?
还是蒋委员长说的对