开始处理PDF(2)
电脑杂谈 发布时间:2020-04-02 06:02:21 来源:网络整理其中pdfdraw可用于转换图像
$ pdfdraw -o out%d.png in.pdf
注意: mupdf不支持Mac OS
xpdf是一个免费的PDF工具包,包括文本解析,图像转换,html转换等.
下载此软件包后,您可以获得一系列工具:
pdfdetach
pdffonts
pdfimages
pdfinfo
pdftohtml
pdftopng
pdftoppm
pdftops
pdftotext
从名称中,您可以大致看到每个工具的用处.
## 使用pdftopng将pdf转换成png
$ pdftopng in.pdf out-prefix
我经常遇到一种情况,当读取pdf文件时,我会收到一个错误: 文件已加密

但是如何在没有密码的情况下解决呢?
使用qpdf强制解密,某些情况下可以成功解密,但某些情况下可能无法成功解密.
qpdf是支持命令行的pdf工具
$ qpdf --decrypt in.pdf out.pdf
$ pdfcpu decrypt encrypted.pdf output.pdf
输入密码后,您可以使用密码进行解密:
$ unipdf decrypt -p pass -o output.pdf input.pdf
经常遇到某些情况,例如识别文件是否为pdf文件,识别pdf中的文本,识别pdf中的图片等.
Xpdf用于解析pdf中的文本,然后使用一些字符串操作或正则表达式进行业务分析.
$ pdftotext input.pdf output.txt
$ unipdf extract text input.pdf
使用API解析pdf文本,请参考unipdf github示例
上面是先解析pdf文本,然后根据业务进行处理
另一种方法是根据坐标位置解析pdf. 这种方法更加灵活和通用. 它使用pdflib / tet
## 输入一组坐标,即可按照坐标解析pdf中的数据
$ tet --pageopt "includebox={{38 707.93 243.91 716.93}}" input.pdf
可以通过tet将坐标分析为pdf,以获得一个tetml文件,该文件包含坐标信息:
$ tet --tetml input.pdf
当然,您还可以通过其他方式获取pdf中数据的坐标信息,例如nodejs等.
注意: pdflib / tet是付费软件,但根据官方文档,tet提供基本功能,您无需购买许可证即可处理少于10页或少于1M的pdf文件
pdflib / tet为多种语言提供命令行工具和SDK支持,例如C / C ++ / Java / .NET / Perl / PHP / Python / Ruby / Swift,但目前不支持Go语言,因此适用于gopher当前只有两个选项: CLI或CGO
在计算机上打开某些pdf文件后,它们会正常显示,但是代码检测异常,例如尝试使用第三方库在Go中解析(损坏的)pdf:
import (
    "fmt"
    "github.com/rsc.io/pdf"
)
func main() {
    filePath := "path/to/your/broken.pdf"
    _, err := pdf.Open(filePath)
	if err != nil {
		fmt.Println("open pdf failed,err:", err.Error())
		return
	}
}
我将在运行后得到以下结果:
open pdf failed,err: malformed PDF: cross-reference table not found: {5 0 obj}<</Contents 6 0 R /Group <</CS /DeviceRGB /S /Transparency /Type /Group>> /MediaBox [0 0 595.27600098 841.89001465] /Parent 3 0 R /Type /Page>>
计算机正常打开,但是程序读取错误!
这时,如果您尝试在计算机上打开pdf,然后将其另存为新的pdf文件,然后使用代码进行测试,您将发现它已得到修复!
太好了,问题解决了!
等等,如果我有1,000个pdf文件,是否必须一个一个地打开它们并将其另存为?如何忍受呢?因此,如果有批量修复功能,那就太好了
在互联网上寻找了很长时间,我大概得到了三种解决方案:
这里我仅验证了第三种方法是可行的pdflib设置字体,这里我使用mupdf-0.9-linux-amd64版本进行验证
下载软件包后,您将获得以下可执行文件之一: pdfclean
$ pdfclean broken.pdf repaired.pdf
+ pdf/pdf_xref.c:160: pdf_read_trailer(): cannot recognize xref format: '%'
| pdf/pdf_xref.c:481: pdf_load_xref(): cannot read trailer
\ pdf/pdf_xref.c:537: pdf_open_xref_with_stream(): trying to repair
从输出中,mupdf试图对其进行修复.
获取新的pdf文件后,尝试使用以前的Go代码打开它,这是正常的
剩下的就是写一个bash脚本,批量修复,达到目的!
有时,您需要使多个pdf文本的字体保持一致,因此您必须分析pdf中使用的字体. 目前,您可以使用xpdf / pdffonts进行字体分析.
$ pdffonts input.pdf
name                                 type              encoding         emb sub uni object ID
------------------------------------ ----------------- ---------------- --- --- --- ---------
NimbusSanL-Regu                      CID TrueType      Identity-H       yes no  yes     10  0
NimbusSanL-Bold                      CID TrueType      Identity-H       yes no  yes     20  0
这是一个C ++开源库,支持创建pdf,合并pdf,图像水印文本操作等.
对于gopher,要使用此库,您需要封装一层CGO代码.
这是Go中实现的pdf库,可用于读取pdf信息,例如读取pdf内容/页面/字体等...有关详细信息,请参阅文档
引入了如此多的第三方库,它仅仅是各种各样的东西,每一个都有自己的魔力. 大多数库中有些功能是重复的. 具体使用中会遇到什么问题取决于实际情况.
我希望这些结论对读者有帮助
参考:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-160902-2.html

 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
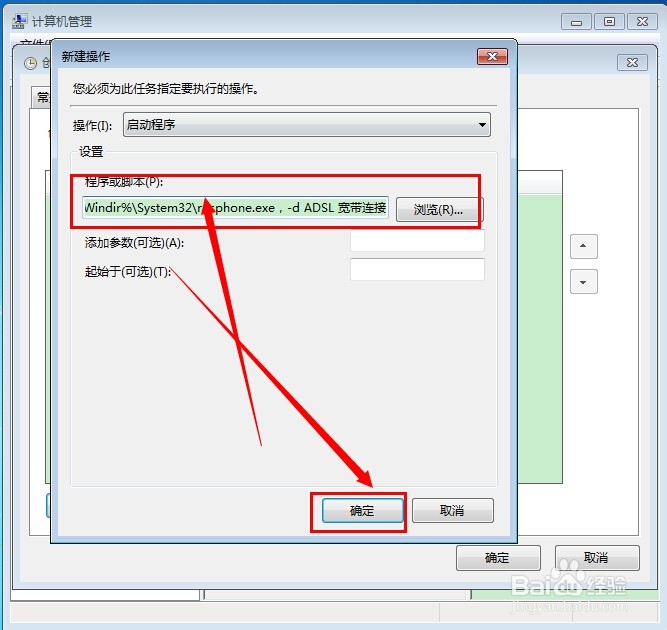 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
因为妓者和粉仔没有什么区别