OLTP和OLAP之间是什么关系?
电脑杂谈 发布时间:2020-03-30 04:02:12 来源:网络整理
在定义它们之间的关系之前,请简要了解它们的定义.
事务处理(OLTP)转换为事务处理olap系统和oltp系统,而OLAP(分析处理)转换为分析处理. 从字面上看,OLTP用于事务处理,而OLAP用于分析处理. 从操作的角度来看,OLTP主要用于添加,删除和修改数据,而OLAP用于查询数据.
从应用程序中查看OLTP和OLAP之间的区别.
OLTP主要用于记录某些类型的业务事件的发生,例如购买行为. 当行为发生时,系统会记录谁在何时何地执行了什么. 这样的一行(或多行)数据将增加. 更新和处理中数据的删除和修改方法需要很高的实时性能和强大的稳定性,以确保及时成功地更新数据. ERP,CRM,OA等常见业务系统属于OLTP.

当数据积累到一定程度并且我们需要对过去发生的事情进行摘要分析时,我们需要取出过去生成的数据进行统计分析,并从中获取所需的信息公司. 决定提供支持,这一次是在做OLAP.
由于OLTP生成的业务数据分散在不同的业务系统中,因此OLAP通常需要将不同的业务数据收集在一起以进行统一和全面的分析. 这时,有必要根据业务分析要求进行相应的数据清理. 存储在数据仓库中,然后数据仓库提供统一的OLAP分析. 因此,我们经常说OLTP是应用程序,而OLAP是数据仓库应用程序. 下面是一个简短的比较.

因此,可以认为OLAP与OLTP之间的关系是OLAP依赖于OLTP,因为OLAP分析的数据是由OLTP生成的,它也可以视为OLTP的扩展,从而允许OLTP生成该过程数据可据以找到价值.
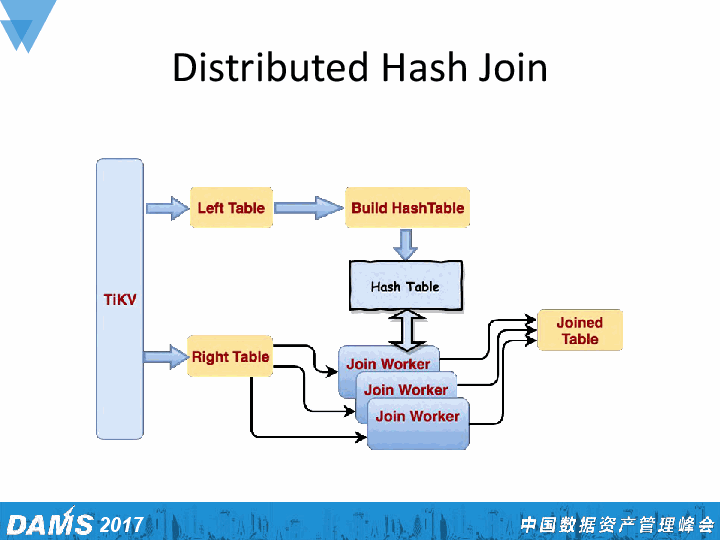
在这里我们介绍更多的OLAP
OLAP分析的分类: ROLAP和MOLAP
OLAP分析分为两种类型: 关系分析处理(ROLAP)和多维分析处理(MOLAP). 它们的设计概念和解决方案场景各不相同,各有千秋.
ROLAP是传统关系,MPP分布式和基于Hadoop的Spark / Impala的代表. 它能够同时连接详细数据和摘要数据,并根据用户需求实时计算数据并返回给用户,因此用户使用起来相对灵活,可以实时选择维组合计算.

由于使用了实时计算技术,因此ROLAP的缺点也很明显-当计算数据量达到一定水平或并发数达到一定水平时,肯定会出现性能问题(例如领导者会给您安排很多工作,仅靠您自己无法正确完成所有事情并回答领导者. )
传统关系,例如Teradata,Oracle等,由于传统体系结构的可伸缩性较差,因此对硬件的要求非常高. 当计算的数据量达到一千万或十亿时,计算就会出现延迟,使用户无法及时获得响应,更不用说增加并发了.
MPP分布式(GreenPlum / GBase / Vertica)解决了一些可伸缩性问题,并且对硬件设备的要求略有降低(仍然存在某些硬件要求). 在支持的数据量(GB,TB级别)上已大大提高. 当群集具有数百或数千个节点时,将存在性能瓶颈(添加更多节点,性能提升不会很明显),并且容量扩展的成本也很昂贵.
基于Hadoop的Spark / Impala对部署硬件的要求非常低(可以使用公用服务器,但是它主要依靠内存计算来减少响应时间,因此内存要求很高)olap系统和oltp系统,并且需要节点扩展成本比较高. 较低,但是当计算量达到某个级别或并发达到某个级别时,它无法在几秒钟内响应,并且容易出现诸如内存溢出之类的问题.

MOLAP分析由Cognos,SSAS,Kylin等代表. 设计概念是预先计算客户的需求并以结果的形式保存(例如,一个表分为10个维度和5个度量,然后,客户提出的需求将是2到10倍,然后可能会预先计算并存储很多可能性. 在客户提出需求之后,您可以找到相应的结果并将其返回(就像您将领导明天安排的任务)先做,明天您将告诉领导者,您安排了相应的任务后就完成了工作. )其特点是,当达到需求时它会很快返回(因此MOLAP非常适合常见的固定分析方案),并且在相同资源下支持的数据量更大. 支持更多的并发性,缺点是表的维度和复杂性越高,所需的磁盘存储空间就越大,并且构建多维数据集需要花费一些时间.
Cognos和SSAS是早期的传统产品. Cognos限制了多维数据集的大小(即,限制了表的复杂性),而SSAS多维数据集受到单台计算机容量的限制,这需要专用的服务器进行存储.
Apache Kylin是具有先进技术的成熟产品,是中国人对Apache社区做出的第一个顶级开源项目. 它基于hadoop框架,多维数据集以分片的形式存储在不同的节点上. 多维数据集的大小不受服务器配置的限制,因此具有良好的可伸缩性和较低的服务器要求,并且在容量扩展方面非常便宜. 另外,为了控制整个多维数据集的大小,Kylin为客户提供了建模的能力,即用户可以根据自己的需求预先构建模型的尺寸和尺寸组合,并过滤掉一些不必要的尺寸和组合,从而达到减小尺寸的目的,减少磁盘空间的使用.
Kylin的企业产品,即Kyligence的产品,不仅在性能和功能方面进行了很多优化,而且极大地提高了稳定性. 它还提供了智能建模功能,可以满足用户需求. 在此前提下,大大减少了磁盘空间的浪费.
总而言之,从可伸缩性的角度来看: Kylin = Impala / Spark> MPP>传统;从硬件需求来看,传统> MPP> Impala / Spark> = Kylin;从响应效率来看,响应效率随数据量和并发数量的不同而变化,但是可以确定,要计算的数据量越大,并发用户数越大,则预响应越多. 在相同的资源下,计算得到的响应效率将变得更加明显.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-157301-1.html
-

-
张献
而后在回头来消灭is可是没想到is大有打遍全天下之势
-
-
牛勇正
#吴亦凡##挑战者吴亦凡#
 Rising Security Assistant软件的屏幕截图
 闪回错误? 2条提示教你重新安装Win10应用程序商店程序
 渲染场系统软硬件配置方案
 启动时如何设置Win7自动连接到宽带? 引导时Win7自动宽带连接
王八蛋的美国佬