分布式计算框架 MapReduce
电脑杂谈 发布时间:2019-07-27 20:21:08 来源:网络整理MapReduce属于一种编程模型,用于数据集(大于1TB)的并行运算。
概念"Map(映射)"和"Reduce(归约)",是它们的主要思想,都是从函数式编程语言里借来的,还有从矢量编程语言里借来的特性。
它极大地方便了编程人员在不会分布式并行编程的情况下,将自己的程序运行在分布式系统上。
当前的软件实现是指定一个Map(映射)函数,用来把一组键值对映射成一组新的键值对,指定并发的Reduce(归约)函数,用来保证所有映射的键值对中的每一个共享相同的键组。
在学习MapReduce之前我们需要准备好Hadoop的环境,也就是需要先安装好HDFS以及YARN,环境的搭建方式可以参考我之前的两篇文章
main: readfile : 读取文件,进行任务分发 ,分发到三个相同的计算线程 ,只是通过不同的chan来 传递任务(这里的任务就是统计一行字符的每个单词出现的次数)。网站剖析最根本的使用就是监控网站的运营形态,搜集网站日常发生的各类数据——点击流数据、运营数据、用户数据等,并经过统计这些数据生成各类网站剖析的报表,对网站的运营形态停止零碎地展示,从点击次数、阅读次数、用户数的变化趋向,到比拟新老用户比率、页面流失率和目的的完成率,数据协助运营者从多角度察看网站的情况能否良好。来到网页下载:试用社区版本,下载的文件如下:接着下来就是安装了:安装完成,体验一下c++开发:新的vs带有很多游戏开发,还有a...。
例如,我现在有一个test.txt,文件内容如下:
hello world
hello hadoop
hello MapReduce
举个例子,假设你有一个文件,每行有一个单词,你想知道每个单词在文中出现的次数。2、假设某个网站每天有超过10亿次的页面访问量,出于安全考虑,网站会记录访问客户端访问的ip地址和对应的时间,如果现在已经记录了1000亿条数据,想统计一个指定时间段内的区域ip地址访问量,那么这些数据应该按照何种方式来组织,才能尽快满足上面的统计需求呢,设计完方案后,并指出该方案的优缺点,比如在什么情况下,可能会非常慢。main: readfile : 读取文件,进行任务分发 ,分发到三个相同的计算线程 ,只是通过不同的chan来 传递任务(这里的任务就是统计一行字符的每个单词出现的次数)。
hello 3
world 1
hadoop 1
MapReduce 1
以上这就是一个词频统计的例子。
wdcp闭源免费,不少人用,简单易用,个人用来建站还行,支持在centos,redhat,ubuntu系统上搭建apache,nginx,nginx+apache/mysql/php环境,官网有一键安装脚本安装简单 官网: 安装: 二、★★★ lumanager闭源有免费版,看起来貌似不错,用过的也说还行,支持在freebsd,debian,ubuntu,centos系统上搭建apache,nginx(tengine),nginx+apache/mysql/php环境,官网有一键安装脚本安装简单 官网: 安装: 三、★★ amh开源免费,简单易用,不过刚出不久,可能还有不少问题,支持在debian,ubuntu,centos系统上搭建nginx/mysql/php环境,官网有一键安装脚本安装简单 官网: 安装: 四、★ easypanel闭源有免费版,貌似用的自家的web服务器(kangle)不是我们熟悉的apache,lighttpd,nginx之类,不太推荐,支持在centos,windows系统上搭建kangle/mysql/php环境,官网有一键安装脚本安装简单 官网:。除了避免项目运行激活时触发脚本执行,我们还可以通过sleep() 延迟脚本功能执行,比如开机后五分钟开始执行脚本具体功能,代码如下:。网鱼网站广告管理系统是基于asp+access程序构架,采用bootstrap界面功能内核仿照百度广告系统,主要功能是方便站长对网站广告的管理,别是html静态页面时,广告更新很方便,只需更新js脚本无需更新全站代码,简单、...。
数据中心作为数据的产生、传输与储存中心,随着数据量的快速爆发,同时伴随着云计算、大数据、人工智能等技术的发展推动对于数据分析的需求,特别是大数据的出现需要将海量非结构化数据进行分析处理提取有用信息,it资源能力向集群计算转变,直接推动云服务基础设施发展。研究基于众核的大数据计算模型、分布式处理框架、易用的编程环境,开发高效、可扩展的大数据计算系统。利用gpu来训练深度神经网络,可以充分发挥其数以千计计算核心的高效并行计算能力,在使用海量训练数据的场景下,所耗费的时间大幅缩短,占用的服务器也更少。
又回到我们上面所说到的词频统计的例子,在实际工作中很多场景的开发都是在WordCount的基础上进行改造的。例如,要从所有服务器的访问日志中统计出被访问得最多的url以及访问量最高的IP,这就是一个典型的WordCount应用场景,要知道即便是小公司的服务器访问日志通常也都是GB级别的。
大体来看就是一个拆分又合并的过程,所以MapReduce是分为map和Reduce的。最重要的是分布式并行计算 框架,要清楚这一流程都是分布式并行的,每个节点都不会互相依赖,都是相互独立的。
MapReduce作业会被拆分成Map和Reduce阶段

其实简单来说这也是一个输入输出的流程,要注意的是在MapReduce框架中输入的数据集会被序列化成键/值对,map阶段完成后会对这些键值对进行排序,最后到reduce阶段中进行合并输出,输出的也是键/值对
OutputFormat:输出最终的处理结果
8.6在(图1)中轻触“母线参数”按钮, 显示(图4)画面,触摸对应参数区域可以对其进行设置更改。( 图9)在(图9)中轻触“温度补偿”按钮, 显示(图10)画面,触摸对应参数区域可以对其进行设置更改。8.4在(图1)中轻触“交流数据”按钮,进入交流参数修改控制面板(如图2),轻触“回主菜单”按钮,进入主菜单面(图1):(图2)8.5在(图1)中轻触“模块参数”按钮, 显示(图3)画面,触摸对应参数区域可以对其进行设置更改。
上图中一个block对应两个split(默认是),一个split则是对应一个Map Task。Map Task将数据分完组之后到Shuffle,Shuffle完成后就到Reduce上进行输出,而每一个Reduce Tasks会输出到一个文件上,上图中有三个Reduce Tasks,所以会输出到三个文件上。


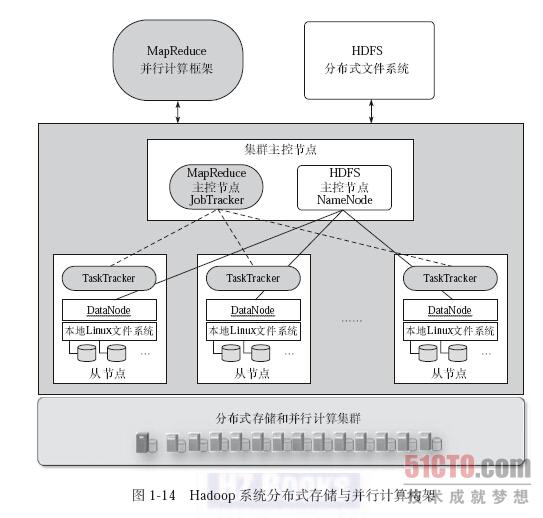
作业的管理者,它会将作业分解成一堆的任务,也就是Task,Task里包含MapTask和ReduceTask.
2.可以通过守护进程监控其它进程状态,例如有进程死掉,马上重启该进程,或者某个进程cpu使用率接近100%(基本可以判断是某个逻辑死循环了), 强制kill掉该进程,然后重启。2.可以通过守护进程监控其它进程状态,例如有进程死掉分布式并行计算 框架,马上重启该进程,或者某个进程cpu使用率接近100%(基本可以判断是某个逻辑死循环了),强制kill掉该进程,然后重启。目的:linux 下服务器程序会因为各种原因dump掉,就会影响用户使用,这里提供一个简单的进程监控和重启功能。

如果在一定的时间内,JT没有收到某个TaskTracker的心跳信息的话,就会判断该TaskTracker宕机,然后就会将该TaskTracker上运行的任务指派到其他的TaskTracker
任务的执行者,我们的Task(MapTask和ReduceTask)都是在TaskTracker上运行的,TaskTracker可以与JobTracker进行交互
例如执行、启动或停止作业以及发送心跳信息给JobTracker等。
自己开发的Map任务会交由该Task完成,
不过有些作业可能只有map没有reduce,这时候一般会将结果输出到HDFS文件系统里。
MapReduce2.x架构图如下,可以看到JobTracker和TaskTracker已经不复存在了,取而代之的是ResourceManager和NodeManager
不仅架构变了,功能也变了,2.x之后新引入了YARN,在YARN之上我们可以运行不同的计算框架,不再是1.x那样只能运行MapReduce了:

关于MapReduce2.x的架构之前已经在大数据入门(四) - 分布式资源调度——YARN框架
一文中说明过了,这里不再赘述


本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-116263-1.html
-

-
赵明月
怎么玩
 解决方案:如何在Apple的多合一计算机上安装win7,以及如何在Mac OS上通过图形教程安装win7
 高质量发展下的政府绩效评估体系建设
 在Oracle中查看所有表和字段以及表注释. 现场评论
 mfc socket onclose_mfc 多线程socket编程_mfc的socket编程实例
加油