Java文件下载文件名乱码(传输)
电脑杂谈 发布时间:2020-04-05 20:15:31 来源:网络整理
response.setHeader(...)下载中文文件名出现乱码
关于下载中文文件的问题,已经有很多咨询和回答问题. 我处理的原始代码如下:

response.setHeader("Content-Disposition", "attachment; filename=" + java.net.URLEncoder.encode(fileName, "UTF-8"));
在下载的程序中使用此句子时,无论是简体中文还是日语,文件名都将正确显示在IE6的下载提示框中. 但是下载下来的文件名乱码,那时,没有仔细测试带有长文件名的中文文件名. 现在,经过仔细测试,发现只要文本超过17个单词,就无法下载. 经过大量的google和反复测试,我终于对这个问题有了系统的了解,其细分如下:

1. 以我的原始方式,即首先使用URLEncoder进行编码,当中文字符超过17个时下载下来的文件名乱码,IE6无法下载该文件. 这是IE中的错误,请参阅Microsoft知识库文章KB816868. 原因可能是在处理响应标头时,即标头的长度被限制为大约150个字节. 而且汉字编码的UTF-8为9个字节,然后17个字符为153个字节,因此它将报告错误. Microsoft提供了可以从此处下载的补丁. 此补丁要求首先安装ie6 sp1. 因为我通常会经常打补丁,所以我的IE6版本号是6.0.2800.1106.xpsp2_xxxxx. 因此,我可能已经安装了补丁程序,以便可以下载它,但是文件名仍被截断. Microsoft让我们等待IE的下一个服务包的发布. 我今天也在网上看到了好消息. 由于Firefox的压力,IE7可能会在年中发布. 此外,Firefox不支持此方法,它将直接显示编码后的%xx%xx作为文件名.
第二. 我尝试使用javamail的MimeUtility.encode()方法对文件名进行编码,该文件名编码为=? gb2312? B? xxxxxxxx? =,并从RFC1522找到了相应的标准支持. 不幸的是,IE6不支持该标准. 我尝试过,支持Firefox.

三个. 根据许提供的解决方案: 将文件名编码为ISO8859-1似乎是一种有效的解决方案,代码如下:
response.setHeader( "Content-Disposition", "attachment;filename=" + new String( fileName.getBytes("gb2312"), "ISO8859-1" ) );
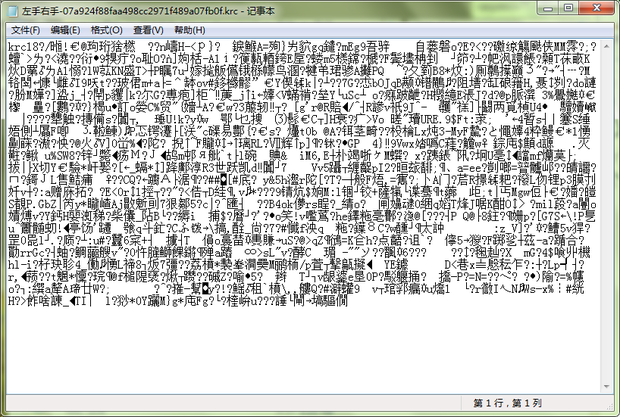
在确保附件的文件名全部使用简体中文字符的情况下,此方法确实是最有效的,而无需客户一一升级IE. 如果台湾同胞使用它,请将gb2312更改为big5. 但是当前的系统通常会增加国际支持,并且通常使用UTF-8. 文件名中是否包含简体中文字符,繁体中文和日语. 然后产生乱码. 此外,我计算机上的Firefox(v1.0-zh)下载出现乱码.
为了妥协,我结合了一种或三种方式. 代码段如下:
String fileName = URLEncoder.encode(atta.getFileName(), "UTF-8");
        /*
         * see http://support.microsoft.com/default.aspx?kbid=816868
         */
        if (fileName.length() > 150) {
            String guessCharset = xxxx /*根据request的locale 得出可能的编码,中文操作系统通常是gb2312*/
            fileName = new String(atta.getFileName().getBytes(guessCharset), "ISO8859-1");
        }
        response.setHeader("Content-Disposition", "attachment; filename=" + fileName);
暂时不考虑Firefox,因为它似乎并未有效地入侵IE的企业用户市场. 通常,进度会影响客户的采购订单,而不是兼容性的程度.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/shumachanpin/article-165107-1.html
-

-
杨德倩
追逐一望无际的蓝
 华为G9青年版和华为P9有什么区别?华为G9青年版和P9的区别汇总
 丹阳气瓶陶瓷高温条码商人,钢瓶金属陶瓷条码-请看这里!
 Wps表删除无尽的空白列
 海信网络电视机顶盒设置海信IPTV机顶盒设置
充电宝来源是否为假货