光场相机是怎样实现的?
电脑杂谈 发布时间:2019-12-25 19:01:42 来源:网络整理
最近,出于兴趣爱好,我研究了一下光场相机的工作原理,用mathematica模拟了一维光场相机的光线记录跟重聚焦成像过程。虽然这个难题终于是两年前的弊端了,而且早已有了很高的答案,但是我还是把自己的这篇原理总结放到这里,仅为分享知识而为之。与其使它烂到我的头脑跟硬盘里,不如让它烂到知乎里。
首先申明,本人非相关领域专家,以下只能算是依我兴趣喜好而写,不确保任何性。
感谢@李超 @ccccw,他们的答案极大地启发了我。
1. 传统成像过程
要想理解光场相机的机理,必须先理解传统成像过程的本质。所谓成像,不过是对物空间某一平面上光场强度分布的清晰重现而已。
我们先从一个点的成像开始,如下图
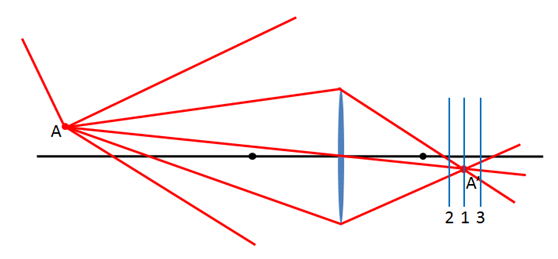
点A发出的光线借助透镜后在点A’汇聚。这里应该注意:(1)我们假定透镜是理想的薄透镜,也就是说任意平行于透镜的光线借助透镜后都汇聚于同一点,这一点就是透镜的焦点;(2)不是所有从点A发出的光线都可以借助透镜,透镜厚度越大,通过的光线越多,相应地会妨碍成像,相关疑问详见摄影大牛的剖析。
如果点A是这种的
那么分别将像平面至于位置1、2和3,我们将受到如下图图示的像。

可以看见,我们只有在平面1处才能得到更接近于点A的像点A’,而在平面2和平面3处点A的像会弥散开,一个点的像成了一个“饼”,这也就是失真了。
我们可以觉得现实中的物体是由这些点元构成的,每个点以及自己发光,或者反射照射到其上的光。组成物体的每个点(称之为物点)通过透镜后成像,所有的点的像集合起来便展现出物体的象。如果每个物点的象都近似为一个点(称之为像点),那么便会展现出清晰的象。相反,如果物点的象是类似前面像平面2和3的状况,是一个“饼”,那么相似的点的象经常互相重叠,物体的象经常显得模糊。只有当像平面恰好在某一位置附近时(类似像平面1),才会得到清晰的像,这也就是照相机为什么要调焦。当然,现实中的物体是在三维空间分布的,距离透镜的距离都不相似,在不同的像平面处可以得到不同距离的物体的清晰的像(下面会给出一个简单的程序模拟)。
举个更简单的事例,如果后面例子的物由两个点构成,如下
那么在平面1、2和3出会分别得到
可以发现只有在平面1处才能给出清晰的像,从而还原出物的状况。而在平面2和3处,由于两个点的像弥散成了两个“饼”,他们互相重叠,从而能够受到清晰的像,也就能够还原出物的状况(我们能够分别出是两个点)。
至此光场相机 演示,需要做一说明,上面给出的单点跟两点成像的事例,并不是由程序模拟透镜成像过程给出的,而是我自己为了表明问题而画的。下面的成像例子,是我用mathematica给出的透镜成像过程的模拟,确实是由程序模拟给出的。
我用mathematica模拟了一维成像过程。现实中的图像都是二维的,真实的成像过程也有二维的,但是为了简单起见(我也不能把很多精力花在自己的爱好上),这里只进行了一维状况的模拟,但是足以表明白问题。首先需要理解一维图像,所谓一维图像就是颜色分布只在一个维度上差异,另一个维度不变,比如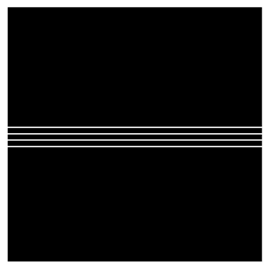
这就是一个一维图像(笛卡尔坐标系),颜色分布只在竖直方向差异,在水准方向不变。再例如
这只是一个一维图像(极坐标系),颜色分布只在极轴方向上变化,在幅角方向不变。下面的模拟,我们仅在笛卡尔式一维图像上进行。
首先分析成像背后的数学,看下图
我们分别在物、透镜和像处建立竖直向下的y轴坐标系,取物上的一点,坐标为yO(请原谅我直接给出的是程序中的变量名,其实这种更直观),遍历透镜上所有的点,坐标记为也yL。那么按照yO、yL和物距disO,就可以得到入射光线的视角aL_in,再根据透镜的焦距F,可以得到经过透镜折射后的光线的视角aL_out,最后根据yL、aL_out和像距disI,就可以受到该光线投射至像平面上的位置yI。简单理一下计算过程
(yO, yL, disO) –> aL_in

(yL, aL_in, F) –> aL_out
(yL, aL_out, disI) –> yI
最后我们将这条光线携带的色调和光强信息投射到像平面yI处就完成了该点的成像过程。将物上的每一个点元都进行这种的过程,就可以受到完整的象。(常写程序的人必须很容易理解这个过程。)
下面三幅图片分别用了只是处在距透镜不同距离的物(从左至右对应从近到远)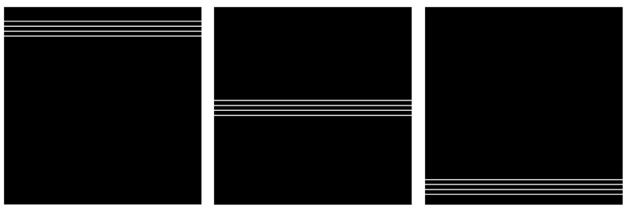
为了不互相遮挡,上图中三个类似条形码的“物”在竖直距离上互相错开了,如下图图示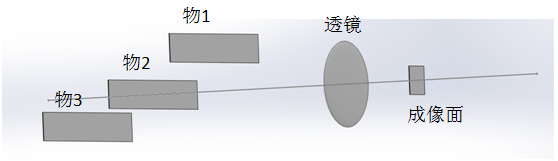
通过程序分别计算了离透镜不同距离的三个像平面上的像,分别拿到了物1、2和3的清晰的像,如下图图示
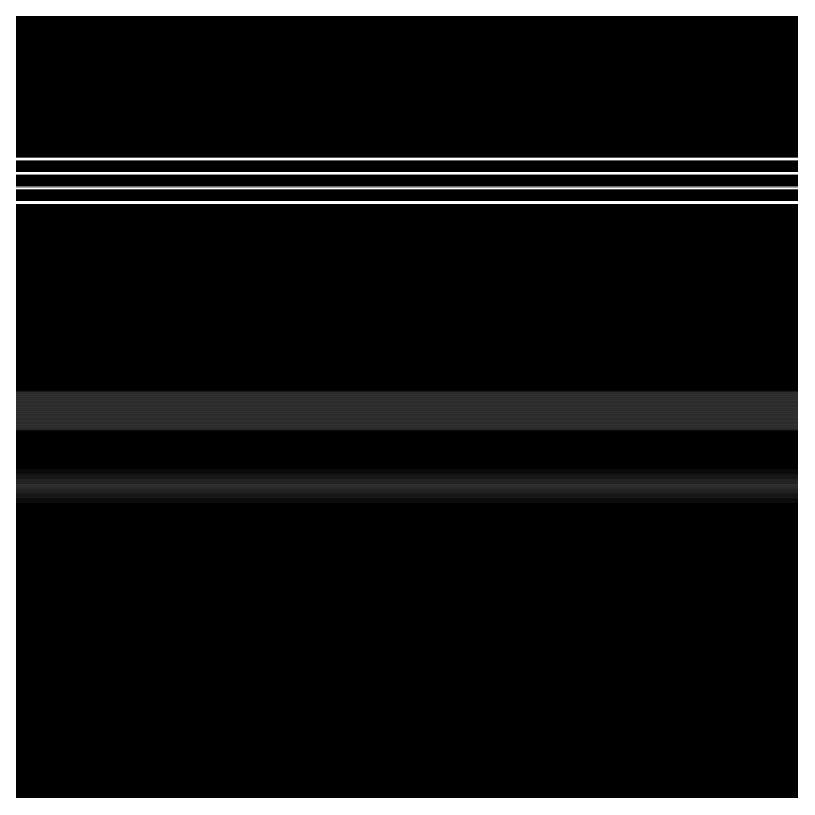

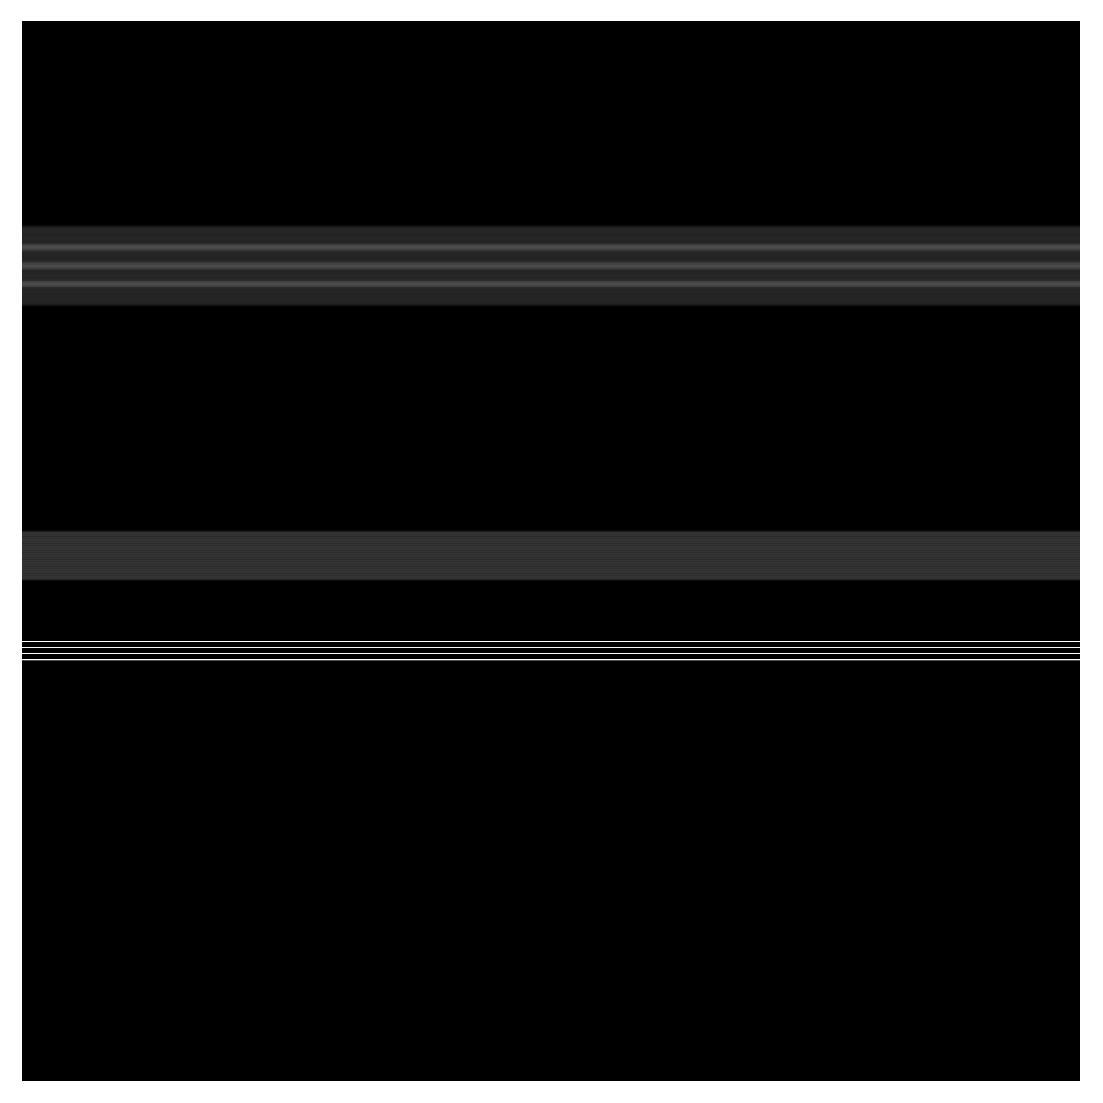
可以发现,在某一像距上我们只能获得某一物距的平面上的清晰的象,其他平面的像都是模糊的(这也涉及至景深的问题,详情请移步单反大牛的提问)。
2. 光场相机原理
我们进一步探讨传统成像的数学过程,再一次看这幅
(yO, yL, disO) –> aL_in
(yL, aL_in, F) –> aL_out

(yL, aL_out, disI) –> yI
实际上,我们只应该了解透镜后半部分的信息,就可以推导出距离透镜任意距离的平面上的像。也就是说我们即使知道了透镜后所有光线(当然实际操作时应做一定的离散化)的yL和aL_out,就可以计算出距离disI处平面上的yI。当然光线携带的信息不止yL和aL_out,还有色彩和光强,这里统一记做info_cmos。再进一步,针针对某一物空间,我们只应该记录了透镜后所有光线的(yL, aL_out, info_cmos)信息,就可获得任意disI处平面上的象。对于不同物距的物,我们总能在某一disI处获得该物的清晰的像,这也就推动了所谓的重聚焦过程。
那么怎样记录光线的(yL, aL_out, info_cmos)信息呢?info_cmos可以通过CMOS来记录,那么yL和aL_out呢?这也就是光场相机要干的事。
Lytro通过微透镜阵列的方式记录了光线的(yL, aL_out)信息(@李超的提问中给出了具体的解释),如下
在光场相机中,主透镜和微透镜阵列的距离为主透镜的光圈F,微透镜阵列和CMOS的距离为微透镜的焦段f。从主透镜发出的每一条光线(yL, aL_out)通过某一微透镜yLM后就会在被CMOS记录在不同的位置yS,那么反过来,通过(yLM, yS)可以反推出(yL, aL_out)。这也许也就是Lytro记录光线方向的方式。(应该每一个微透镜都对应一块CMOS区域光场相机 演示,以避免不同微透镜光线信息的互相重合。这种某种程度的避免光线信息的重叠,其实也就是Lytro可以记录光线信息的关键之所在,因为重叠就意味着信息的丢失。)
如果传统相机的成像过程可以表示为
(yO, yL, disO) –> aL_in
(yL, aL_in, F) –> aL_out
(yL, aL_out, disI) –> yI
那么Lytro拍摄过程就是
(yO, yL, disO) –> aL_in
(yL, aL_in, F) –> aL_out

(yL, aL_out, F, f) –> (yLM, yS)
重聚焦过程就是
(yS, yLM, F, f) –> (yL, aL_out)
(yL, aL_out, disI) –> yI
其实,Lytro把传统相机的成像过程分成了两个过程,把后面结果(yL, aL_out)存储了下来。
下面是mathematica模拟的光场相机的光线记录跟重聚焦成像过程。依旧是这三个物
空间分布跟上面的特色成像过程的模拟一样。通过光场相机的光线记录过程后,得到
这张图特别大(4710*4710),即使这种也能够将程序模拟记录的光线信息完全体现出来,因为信息量实在有点大(可能是取样太多了,可是取样少了受到的结果不理想)。下面是按照这幅图记录的信息,重聚焦得到的在离透镜不同距离的三个像平面上的像,分别拿到了物1、2和3的清晰的像
结果跟上面的传统成像基本一样。
3. 一些体悟
传统成像过程为什么能够记录完整的光线信息呢,引用@ccccw的话“光场相机记录四维图像再做积分生成二维图像,积分过程中经常有信息丢失”。以下给出我的一个理解。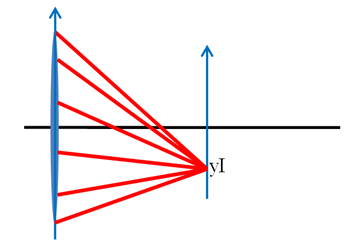
如上图,yI点的CMOS记录的颜色跟强度信息info_cmos(yI)是由从透镜发出的无数光线的色彩和强度信息info_cmos(yL, aL_out)叠加而成的。这是一个不可逆过程,也就是说根据info_cmos(yL, aL_out)可以得到info_cmos(yI),可是根据info_cmos(yI)是无法反推出info_cmos(yL, aL_out)的。或许我们可以按照几何关系反推出汇聚到yI点的所有光线的yL和aL_out,但是仍难以确认每条光线的info_cmos信息(特别是如果这种光线来自不同的物点)。其实这种说早已十分罗嗦了,说白了,这就是定积分的不可逆性导致的。
P.S. 写完了才发觉,我写得这个总结可读性有点差,这是有违我的本意的,可能确实是水平所限吧。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/shumachanpin/article-134638-1.html
-

-
戴望舒
中国必须时刻准备着
-
杉山佳寿子
如果真的有蛆
 Apple打开降级渠道!如何降级Apple iPhone的iOS系统?
 HASSELBLADUSA H5D
 如何设置联想笔记本从U盘启动
 手机无法安装软件,编辑器会教您如果手机无法安装软件怎么办
我相信他讲的是理念