智能聊天机器人的小黄鸡
电脑杂谈 发布时间:2020-03-29 02:15:03 来源:网络整理
在您讲话之前,请先热身. 如果您不熟悉这只小黄鸡,欢迎大家在这里戳;我们欢迎您测试自制的小黄鸡. . 现在就叫他后面的2〜1号小黄鸡
在您讲话之前,请先热身. 如果您不熟悉这只小黄鸡,欢迎大家在这里戳;我们欢迎您测试自制的小黄鸡. . 现在就叫他后面的2〜1号小黄鸡
大家好,我是Muer. 今天很荣幸能成为主持人,与您讨论智能聊天机器人Little Yellow Chicken的问题. 很抱歉,如果您讲得不好,请轻率地提问.
今天的演讲主要分为三个部分: 1.什么是小黄鸡2.小黄鸡的基本原理3.如何制作小黄鸡.
第1部分是的小鸡
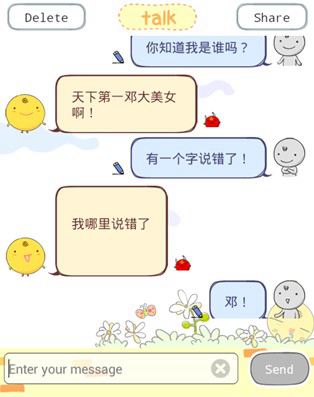
许都知道人人的小黄鸡. 只要@小黄鸡,它就会出来与您聊天. 这是一个典型的人工智能聊天机器人.
实际上,Renren.com的Little Yellow Chicken是Huake的08年级同学. 通过Renren.com界面,它会调用韩语聊天机器人SimSimi的API来自动回复提问者.
这是下面的图片:

SimSimi首先在移动平台上流行. 至于其具体原理和实现方法,我们将在后两部分进行介绍. 换句话说,Renren.com的小黄鸡的原型是智能聊天机器人SimSimi. 那么什么是聊天机器人?
简单来说,它是一种基于人工智能(AI)原理分析聊天文本后给出响应的程序. 世界上最早的聊天机器人诞生于1980年代. 该机器人称为“ Albert”,是用BASIC语言编写的. 而且由于中文中“单词”的歧义和歧义,中文聊天机器人的发展相对缓慢. 目前,温莎有小i,爱宝有小A和腾讯.
第二部分小黄鸡的基本原理
AI聊天机器人Little Yellow Chicken的工作可以分为两个部分: 训练+匹配. (实际上,许多AI事物可以像这样被划分,例如面部识别,语音识别等. )
Simsimi中的“教学”是培训的过程,目的是建立或丰富同义词库.
该过程描述如下:
S1: 用户通过教学界面向系统提交主题和相应的响应;
S2: 系统对主题进行分词,以确定主题在系统知识库中的存储位置;

S3: 在系统知识库中添加此主题和相应的响应.
如您所见,这里涉及两个问题: 给定一个主题,系统如何分割单词?同义词库应如何设计以快速准确地做出响应?
2.1.1分词方法
有人认为我教过小黄鸡“埃菲尔铁塔上的45度角仰望星空”,答案是“哈哈”. 然后在下一次看到整个句子“埃菲尔铁塔上的45度角仰望星空”时,下一个句子有相应的答案. 但是实际上,下次看到“艾菲尔铁塔”时,它会“哈哈”还可以.
这是因为聊天机器人的存储不是基于句子(这会占用太多时间和空间),而是基于单词. 因此,分词几乎已成为聊天机器人的核心.
英语分词很容易说. 人们可以使用空格来做到这一点,但是中文却不一样. 对于一个句子,人们可以利用自己的知识来区分单词. 机器人要做的是中文分词算法的研究领域.
中文分词技术似乎是一个重要的研究方向,属于自然语言处理. 现有的分词算法可以分为三类: 基于字符串匹配的分词方法,基于统计的分词方法和基于理解的分词方法.
聊天时用户的一个重要特征是,提出的主题通常简短,不长,没有段落结构,并且绝大多数只是几句话. 基于统计的分词方法适用于段落,章节结构和上下文关系. 基于理解的分词方法目前还不成熟,时间复杂度高,速度慢. 因此,仅基于字符串匹配的分段更为合适.
基于字符串匹配的分词方法,也称为机械分词方法. 根据不同的扫描方向,机械分词可以分为正向匹配和反向匹配. (例如,字符串“ Beijing Huayan Cloud”,正向匹配项为“ Beijing,Huayan Cloud”,反向匹配为“ North,Jinghua Smoke Cloud”). 反向匹配的分割精度高于正向匹配方法,以便有助于发现歧义分割,有时将两者结合以形成双向匹配方法. 根据不同长度的匹配小黄鸡聊天机器人接口,可以分为最大(最长)匹配和最小(最短)匹配,即长字优先和短字优先. 根据匹配不成功时的重切策略,将机械分词分为增加和减少两个词.
基于字典的“双向最大匹配”方法是当前中文信息处理中最简单,最有效的方法. 有统计: 中文文本中约90%的句子与双向最大匹配结果一致,即正确的分词结果.
当通过正向和反向最大匹配算法获得的分割结果不同时,必须将其视为歧义,在此不再赘述.
2.1.2同义词库设计
由于中文单词的特点: 1.中文单词是一个开放集合,单词的数量在增加; 2.以不同单词开头的单词数量相差很大,多达数百个,可能只有一个或更少. 3.单词的长度差异很大,有单个单词的单词,也有由六个或七个单词组成的单词.
这要求在设计字典时,除了考虑访问效率之外,还必须考虑存储利用率.
如果您查看此数据结构,则可以很好地平衡时间和空间.

第一个字符哈希表可以通过哈希操作直接定位汉字在表中的位置. 一个单元包括三个项目: C: 存储第一个单词; F标志: 以C作为第一个单词存储最长条目的长度; P: 指向词汇索引表.

解释哈希表: 哈希表,也称为哈希表,顾名思义,数据是分散的,然后按照一定的规律存储以加快访问速度. 它是一种根据键值Key直接访问的数据结构.
栗子: 我想将[0,100)做成一个哈希表,选择“ modulo 10”作为哈希函数,并使用该数组作为存储单元,那么我将得到A [10] [10 ],A [0]依次存储0,10,20 ... 90; A [1]存储1,11,21 ...91. 依此类推.
下面是训练一只小黄鸡的例子: 我教小黄鸡说: “你白天梦想什么?”答案是“哦,哈哈哈,您不需要控制它. ”
S1: 使用双向最大匹配算法进行分割: 双向分割结果,转发“大日子,什么,什么,美丽的梦啊”;反转“大日子,什么,什么,美丽的梦啊”. 正向和反向相同,因此无需处理歧义. 长词是首选,“大日子”和“做什么”.
S2: 以“ Big Day”为例,假设哈希函数为f(),并让f(Big Day)指向第一个单词[Large,11,P]的哈希条目. 然后,该条目指向“ 3字索引”,然后指向相应的“词汇表”.
S3: 将结构
S4: 完成培训.
2.2个匹配项
可以描述为以下过程: S1: 用户通过聊天界面向系统提出主题; S2: 系统对该主题进行分词; S3: 在系统知识库中找到与该主题匹配的话语以回复用户.
基于字典的分词算法分为几个阶段: 字典加载,预处理,最大匹配和歧义解决.
具体过程如下:
S1: 在预处理阶段,将根据特殊字符(英文字母,数字,标点符号等)将要分析的文本进行分段,并将要分段的文本分为仅短句的短句中文. 这些句子是下一个分段基本处理单元;
(带栗子: 输入“ asdfadf东北师范大学哈哈哈dfadflakfl(* ^ __ ^ *)hee hee ...”,simi只会回应中文“东北师范大学hahaha hee hee hee”);当您键入“((* ^ __ ^ *)”,它输出“我没有回应. ”)
S2: 对分割后的句子进行双向最大匹配(双向匹配,长单词优先),并将分割后的结果作为S3的输入;
(一个栗子: 输入“ Tokyo Cuban Babylon”,正反切词结果为“ Tokyo,Cuban Babylon”,长字优先,因此simi仅响应“ cuban babylon”;输入“ Babylon Eiffel Tower” ”,正反切词结果是“巴比伦,埃菲尔铁塔”,此时西米回应了“埃菲尔铁塔”
S3: 比较在先前的细分中获得的结果,以确定是否存在歧义,如果存在歧义,则执行一定的歧义解决方案;
S4: 重复S2和S3,直到处理了在步骤1中被打断的句子切出的所有句子单元.

算法流程如图所示:

下面是一个与一只小黄鸡交谈的例子: 我问那只小黄鸡: “看着埃菲尔铁塔上成45度角的星空”.
S1: 双向最大匹配分词: 正向和反向为“在埃菲尔铁塔上,仰角仰望星空45度”,没有歧义. 长词优先,系统选择“埃菲尔铁塔上”作为关键字;
S2: 系统使用知识库中刚刚提到的哈希函数f(在艾菲尔铁塔上)查找诸如[E,11,P]之类的条目,并沿着指针找到6个单词的索引,然后索引找到6个单词的词汇表,遍历该词汇表,然后找到<埃菲尔铁塔上的结构,...>
S3: 系统在结构的Ans字段中随机选择一个答案(它也可以根据频率进行选择). 例如“两年后等你”.
S4: 输出答案,匹配结束.
第3部分如何制作小小的黄鸡
根据第二部分介绍的原则,个人很难真正完成整个小黄鸡的生产. 如果您可以制作一个智能聊天机器人,那么您可以直接申请专利来创办公司〜
因此,这里我们介绍两种相对简单的方法,跳过对智能算法的研究,直接调用SimSimi的库.
3.1通过cookie方法
首先,让我们看看Renren.com的小黄鸡是如何做到的.
原始作者的团队在github上提供了源代码和URL. 他们使用Python语言获取Cookie,并通过Renren.com的界面将Simi的库连接到Renren.
换句话说,人人网的小黄鸡并没有真正研究第二部分提到的AI聊天机器人的算法. 相反,它是通过调用Simi的库来调用的!这就是人人网与小米之间的关系.
Cookie: 是指某些网站为了识别用户并跟踪会话而在用户本地终端上存储的数据(通常是加密的). 使用网页代码中的HTTP标头信息进行传输.
(例如,第一次登录“宝眼论坛”时输入用户名和密码,然后选择保存密码,这相当于保存cookie. 在以下情况下,无需再次登录: 您下次打开eeban〜
存在Cookie很有用,它们也极大地损害了网络信息的安全性. 因为cookie可以通过诸如JS脚本之类的方法窃取. 想想看,其他人已经获得了您的cookie,您可以在不知道您的用户名和密码的情况下查看您的电子邮件,浏览网络等...当然这是题外话,我们将来会讨论它〜希望大家经常可以清理自己的Cookie,而不给坏蛋一个机会~~)
回到我们的小黄鸡,下面的图片是人人网小黄鸡的源代码中有关获取cookie的一段:

我们需要自己做,所以我们不需要它们那么麻烦〜我们只需要几行代码〜
核心算法简介:
S1: 使用会话对象获取本机cookie;
(会话,在Web应用程序中称为“会话”. 简单来说,它就像是网站顶层的方框. 无论网页如何跳转,它都可以保存用户信息. 请注意此处! Simi的免费聊天页面很重要!)
S2: 构造标头信息并准备将cookie添加到HTTP标头信息
S3: 从SimSimi API接口获取本地响应
(如前所述,cookie是使用HTTP标头传输的,因此我们将对话页面上的cookie添加到API页面,这等效于对话页面调用API !!!!
带一个栗子,我们锁上了锁,转到讨论页面,并且谈话给了我们一个密钥,但是我们不知道如何解锁它,所以我们给了API了锁+密钥,帮助我们打开了盒子~~~ bling ~~ bling ~~)
来,让我们看一下原理图:

这是我用这种方法制作的小黄鸡:

准确地说,这是一只小鸡和一只小鸭之间的相互遭遇. 哈哈!
想做一点黄鸡,这是一种省时的方法,但是. . . 我不得不说,这是贪污SimSimi的工作的结果. . . 人们期望他们的API库能卖钱. . . . 金额
所以让我们看一下原始的法~~
3.2通过键调用API接口
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/shouji/article-156046-1.html
-

-
王爽
也要拿回来
-
 21KE 21克老人手机移动超长待机直板按键男女老人机大声大字军工三防学生迷你备用老年电脑
 HTC工程模式怎么进?进入工程模式方法总结
 如何卸载金山毒霸?如何完全删除金山毒霸?
 以音乐的名义对爱立信Walkman Android机器进行评估
毛主席语录