为什么NVIDIA的最近几代游戏图形卡的双精度浮点计算能力会下降?
电脑杂谈 发布时间:2020-08-27 06:11:17 来源:网络整理
这是这几代架构本身的问题,不是故意的.
从单精度开始.
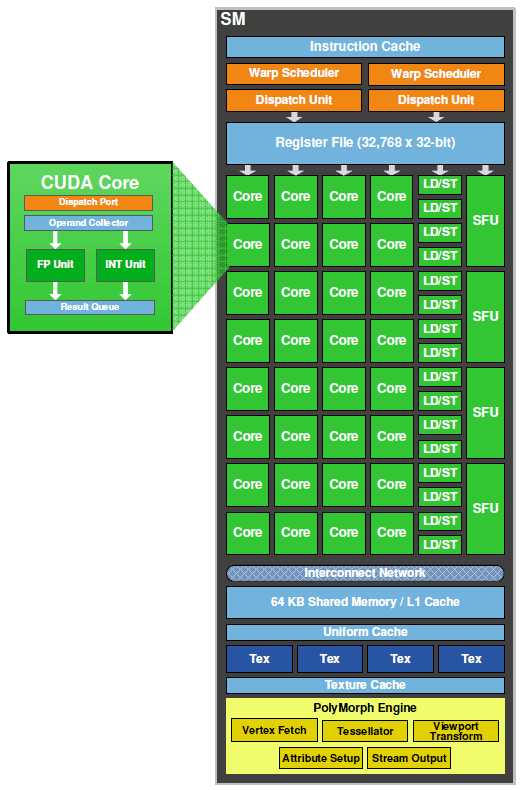
Kepler和Maxwell完全保留了Fermi引入的IEEE 754-2008标准的单精度和双精度算法,包括产品和熔体添加(FMA)操作. 每个SMX单元具有192个单精度CUDA内核,每个SMM单元具有128个单精度CUDA内核. 每个内核由一个浮点单元(FP单元)和一个整数算术逻辑单元(Int ALU)组成.
Fermi,Kepler和Maxwell的共同点是,1个CUDA内核@ 1000MHz具有2.00 GFLOPS单精度浮点计算功能.
让我们谈谈双精度. 首先附上所涉及显卡的所有双精度速率.
1/2单精度: Tesla-Fermi

1/3单精度: Titan-Kepler系列,Tesla-Kepler
1/8单精度: 费米游戏卡
1/24单精度: 开普勒游戏卡,泰坦-开普勒紧密双精度
1/32单精度: 麦克斯韦
Kepler切换到双精度单元独立设计. CUDA内核中的FP单元(浮点单元)具有单精度计算功能,并且仅开放支持双精度浮点计算,而没有实质的双精度浮点功能. 必须在CUDA(DP单元)旁边添加双精度浮点单元,以协助CUDA内核执行双精度浮点计算,以使CUDA内核具有双精度浮点功能.

在Tesla-Kepler计算卡中,NVIDIA向每个SMX添加了64个DP单元,实现了192 CUDA和64 DP单元的单双精度比. 基于完整的GK110 Tesla计算卡,它具有2880 CUDA,896 DP单元和1/3 DP计算能力,大量的DP单元也已成为计算卡的象征. 同时,为了减少由于DP单元的增加而导致的功耗,特斯拉计算卡已删除与计算无关的部件.

但是,纯粹为计算而添加的DP单元不会在游戏中产生图形性能和计算能力. 在GPU Boost的作用下,DP单元产生的过多功耗和热量会拖累图形卡的功耗. ,因此NVIDIA选择以CUDA 1/8频率运行游戏卡中的DP单元,该频率已降低至DP计算能力的1/24.
GTX TITAN是一个例外. 为了遵守其跨境身份,它没有选择完全降低送稿器的频率. NVIDIA在驱动程序中提供了Titan双精度手动开关. 开机时,DP单元和CUDA以相同的频率运行. ,具有1 / 3DP功能,DP单元在关闭时以CUDA 1/8频率运行,并保持与开普勒游戏卡相同的1/24 DP功能,因此Titan可以达到与游戏卡相同的功耗温度水平.
对于降低CUDA7中双精度功能的GTX TITAN Z,我是这样理解的. GTX TITAN Z是完整的两个GK110内核. 选择风冷散热后,必须将卡的厚度扩展到三层,并将频率降低到705MHz,提升到876MHz. 此时,冗余DP单元已成为GTX TITAN的障碍. Z的功耗因素之一,并且作为游戏卡,GTX TITAN Z没有配备ECC显存,这在计算中是一个很大的漏洞,因此最终NVIDIA选择关闭GTX TITAN Z的双精度功能
看看麦克斯韦.
在Maxwell中,NVIDIA向每个SMM添加4个DP单元以实现128 CUDA,4个DP单元单精度和双精度比率,并且DP单元和CUDA以相同的频率工作,因此Maxwell可以实现1/32 DP的计算能力.
对不起,找不到SMM中的DP单元图片. 应该没有图片,但是很容易理解...
你为什么要这么做?

因为麦克斯韦的重点是降低能耗.
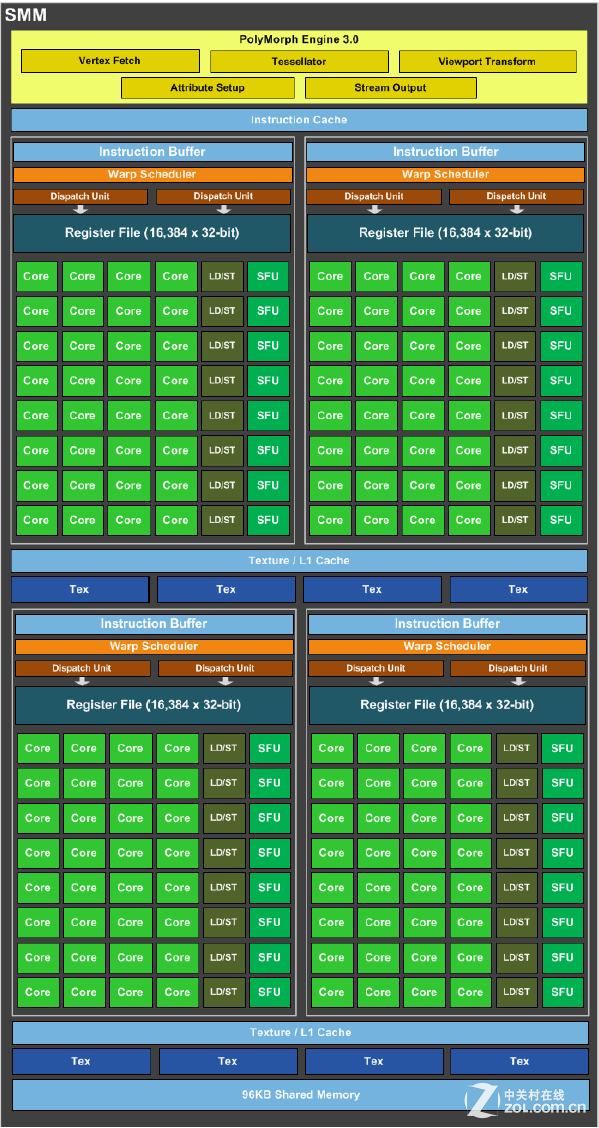
GPU并行结构的改进,ALU群集的改进以及任务仲裁机制的改进都是基于提高CUDA内核的利用率,以防止上一代KeplerALU的利用率低. 同时减少了DP单元,直接减少了SMM中的单元,以达到降低功耗的目的.
改进的调度机制增加了能耗比,并且还带来了另一个负面因素,即晶体管数量的增加. GM204具有52亿个晶体管,核心面积为398平方毫米,而在相同的TSMC28nmHP工艺下相应定位的GK104具有35亿个晶体管,核心面积为294平方毫米. 在相同规格下所需的晶体管数量有所增加.
大型怪物GM200为80亿,核心区域为610平方毫米. 上一代GK110为71亿,核心面积为573.3平方毫米.
与GK104相比,GK110的晶体管数量几乎增加了一倍,但规格却没有增加一倍. 为什么?
回到我们首先列出的双精度比率表:

1/3单精度: Titan-Kepler系列,Tesla-Kepler
1/24单精度: 开普勒游戏卡,泰坦-开普勒紧密双精度
这就是为什么!
为了实现双精度功能的1/3,GK110装有大量DP单元,这大大增加了晶体管的数量,同时降低了功耗.
再次查看GM200和GM204. 在规格增加一半之后,晶体管的数量也非常一致.
您可能会问,为什么NVIDIA不增加GM200中的DP单元数量. 这是因为像GM200这样巨大的内核已经达到了成熟的28nm极限,几乎不可能将DP单元插入其中. 功耗将变得非常丑陋,也许会有关于上一代GTX TITAN Z的笑话,它具有冷漠而不是击败对手R9 295X2的优势.
因此,这些代游戏卡的双精度功能的降低和麦克斯韦的弱双精度功能是由设计架构的概念和方向引起的,而不是故意增加特斯拉卡,特斯拉的出货量面向人士在该领域中,游戏卡不具有ECC内存功能,并且在领域中的用户也不会自己考虑游戏卡.
PS: 去年中旬,NV已经设计出GK210并成功将其录音. 与GK110相比,GK210的最大变化是寄存器文件和一级缓存的容量分别增加了一倍,分别达到512KB和128KB. 增加寄存器文件和1级缓存后,流处理器阵列中的数据吞吐量可以得到显着提高. 能够更有效地工作,特别适合于高性能计算. 这显然是有针对性的重新设计. 这时,许多高性能计算机都配备了GK210高性能计算卡. 麦克斯韦成功录音后,显然计划再次改进GK110.
PS2: NVIDIA在过去两年中仍然提到的每瓦双精度性能的概念现在已变成“混合精度”,不再刻意强调双精度.
因此,我不负责任地猜测麦克斯韦的核心特斯拉卡不会出现. 相反,开普勒在特斯拉计算卡市场上仍然很猖,,帕斯卡可能会再次取消双精度功能.
我希望这一切都是由于28nm处停滞所致.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/shenmilingyu/article-307837-1.html
-

-
范丽娜
喜欢哈哈
 显卡散热片的加工精度比屏幕高,谁说不烫?
 终极:玩PlayerUnknown的战场,我需要什么图形卡?知道如何在第二张显卡最低要求中吃鸡肉
 失望:计算机温度过高而频率下降?现在我会告诉你真相
 昂达VI40双核版刷机教程
算我哟个