bp神经网络算法实例?什么是bp神经网络模型?BP神经网络理论
电脑杂谈 发布时间:2016-09-11 16:01:12 来源:网络整理你是否正在寻找关于bp神经网络的内容?让我把最实在的东西奉献给你:
单个神经元(理解神经网络第一步):
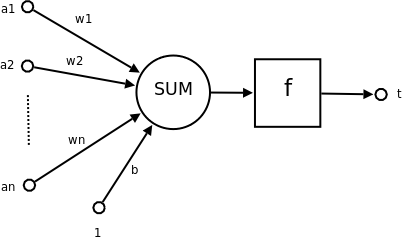
数学表示

带有 sigma 函数(顶部)和 cutoff 函数(底部)
可见,一个神经元的功能是求得输入向量与权向量的内积后,经一个非线性传递函数得到一个标量结果。
)
首先解释一下单个神经元如何进行分类判断:
引入一个阈值逻辑单元(Threshold Logic Unit,TLU)的名词,它可以输入一组加权系数的量,对它们进行求和,如果这个和达到或者超过了某个阈值,输出一个量。
WXa,换一种方法表示:
a = (X1 * W1)+(X2 * W2)+...+(Xi * Wi)+...+ (Xn * Wn)
yy=1squashsa1
假设一个 TLU 有两个输入值,它们的权系数等于 1,theta 值等于 1.5。当这个 TLU 输入 <0,0>、<0,1>、<1,0> 和 <1,1> 时,它的输出分别为 0、0、0、1。TLU 将这些输入分为两组:0 组和 1 组。就像懂得逻辑连接(布尔运算 AND)的人脑可以类似地将逻辑连接的句子分类那样,TLU 也懂得一点逻辑连接之类的东西。
0
在培训过程中,神经网络输入:
理想化的学习算法 fully_trained = FALSE DO UNTIL (fully_trained): fully_trained = TRUE FOR EACH training_vector = <X1, X2, ..., Xn, theta, target>:: # Weights compared to theta a = (X1 * W1)+(X2 * W2)+...+(Xn * Wn) - theta y = sigma(a) IF y != target: fully_trained = FALSE FOR EACH Wi: MODIFY_WEIGHT(Wi) # According to the training rule IF (fully_trained): BREAK
神经元网络:
单层神经元网络:是最基本的神经元网络形式,由有限个神经元构成,所有神经元的输入向量都是同一个向量。由于每一个神经元都会产生一个标量结果,所以单层神经元的输出是一个向量,向量的维数等于神经元的数目。 :

:

当实际输出与期望输出不符时,进入误差的反向传播阶段。误差通过输出层,按误差梯度下降的方式修正各层权值,向隐层、输入层逐层反传。周而复始的信息正向传播和误差反向传播过程,是各层权值不断调整的过程,也是神经网络学习训练的过程,此过程一直进行到网络输出的误差减少到可以接受的程度,或者预先设定的学习次数为止。
好了,以上对于神经网络的结构以及各个组件之间的运行时关系描述到此为止,那么,现在重要的是:具体是如何在误差反向传播的过程中,对各个层权系数进行调整?规则是什么?总结上面,调整的目的即是每次训练后减少误差。可以使用最小二乘法或者是梯度下降算法。首先需要介绍一下Delta学习规则。
关于 delta 规则
delta
设p是一组培训中的一个元素,t(p,n)是相应的输出节点 n 的目标。
sum = 0 FOR p = 1 TO M: # M is number of training vectors FOR n = 1 TO N: # N is number of output nodes sum = sum + (1/2 * (t(p,n)-y(p,n))^2) average = 1/M * sum
delta 规则就是依据这个误差的定义来定义的。因为误差是依据那些培训向量来说明的,delta 规则是一种获取一个特殊的权系数集以及一个特殊的向量的算法。而改变权系数将会使神经网络的误差最小化。我们不需要讨论支持这个算法的微积分学,只要认为任何Wi发生的变化都是如下所示就够了:
alpha * s'(a(p,n)) * (t(p,n) - y(p,n)) * X(p,i,n)
同样源于梯度降落原理,在权系数调整分析中的唯一不同是涉及到t(p,n)与y(p,n)的差分。通常来说Wi的改变在于:
alpha * s'(a(p,n)) * d(n) * X(p,i,n)
其中d(n)是隐藏节点n的函数,让我们来看:
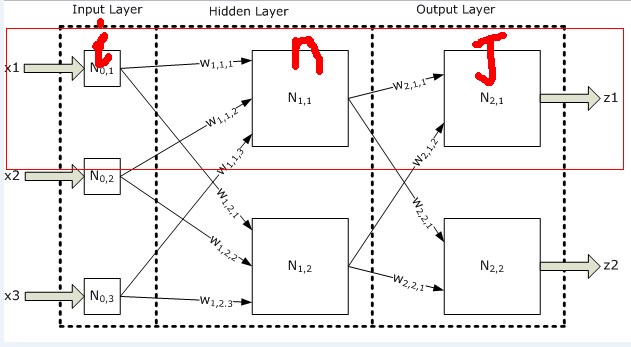
一方面,n 影响一个输出节点越多,n 造成网络整体的误差也越多。另一方面,如果输出节点影响网络整体的误差越少,n 对输出节点的影响也相应减少。这里d(j)是对网络的整体误差的基值,W(n,j) 是 n 对 j 造成的影响,d(j) * W(n,j) 是这两种影响的总和。但是 n 几乎总是影响多个输出节点,也许会影响每一个输出结点,这样,d(n) 可以表示为:
SUM(d(j)*W(n,j))
这里j是一个从n获得输入的输出节点,联系起来,我们就得到了一个培训规则。
第1部分:在隐藏节点n和输出节点j之间权系数改变,如下所示:
alpha * s'(a(p,n))*(t(p,n) - y(p,n)) * X(p,n,j)
第 2 部分:在输入节点i和输出节点n之间权系数改变,如下所示:
alpha * s'(a(p,n)) * sum(d(j) * W(n,j)) * X(p,i,n)
这里每个从n接收输入的输出节点j都不同。关于反向传播算法的基本情况大致如此,。
使误差小到适当的程度要遵循的步骤
第 1 步:输入培训向量。
第 2 步:隐藏节点计算它们的输出
第 3 步:输出节点在第 2 步的基础上计算它们的输出。
第 4 步:计算第 3 步所得的结果和期望值之间的差。
第 5 步:把第 4 步的结果填入培训规则的第 1 部分。
第 6 步:对于每个隐藏节点 n,计算 d(n)。
第 7 步:把第 6 步的结果填入培训规则的第 2 部分。
通常把第 1 步到第 3 步称为 正向传播,把第 4 步到第 7 步称为 反向传播。反向传播的名字由此而来。
参考资料:
神经网络编程入门,这儿有一个BP的matlab程序示例。
以上就是关于bp神经网络的全部内容,相信你一定会非常满意。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/shenmilingyu/article-16376-1.html

 惠普cq43内存条?惠普官网?惠普cq43换屏教程
 nokia 3310?诺基亚3310不死传说?诺基亚手机最新款2016?史上最霸气“诺基亚3310”登场:亮瞎了
 操作方法:如何设置NVIDIA控制面板
 老黄N卡:泰坦皮RTX2080TITI显卡
咱们啥时候也能这么霸气一回