常见的非关系(NoSQL)建议介绍
电脑杂谈 发布时间:2020-07-31 22:03:49 来源:网络整理
随着Internet web2.0网站的兴起,非关系现在已成为一个非常热门的新领域,非关系产品的发展非常迅速. 传统的关系无法应对web2.0网站,尤其是超大型,高并发SNS型web2.0纯动态网站,这些网站暴露出许多无法解决的问题,例如:
1,高性能-对进行高并发读写的需求
Web2.0网站需要生成动态页面并基于用户个性化信息实时提供动态信息,因此基本上不可能使用动态页面静态技术,因此并发负载非常高,经常达到数十倍. 每秒数千次读取Write请求. 关系几乎无法处理数以万计的SQL查询,但是硬盘IO不再能够处理数以万计的SQL写数据请求. 实际上,对于普通的BBS网站,经常需要大量的并发写入请求,例如JavaEye网站上用户状态的实时统计,记录热门帖子的点击次数,投票数等. 因此,这是一个相当普遍的需求.
2,巨大的存储空间-有效存储和访问海量数据的需求
Facebook,Twitter和Friendfeed之类的SNS网站每天都会产生大量的用户活动. 以Friendfeed为例,它每月有2.5亿个用户帖子. 对于一个关系,一件中有2.5亿个用户帖子. 记录表中SQL查询的效率极低,甚至无法忍受. 另一个例子是大型网站(如腾讯和盛大)的用户登录系统,这些网站动turn拥有数亿个帐户,关系也难以处理.
3,高可伸缩性和高可用性-对的高可伸缩性和高可用性的需求
在基于Web的体系结构中,最难横向扩展. 当应用程序系统的用户和访问量每天都在增加时,通过添加更多硬件和服务节点来扩展性能和负载容量,您的不能像Web服务器和应用程序服务器那样简单. 对于许多需要提供24小时不间断服务的网站,升级和扩展系统非常痛苦,这通常需要停机才能进行维护和数据迁移. 为什么不能通过不断添加服务器节点来扩展?
面对上面提到的“三高”要求,关系遇到了无法克服的障碍. 对于web2.0网站,关系的许多主要功能通常都是无用的,例如:
1. 事务一致性要求
许多Web实时系统不需要严格的事务,并且对读取一致性的要求较低,并且在某些情况下不需要较高的写入一致性. 因此,在高负载下,事务管理已成为沉重的负担.

2. 的实时读写要求
对于关系,您可以在插入数据后立即读取数据. 但是,对于许多Web应用程序,不需要如此高的实时性能. 例如,在发送一条消息之后,我的订户花了几秒钟甚至十秒钟才看到这种动态完全可以接受.
3. 对于复杂的SQL查询,尤其是多表相关查询的要求
任何具有大量数据的Web系统都非常忌讳多个大表的相关查询以及复杂数据分析类型的复杂SQL报表查询,尤其是SNS类型的网站. 从需求和产品设计的角度,避免出现这种情况. 通常,它不仅是单个表的主键查询,而且是单个表的简单条件分页查询,大大削弱了SQL的功能.
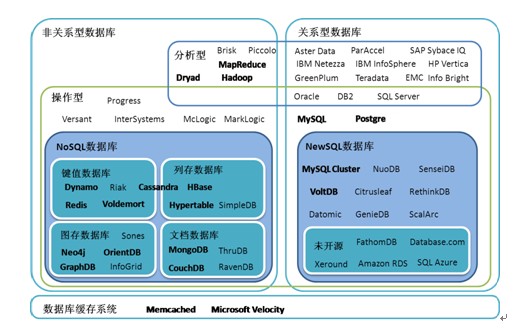
因此,关系不太适合这些越来越多的应用场景. 为了解决这些问题,出现了非关系. 现在,在过去的两年中,各种非关系,尤其是键值存储(Key-Value Store DB)风起云涌. 不久前,NoSQL会议在国外举行,各种NoSQL陆续出现. 此外,至少有10多个开源NoSQLDB,例如:
Redis,Tokyo Cabinet,Cassandra,Voldemort,MongoDB,Dynomite,HBase,CouchDB,Hypertable,Riak,Tin,Flare,Lightcloud,KiokuDB,Scalaris,Kai,ThruDB,...
其中一些NoSQL是用C / C ++编写的,一些是用Java编写的,有些是用Erlang编写的. 每个都有其独特性. 我看不到这些NoSQL大致可以分为以下三类:
1. 满足极高读写性能要求的Kye-Value: Redis,Tokyo Cabinet,Flare
高性能键值的主要特征是它具有极高的并发读写性能. Redis,Tokyo Cabinet,Flare,这三个Key-Value DB都是用C编写的,它们的性能相当出色. 但是凭借出色的性能,它们还具有自己的独特功能:
1,Redis
Redis是一个非常新的项目,版本1.0刚刚发布. Redis本质上是内存的键-值类型,非常类似于memcached. 整个被加载到内存中以进行操作,并且数据通过异步操作被定期刷新到硬盘以进行存储. 因为它是纯内存操作,所以Redis具有出色的性能. 它每秒可以处理100,000多个读写操作. 这是我所知道的最快的键值.
Redis的卓越表现不仅在于性能. Redis的最大魅力在于支持保存List链接列表和Set集合的数据结构,它还支持List的各种操作,例如从List的两端推送和弹出数据,获取List间隔非关系型有哪些,排序等. Set支持各种集合的并集和相交操作. 此外,单个值的最大限制为1GB. 与只能存储1MB数据的内存缓存不同,Redis可用于实现许多有用的功能,例如,赛义德说将其List用作FIFO双链列表来实现轻量级高性能消息队列服务,而他的Set可以用作高性能标签系统等. 此外,Redis还可以设置存储的键值的过期时间,因此它也可以用作memcached的增强版本.
Redis的主要缺点是容量受物理内存限制,不能用于海量数据的高性能读取和写入,并且它没有本机可扩展性机制,也没有规模(可伸缩) )功能. 这取决于客户. 由于实现了分布式读写,因此Redis适用于主要限于高性能操作和少量数据计算的场景. 当前,使用Redis的网站包括github和Engine Yard.
2,东京内阁和托科伊·暴君
TC和TT的开发者是日语的Mirao Hirabayashi,主要在日本最大的SNS网站mixi.jp上使用. TC最早开发,现在是Kye-Value领域中非常成熟的项目. 现在,最大的热点已在许多网站上广泛使用. TC是一种高性能的存储引擎,而TT提供了性能卓越的多线程高并发服务器,该服务器每秒可处理4-5百万次读写操作.
除了支持键值存储外,TC还支持保存Hashtable数据类型,因此它非常类似于简单的表,并且还支持基于列的条件查询,分页查询和排序功能,即基本相当于支持单个表的基本查询功能,因此它可以轻松替换关系的许多操作. 这是TC广受所有人欢迎的主要原因之一. 有一个Ruby项目miyazakiresistance,它将TT哈希表的操作封装为与ActiveRecord相同的操作. 使用起来非常酷.
在mixi的实际应用中,TC / TT已存储了超过2000万条数据,并支持数以万计的并发连接. 这是一个经过验证的项目. 在确保极高的并发读写性能的同时,TC具有可靠的数据持久性机制. 它还支持类似于关系表结构和简单条件,分页和排序操作的哈希表. 这是一个很棒的NoSQL.
TC的主要缺点是它没有扩展能力. 如果一台计算机不能满足要求,则只能通过主从复制进行扩展. 另外,有人提到TC的性能会随着数据量的增加而降低. 1亿后,性能将大大下降.
这是Tim Yang对Memcached,Redis和Tokyo Tyrant的简单性能评估,仅供参考
3,耀斑
TC由日本最大的SNS网站mixi开发,Flare由日本第二大SNS网站green.jp开发. 有趣. 简而言之,Flare向TC添加了比例功能. 他替换了TT部分,并为TC编写了Web服务器. Flare的主要功能是支持秤功能. 他在Web服务器之前添加了一个节点服务器,以管理后端的多个服务器节点,因此可以动态添加服务节点,删除服务器节点,还支持故障转移. 如果您的使用场景必须允许TC可扩展,则可以考虑耀斑.
flare的唯一缺点是它仅支持memcached协议,因此,在使用flare时,不能使用TC的表数据结构,而只能使用TC的键值数据结构进行存储.
2. 满足大容量存储需求和访问权限的面向文档的: MongoDB,CouchDB
面向文档的非关系型解决的主要问题不是高性能的并发读写,而是在拥有良好查询性能的同时确保海量数据存储. MongoDB用C ++开发,而CouchDB用Erlang开发:
1,MongoDB
MongoDB是关系和非关系之间的产品. 它是非关系中功能最全,最相似的关系. 它支持的数据结构非常宽松,并且是类似于json的bjson格式,因此可以存储更复杂的数据类型. Mongo的最大特点是它支持的查询语言非常强大. 它的语法有点类似于面向对象的查询语言. 它几乎可以实现与关系中的单表查询相似的大多数功能,并且还支持数据索引.
Mongo主要解决海量数据的访问效率问题. 根据官方文件,当数据量超过50GB时,Mongo的访问速度是MySQL的10倍以上. Mongo的并发读写效率不是特别好. 根据官方性能测试,它每秒可以处理大约5,000至1.5个读写请求.
由于Mongo主要支持海量数据存储,因此Mongo还附带了出色的分布式文件系统GridFS,它可以支持海量数据存储,但是我也看到一些评论说GridFS性能很差. 我仍然需要做一些测试来验证自己.
最后,由于Mongo可以支持复杂的数据结构并具有强大的数据查询功能,因此非常受欢迎. 许多项目正在考虑使用MongoDB代替MySQL来实现不是特别复杂的Web应用程序,例如为什么我们从MySQL迁移到MongoDB就是从MySQL迁移到MongoDB的真实案例. 由于数据量太大,因此向Mongo的迁移极大地提高了数据查询的速度.
MongoDB还有一个项目MongoMapper,它是由Merb的DataMapper编写的MongoDB的接口. 它非常易于使用,几乎与DataMapper完全相同,具有非常强大且易于使用的功能.
2,CouchDB
CouchDB现在是一个非常知名的项目,似乎不需要引入它. 但是我对CouchDB没有兴趣,主要是因为CouchDB仅提供基于HTTP REST的接口,因此CouchDB在并发读写性能方面非常糟糕,这使我立即放弃了对CouchDB的兴趣.
3. 满足高可伸缩性和可用性的面向分布式计算的: Cassandra,Voldemort
实际上,面向规模的解决的主要问题领域与上述两种类型的不同. 首先,它必须是分布式系统. 分布在不同节点上的一起构成服务系统. 并且基于此分布式体系结构提供联机,具有灵活的可伸缩性,例如,您可以在不停止机器的情况下添加更多数据节点,删除数据节点等. 因此,Cassandra通常被视为Google BigTable的开源版本的替代品. Cassandra和Voldemort都是用Java开发的:
1,卡桑德拉
Cassandra项目是Facebook在2008年开源的,然后Facebook本身使用了Cassandra的另一个分支,而该分支不是开源的. 开源Cassandra主要由亚马逊的Dynamite团队维护,并且Cassandra被认为是Dynamite 2.0版本. 除Facebook之外,twitter和digg.com目前还使用Cassandra.
Cassandra的主要特征是它不是,而是由一堆节点组成的分布式网络服务. 对Cassandra的写操作将被复制到其他节点,而对Cassandra的读操作为is,还将被路由到一个节点进行读取. 对于Cassandra集群,扩展性能相对简单,只需将节点添加到集群中即可. 我看到一篇文章说,Facebook的Cassandra群集具有一个包含100多个服务器的群集.
Cassandra还支持更丰富的数据结构和强大的查询语言. 它类似于MongoDB,查询功能比MongoDB稍弱. Twitter平台架构部门负责人Evan Weaver撰写了一篇有关Cassandra的文章: / up-and-running-with-cassandra /,其中有非常详细的介绍.
Cassandra由单个节点测量. 其节点的并发读写性能不是特别好. 一篇文章说,每秒评估Cassandra的读写请求少于10,000个. 我也看到了对此问题的一些怀疑. 注释,但是评估Cassandra单个节点的性能没有意义. 真正的分布式访问系统必须是由n个多个节点组成的系统. 它的并发性能取决于整个系统中的节点数和路由效率,而不仅仅是单个节点. 节点的并发负载容量.
2非关系型有哪些,伏地魔
Voldemort是一个分布式系统,旨在解决类似于Cassandra的规模问题. Cassandra来自Facebook的SNS网站,Voldemort来自Linkedin的SNS网站. 说到SNS网站,我们贡献了n个NoSQL,例如Cassandar,Voldemort,Tokyo Cabinet,Flare等. 伏地魔没有太多的信息,所以我没有仔细研究它. Voldemort正式表示,Voldemort的并发读写性能也非常好,每秒可读取和写入超过15,000.
从Facebook上的Cassandra和Linkedin上的Voldemort的发展,我们还可以粗略地看到国外大型SNS网站对分布式的需求,尤其是的规模功能. 如前所述,在Web应用程序体系结构中,Web层和App层相对易于水平缩放. 只有是单点,这极难扩展. 现在,Facebook和Linkedin正在探索非关系的分布式方面. 这是一个很好的方向,这也是Cassandra如此受欢迎的主要原因.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-289514-1.html
-

-
成真人
容许现在打击的红灯区的存在
 如何解决从win10应用商店下载的主题
 起点怎么注册作者 早读早分享》2018年2月15日周四(第803期)
 特别推荐:哪种华硕笔记本电脑性价比高,推荐华硕笔记本电脑性价比最高[图形]
 tms影院管理系统 阿里云智与辰星开启战略合作 打造未来智慧影院
呵呵