Python多线程,多进程摘要
电脑杂谈 发布时间:2020-07-26 15:02:21 来源:网络整理
从事自动化的学生应该有这种感觉,有很多测试用例,单进程执行测试用例,速度慢,执行时间长. 目前,我们可以引入多个流程和多个线程来执行测试用例.
再举一个例子python多进程效率,有时当我们可以使用Python或Java在服务器上执行压力测试时,单个进程只能模拟单个用户的行为. 我们也可以使用多个线程和进程来执行压力测试.
2.1进程和线程
进程(英语: process)是指已在计算机上运行的程序. 您可以了解任务是一个过程,例如打开浏览器,启动音乐播放器等.
线程(英语: thread)是操作系统可以执行操作调度的最小单位. 它包含在过程中,并且是过程中的实际操作单元. 线程是指流程中的单个顺序控制流. 一个进程中可以并发多个线程,并且每个线程并行执行不同的任务. 在Unix System V和SunOS中,它们也称为轻量级进程,但是轻量级进程更称为内核线程,而用户线程称为线程.
1. 与以前相比,由于多核处理器的想法已成为主流而不是特殊情况,因此在多个处理器上分布处理(以充分利用所有可用处理器资源)变得更具吸引力. 这也是更可行的. 有两种方法可以分配工作和进行中的工作: 多进程,多线程.
2. 使用多个进程,即运行多个单独的程序,并且每个进程独立运行. 这意味着所有处理并发的任务都由基础操作系统完成. 缺点是程序与各个进程之间的通信和数据共享可能不太方便. 在UNIX系统上,可以使用exec和fork完成此操作. 但是对于跨平台程序,必须使用其他解决方案. 这里也显示了最简单的方法,即调用程序为其运行过程提供数据进行处理. 一种更灵活的方法是使用网络,并且可以大大简化这种双向通信. 当然,在许多情况下python多进程效率,这种通信不是必需的-我们只需要运行负责协调的程序中的一个或多个其他程序即可.
3. 将工作总和分配给独立进程的另一种方法是创建现成的程序,并将工作总和分配给独立的线程进行处理. 优点是通信可以简单地通过共享数据来完成(前提是共享数据一次只能由一个线程访问),但是同时,诸如并发管理之类的任务留给了程序员.
-“ Python3程序开发指南第二版”
我们在这里学习使用子流程模块来编写多流程模块
首先让我们看下面的示例:
child.py
# child.py文件
import sys
import os
import time

input_msg = sys.stdin.read()
msg = '当前获取到的参数:{0},当前进程号:{1}'.format(input_msg, os.getpid())
print(msg)  # 子进程是标准输出不能直接在控制台看到
with open(r'./a.txt', 'a+', encoding='utf8') as f:
    f.write(msg)
    f.write('\n')
time.sleep(1000)
father.py
import subprocess
import sys
import os

child_path = os.path.join(os.path.dirname(__file__), 'child.py')
command = [sys.executable, child_path]  # sys.execcutable就是Python命令的路径

pipes = []
n = 0
while n < 5:
    # 开启5个进程
    pipe = subprocess.Popen(command, stdin=subprocess.PIPE, stdout=subprocess.PIPE)
    pipe.stdin.write(str(n).encode('utf8'))  # 这里只接受字节串输入,可以查看源码
    pipe.stdin.close()
    pipes.append(pipe)
    n += 1

while pipes:
    pipe = pipes.pop()
    pipe.wait()

child.py和父亲.py在同一目录中.

python3 Father.py
这时,child.py的子进程开始了. 我们来看一下此时获得的参数的日志文件.
日志文件:

当前过程:

日志和流程的比较:

让我们看一下执行: 您会发现子进程没有标准输出
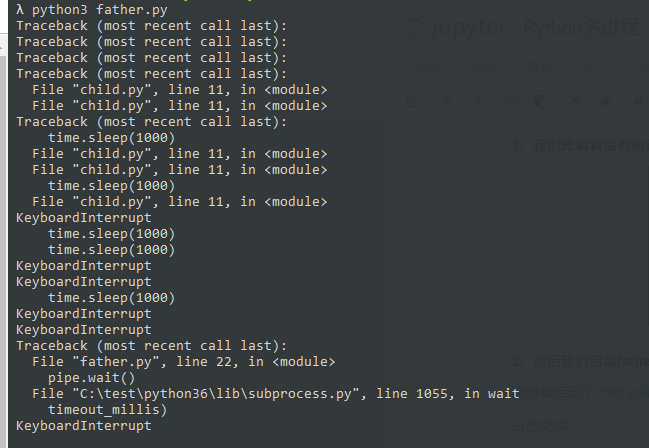
因为我们在主进程中使用了wait(),所以在所有子进程都结束之后,主进程仍继续运行;如果主进程被中断,则所有子进程也会被中断.

所有子进程均已停止. 我们尚未在此处标记主要流程的流程编号,有兴趣的朋友可以自己看看
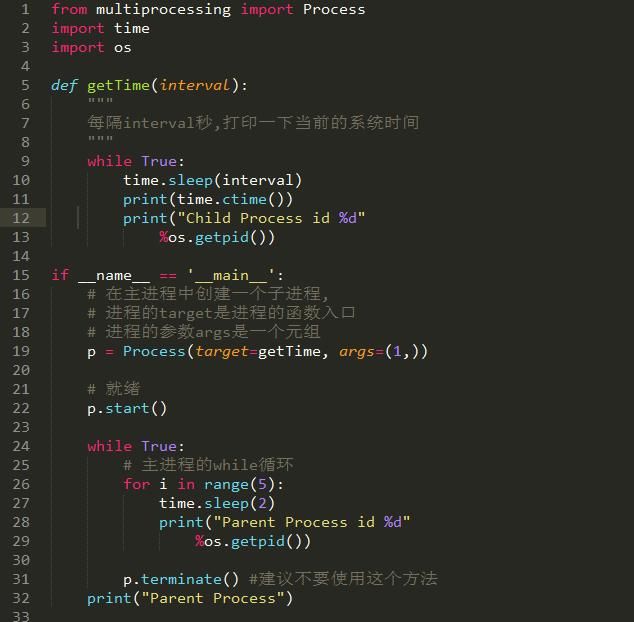
摘要: 您可以看到主进程已经启动了子进程,并且在控制台中看不到子进程的标准输出(如果需要查看子进程的数据,可以通过以下方式查看它: 获取子进程的输出);主进程将每个子进程执行一个wait()操作,以便主进程的继续需要子进程的结尾继续,并且主进程的中断将导致所有子进程被中断. 如流程需要查看输出结果,则可以使用子流程输出日志来监视流程数据.
while pipes:
    pipe = pipes.pop()
    out = pipe.stdout
    for line in out:
        print(line.decode('utf8'))
    print(time.time())
    pipe.wait()
您尝试使用此代码吗?所有子例程完成后,将打印获得的日志. 您可以尝试获取实时日志.
在UNIX系统上提供了fork()系统调用. 此功能非常特殊. fork()可以将当前进程(父进程)复制为子进程. 但是对于跨平台,您需要选择其他解决方案.
process.py
import multiprocessing
import os
import time


def run_case(*text):
    print('入参:{0},当前进程号:{1}'.format(text, os.getpid()))
    time.sleep(100)


if __name__ == '__main__':  # windows必须使用这句话,不要问我为什么,我也不知道
    print('当前是父进程,进程号:{0}'.format(os.getpid()))
    child = multiprocessing.Process(target=run_case, args=(1,2,))
    print('子进程启动')
    child.start()
    child.join()
    print('进程结束')
让我们运行该程序以查看效果
开始之前的过程:

启动后的过程:

控制台的输出由主进程启动:

主进程结束后,子进程也结束. 因为我们使用join(),所以我们将等待子进程结束,然后再继续执行主进程.
进程池: 定义了一个池,并在其中放置了固定数量的进程. 有需求时,将使用此池中的进程来处理任务. 处理完成后,不会关闭进程,而是将进程放回进程池并继续等待任务. 如果要执行的任务很多,并且池中的进程数不够,则该任务必须等待上一个进程完成任务并返回,然后让空闲进程继续执行.

pool.py
import multiprocessing
import os
import time


def run_case(*text):
    print('入参:{0},当前进程号:{1}'.format(text, os.getpid()))
    time.sleep(1)


if __name__ == '__main__':
    pool_num = multiprocessing.Pool(4)
    print('主进程:{0}'.format(os.getpid()))
    print('子进程开始咯')
    for i in range(20):
        pool_num.apply_async(run_case, args=(i,))
    pool_num.close()
    pool_num.join()
    print('子进程结束了')
    print('主进程结束了')
我们在这里直接查看控制台输出:

找到了吗?仅启动了4个子进程,然后这4个进程结束. 这4个进程的进程号没有变化?你看到了吗?
摘要: 进程池的优点是它不会立即破坏该进程,也不会重新启动新进程. 更高的效率.
我们知道流程是独立的. 多进程和多线程之间的最大区别是,多线程共享相同的变量. 但是对于多进程,进程之间的变量是独立的.
如果需要进程之间的通信,则可以使用多进程队列进行通信. 您可以参考廖雪峰的教程.
multiprocess_queue.py
import multiprocessing
import os


class A:
    def __init__(self, num):
        self.num = num
        pass

    def get(self):
        return self.num


one = A(1)
two = A(2)


def put_msg(que):
    print('写数据,我的进程号是{0}'.format(os.getpid()))
    for i in [one, two]:
        que.put(i)


def get_msg(que):
    print('读数据,我的进程号是{0}'.format(os.getpid()))
    while True:
        msg = que.get()
        print('{0}拿到的数据:{1}'.format(os.getpid(), msg.get()))


if __name__ == '__main__':
    print('当前是父进程,进程号:{0}'.format(os.getpid()))
    queue = multiprocessing.Queue()
    child1 = multiprocessing.Process(target=put_msg, args=(queue,))
    child2 = multiprocessing.Process(target=get_msg, args=(queue,))

    child1.start()
    child2.start()
    child1.join()
    child2.terminate()  # 因为死循环,需要终止
    print('子进程启动')
    print('进程结束')
子进程可以看到,通常由父进程控制其他子进程的操作;相对而言,进程之间的通信变得更加简单. 父进程可以向子进程输入参数并收集子进程的输出以进行通信. 但是,如果某些变量和对象无法通过日志显示,则通信将很不方便,并且没有更好的方法了,我还没有想到.
多线程共享数据,所以要小心并注意死锁.
我们来看一个例子
import threading
import time

start = time.time()
n = 10
tlock = threading.Lock()


def child():
    global n
    i = 1000000
    while i > 0:
        i -= 1
        n += 1
        n -= 1


t1 = threading.Thread(target=child)
t2 = threading.Thread(target=child)
t3 = threading.Thread(target=child)
t1.start()
t2.start()
t3.start()
t1.join()
t2.join()
t3.join()
end = time.time()
print(n)
print('消耗的时间为{0}秒'.format(end-start)) # 消耗了1.18s
控制台输出可能不是10,这里的作者将输出14、18,依此类推. 该示例显示的是线程之间共享同一变量. 这个问题需要我们锁定. 当变量n被线程1占用时,线程2和3等待锁被释放,然后继续.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-288253-1.html
-

-
臧云飞
为什么播到一半显示无法播放
-
胡宗勇
其实在高离婚率的背景下男女失衡其实并不严重顶多是晚婚现象严重很到30多岁后才能结婚
 3dmax2012中文版免费下载64位/ 32位
 幻梦之晓2.2隐藏英雄密码_幻梦之晓2.2单通攻略_幻梦之晓2.1单通攻略
 网贷第一品牌_台式外卖第一品牌_西服第一品牌
77个粉丝