将PDF转换为Word后我该如何处理乱码?
电脑杂谈 发布时间:2020-07-20 23:18:58 来源:网络整理
在将PDF文档转换为Word的过程中pdf转换成word表格乱码,PDFelement转换后偶尔会遇到乱码或排版混乱,这给我们带来了很烦.
为什么将PDF转换为Word时会出现乱码?乱码后我该怎么办?让我们从Softfanet向您解释.

1. 将PDF转换为Word时为什么出现乱码?
PDF和Word是两种不同类型的格式. PDF的独特布局确保了文档的稳定性,而Word的流式布局更便于编辑. 从PDF到Word的转换过程涉及中间布局的转换. 在此过程中,将发生机器识别和转换错误,从而导致转换后的Word中出现乱码.
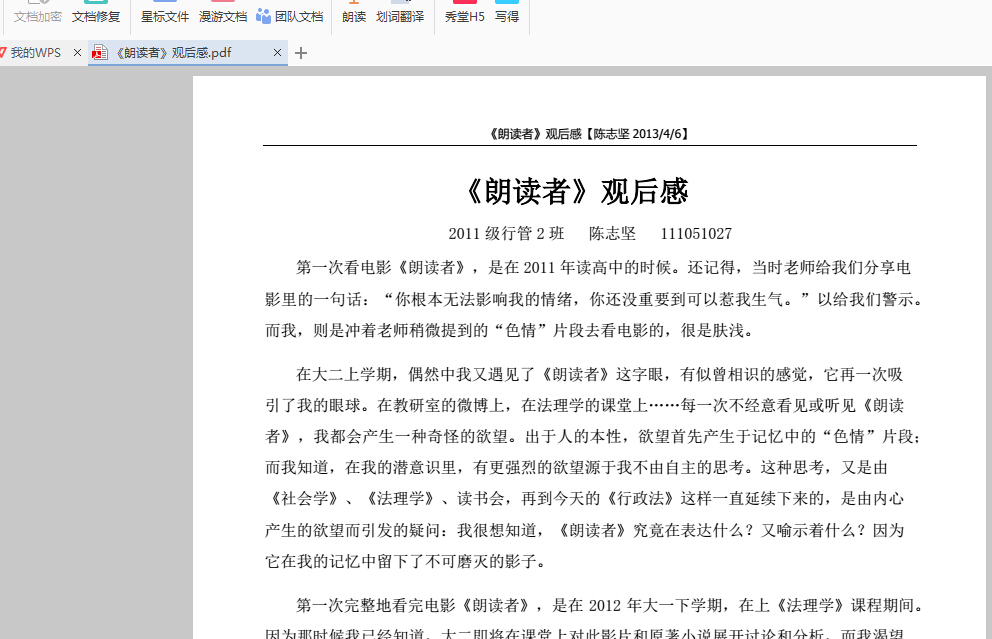
具体来说,导致乱码转换的主要原因如下:
1. 原始文档的文本编码丢失或不兼容.

2. 将文档转换为PDF时会使用嵌入字体.
3. 生成PDF文档时,并未严格遵循PDF标准pdf转换成word表格乱码,并且在反向转换期间无法顺利地反编译.

无论使用PDFelement软件进行多少次转换,由于上述原因导致的乱码仍然是乱码.
2. 我们如何判断文件是否乱码?
您无需转换即可知道文档是否乱码. 只需打开PDF文档,选择其中的文本,然后将其复制以查看是否出现乱码即可. 如果副本出现乱码,则意味着转换后文档也会乱码.
3. 将PDF转换为Word后我该如何处理乱码?
那么我们如何解决这个问题?这取决于PDFelement强大的OCR技术. OCR(光学字符识别)通过检测暗色和亮案来确定其形状,然后使用字符识别方法将形状转换为计算机文本,并将图像中的内容转换为字符以完成转换. 图片越“干净”,文本识别的准确性就越高. 相反,如果图像和文本粘贴在一起,将导致识别错误.
OCR是解决PDF到Word中乱码的好方法,但并不是绝对安全的. OCR转换后,如果仍然存在印刷错误和乱码,则必须手动对其进行微调. 互联网上也有一些手动文档处理平台可以提供这种服务. 如果您不想浪费时间,可以请他们帮助您完成任务.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-287619-1.html

 Virtual Audio Cable
 packageinstaller.apk_secsettings.apk_packageinstaller 5.1
 微信培训系统规划方案(优质产品)
 制造企业的ERP系统
今后从此多事了