如何将PDF扫描转换为可以复制文本的双层PDF?
电脑杂谈 发布时间:2020-06-30 12:35:30 来源:网络整理
PDF扫描由图片组成,并且文本不能直接复制. 如果要使用图片制作双层pdf文件,也可以直接复制文本. 你怎么能做到呢?我们可以使用Acrobat软件,也可以使用该软件随附的OCR识别工具在PDF文档中添加一层透明文本,以创建双层PDF. 使PDF看起来像扫描的副本,但是您可以直接复制文本,让我们看一下下面的详细教程.
1. 以下是通过扫描生成的PDF文档. 可以看出文本不能直接复制.
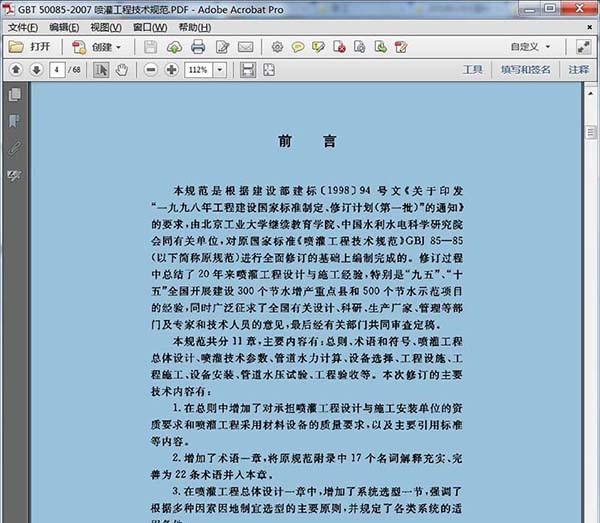

2. 单击Acrobat软件工具栏右上角的“工具”选项,打开“文本识别”,然后单击“在此文件中”.

3. 在弹出的“识别文本”对话框中,单击“编辑”以设置文本识别参数.

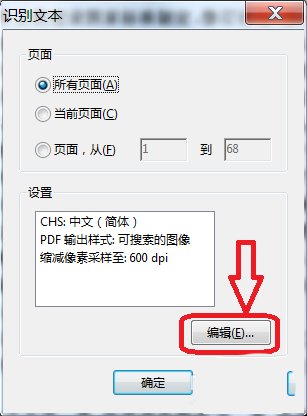
4. 文字识别参数设置: OCR识别的主要语言(此处选择简体中文);
PDF输出样式: 可搜索图像pdf文档如何复制文字,可搜索图像(准确),ClearScan(此处保留默认值);

将像素采样率降低到: 600、300、150、72dpi(如果要打印,建议不小于150dpi).
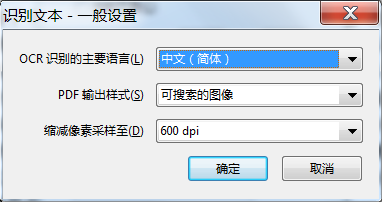
5. 设置字符识别参数后,单击“确定”开始字符识别.

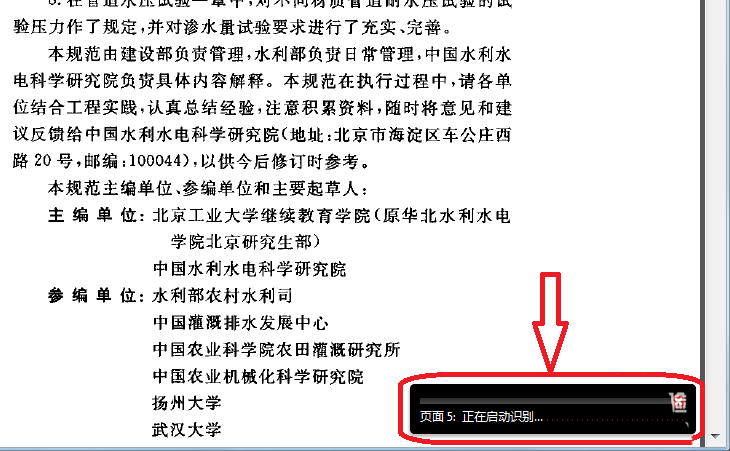
6. 您可以在软件界面的底部看到一个文本识别进度栏. 如果文件很大,识别时间将更长. 这是我们可以做的.
7. 文本识别已完成,您可以看到可以使用文本选择工具将其选中. 可以看出,识别精度还是比较高的,如果需要校对文字pdf文档如何复制文字,可以参考相关的教程.

8. 对比度是可见的. 添加透明文本层后,它对源文件的大小影响很小.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-263543-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论
-

-
杨嘉良
我算是写过的
 robotium和appium区别_robotium_手机自动化测试工具
 帮助冠科CRM-一个简单易用的客户管理系统
 老夫子有挂吗 沧州圈子开挂助手通用版
 TMS运输管理系统
成了该地区的主要威胁