软件体系结构设计学习摘要(二): 如何逐步构建大型网站体系结构
电脑杂谈 发布时间:2020-06-18 00:27:46 来源:网络整理
今天,我们逐步讨论网站通常如何构建系统架构. 尽管我们希望网站从一开始就具有良好的架构,但是告诉我们,事情在不断发展中. 随着业务的发展和用户需求的提高,网站的架构也在不断完善. 以下是网站架构逐步发展的基本过程. 阅读后,请考虑一下您现在的位置.
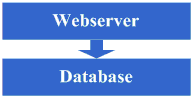
架构发展的第一步: WebServer和的物理分离
起初,由于一些想法,网站是在Internet上建立的. 这时,甚至可能是主机被租用了,但是由于本文仅关注体系结构的演变,因此假设这次是托管主机,并且具有一定的带宽. 这时,由于网站具有一定的特征并吸引了一些人访问,因此您逐渐发现系统的压力越来越大,响应速度越来越慢. 这时,和应用程序相互影响,并且应用程序出现问题,这一点更加明显. 另外,也容易出现问题,并且当出现故障时,应用程序也容易出现问题. 因此它进入了发展的第一阶段: 将应用程序和物理上分为两台机器. 目前,没有新的技术要求,但是您发现它确实起作用,并且系统已还原到以前的要求. 响应速度快,并支持更高的流量,并且不会因为和应用程序而相互影响.
完成此步骤后,请查看系统图标:
架构发展的第二步: 增加页面缓存
好时光不长. 随着越来越多的人来访,您发现响应速度再次放慢. 找出原因,并发现太多的操作无法访问,从而导致数据连接竞争激烈,因此响应速度变慢. 但是连接不能打开太多,否则机的压力会很高,因此请考虑使用缓存机制来减少连接资源的竞争以及对读取的压力. 此时,首先,您可以选择使用类似的机制(例如squid)在系统中缓存相对静态的页面(例如,将在一两天内更新的页面)(当然,您也可以使用页面的静态解决方案). 您可以不加修改地减轻WebServer的压力,并减少对连接资源的竞争. 好的,所以我开始使用Squid来缓存相对静态的页面.
完成此步骤后,请查看系统图标:
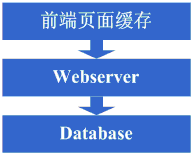
此步骤涉及以下知识系统:
首页缓存技术,例如Squid,要想很好地使用它,必须对Squid的实现和缓存失效算法有深刻的了解.
架构演进的第三步: 增加页面片段缓存
在将Squid添加为缓存后,整个系统的速度确实增加了网页框架设计软件,WebServer上的压力也开始减少,但是随着访问次数的增加,系统又开始变慢. 在品尝了像Squid这样的动态缓存的好处之后,我开始怀疑这些动态页面的相对静态部分是否也会被缓存,因此我考虑使用诸如ESI,OK这样的页面片段缓存策略,因此开始使用ESI相对缓存动态页面中的静态片段.
完成此步骤后,请查看系统图标:

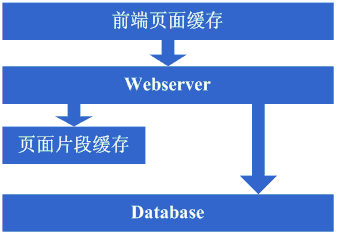
此步骤涉及以下知识系统:
页面片段缓存技术,例如ESI等,如果要很好地使用它,还需要掌握ESI等的实现;
架构演进的第四步: 数据缓存
在采用ESI之类的技术再次提高系统的缓存效果之后,对系统的压力进一步减小,但是随着访问次数的增加,系统开始变慢. 搜索之后,您可能会发现系统中有些地方反复获取数据信息,例如获取用户信息等. 这时,它开始考虑是否也可以缓存数据信息,因此要缓存数据在本地内存中并完成更改. 此后,它完全达到了预期,恢复了系统的响应速度,并再次减轻了上的压力.
完成此步骤后,请查看系统图标:
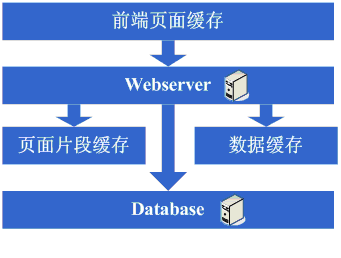
此步骤涉及以下知识系统:
缓存技术,包括Map数据结构,缓存算法和所选框架本身的实现机制.
架构发展的第五步: 添加WebServer
好时光不长. 可以发现,随着系统流量再次增加,Web服务器计算机的压力在高峰时段将上升到一个相对较高的水平. 这时,我们开始考虑添加Web服务器. 这还可以同时解决可用性问题并避免出现单一故障. 如果工作站的Web服务器已关闭,则无法使用它. 在考虑了这些因素之后,决定添加一个Web服务器. 添加网络服务器时,您会遇到一些问题. 典型的是:
1. 如何分配对两台计算机的访问权限,这时通常考虑的方案是Apache随附的负载平衡方案,或LVS之类的软件负载平衡方案;
2. 如何维持状态信息(例如用户会话等)的同步. 此时,将考虑的方案是用于写入,写入存储,cookie或同步会话信息的机制;
3. 如何使数据高速缓存信息(例如先前高速缓存的用户数据)保持同步,这时,通常考虑的机制是高速缓存同步或分布式高速缓存;

4. 如何使这些类似的文件上传功能继续正常工作,这时通常考虑的机制是使用共享文件系统或存储设备等;
解决了这些问题后,Web服务器最终增加到了两个,系统最终恢复到以前的速度.
完成此步骤后,请查看系统图标:
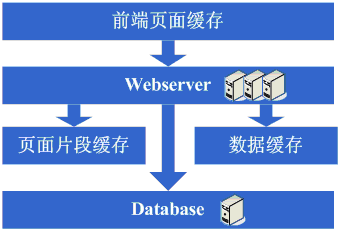
此步骤涉及以下知识系统:
负载均衡技术(包括但不限于硬件负载均衡,软件负载均衡,负载算法,Linux转发协议,所选技术的实现细节等),活动和备用技术(包括但不限于ARP欺骗) ,linuxheart-beat等),状态信息或缓存同步技术(包括但不限于Cookie技术,UDP协议,状态信息广播,所选缓存同步技术的实现细节等),共享文件技术(包括但不限于)限于NFS等),存储技术(包括但不限于存储设备等).
架构演进的第六步: 子库
在享受一段时间的系统访问快速增长带来的快乐之后,我发现系统再次开始变慢. 这次是什么情况?搜索之后,我发现这些的某些写入和更新操作已连接. 资源竞争非常激烈,这导致系统速度变慢. 我该怎么办?目前,可用的选项是集群和子库策略. 像某些一样,群集不能很好地支持它,因此子库将成为一种更为常见的策略,并且子库意味着可以修改原始程序. 修改并实现该库后,确实达到了目标,并且系统恢复比以前更快.
完成此步骤后,请查看系统图标:
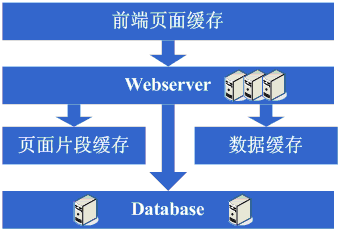
此步骤涉及以下知识系统:
此步骤更多地是需要与业务进行合理划分以实现子库,没有其他特定的技术细节;但是随着数据量的增加和子库的发展,的设计,调优和维护都需要做得更好,因此对技术的这些方面仍然有很高的要求.
架构演进的第七步: 子表,DAL和分布式缓存
随着系统的连续运行,数据量开始显着增加. 这时发现分割库后查询还是有点慢,所以我开始根据库的思想进行表分割工作. 当然,这不可避免地需要对该程序进行一些修改. 也许此时,您会发现应用程序本身应该关注子和子表的规则,这仍然有些复杂. 因此,梦生是否可以添加通用框架来实现子库和子表的数据访问. 这对应于eBay架构中的DAL. 这种演变过程需要相对较长的时间. 当然,在完成子表之前,也可能不会启动该通用框架. 同时,在此阶段,您可能会发现以前的缓存同步方案存在问题,因为数据量太大,现在无法在本地存储缓存,然后同步方法需要分布式缓存方案. 因此,在进行了又一次的调查和折磨之后,大量的数据缓存最终转移到了分布式缓存中.

完成此步骤后,请查看系统图标:
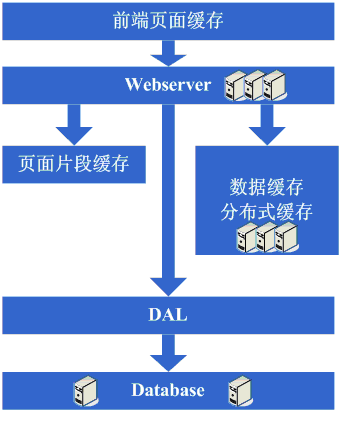
此步骤涉及以下知识系统:
子表更多是一个业务部门,该技术涉及动态哈希算法,一致性算法等; DAL涉及更复杂的技术,例如连接管理(超时,异常),控制操作(超时,异常),库和表规则的封装等;
架构演进的第八步: 添加更多WebServer
在完成子和子表的工作之后,上的压力已降低到一个相对较低的水平,我开始每天看着流量增加而过着幸福的生活. 突然有一天,我发现系统的访问再次开始变慢. 这时,我首先检查了,压力一切正常,然后检查了Web服务器,发现apache阻止了许多请求,而应用程序服务器对每个请求的速度都相对较快. 请求的数量似乎太多,这导致需要排队等待,并且响应速度变慢. 这很容易处理. 一般来说,这时会有些钱,因此添加一些Web服务器服务器. 在添加Web服务器服务器的过程中,可能会遇到一些挑战:
1. Apache的软负载或LVS软负载无法承受庞大的Web访问(请求的连接号,网络流量等)的调度. 此时,如果资金允许,解决方案将是购买硬件负载平衡设备,例如F5,Netsclar,Athelon等. 如果资金不允许网页框架设计软件,解决方案将是对应用程序进行逻辑分类,然后进行分发进入不同的软负载集群;
2. 某些原始状态信息同步和文件共享方案可能存在瓶颈,需要改进. 也许这次,将根据情况编写满足网站业务需求的分布式文件系统;
完成这些任务后,我们开始进入看似完美的无限扩展时代. 当网站流量增加时,解决方案是不断添加Web服务器.
完成此步骤后,请查看系统图标:
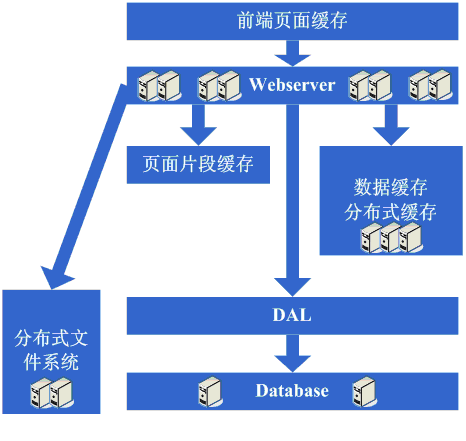
此步骤涉及以下知识系统:
通过此步骤,随着机器数量的不断增加,数据量的不断增加以及对系统可用性的要求越来越高,这次需要对使用的技术和需求有更深入的了解产品根据网站的需求.
架构演进的第九步: 数据读写分离和廉价的存储解决方案
突然有一天,我发现这个完美时代即将结束,的噩梦再次出现. 由于添加了太多的Web服务器,因此连接资源仍然不足. 此时,已分为表和表. 开始分析的压力情况,您可能会发现的读写比率非常高. 我想到了一种分离数据读写的方案. 当然,这种解决方案并不容易实现. 此外,您可能会发现有些数据在中存储有些浪费,或者占用了过多的资源. 因此,在这一阶段可能形成的体系结构演变是实现数据读写分离,并编写一些更便宜的存储解决方案,例如BigTable.
完成此步骤后,请查看系统图标:

此步骤涉及以下知识系统:
数据读写分离需要对复制,备用和其他策略以及自我实现的技术有深入的了解和理解;廉价的存储解决方案需要对OS的文件存储有深入的了解和理解,并且对文件中使用的语言的实现有深刻的了解.
架构演进的第十个步骤: 进入分布式应用程序时代和廉价服务器场的梦想时代
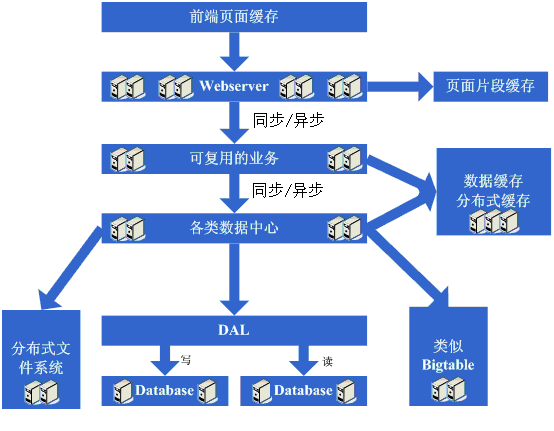
经过上述漫长而痛苦的过程,我们终于再次迎来了一个完美的时代. 越来越多的Web服务器可以支持越来越多的流量. 对于大型网站,普及的重要性无疑是重要的. 随着日益普及,各种功能需求已开始爆炸性增长. 这时,我突然发现部署在Web服务器上的原始Web应用程序已经非常大. 当多个团队开始对其进行修改时,这确实很不方便,可重用性也很差. 基本上,每个团队都做了或多或少的重复性工作,并且部署和维护也很麻烦. 由于在N台计算机上复制和启动庞大的应用程序包需要花费大量时间,因此检查是否有问题不是很容易. 另一个更糟糕的情况是应用程序中可能存在错误. 结果,整个工作站不可用,还有其他因素,例如调整不容易操作(因为部署在机器上的应用程序必须做所有事情,根本不可能执行目标调整). 根据此分析,它开始受伤. 下定决心并根据您的职责拆分系统,因此诞生了一个大型分布式应用程序. 通常,此步骤需要很长时间,因为您将遇到许多挑战:
1. 分解为分布式后,需要提供一个高性能,稳定的通信框架,并且需要支持各种不同的通信和远程调用方法;
2. 拆分大型应用程序需要很长时间,并且需要整理业务并控制系统依赖项;
3. 如何很好地运行和维护(取决于管理,操作状态管理,错误跟踪,调整,监视和警报).
此步骤之后,几乎系统的体系结构已进入相对稳定的阶段,与此同时,它也可以开始使用大量廉价机器来支持大量访问和数据. 将这种架构与从众多演变中获得的经验相结合,以使用其他各种方法来支持不断增长的访问.
完成此步骤后,请查看系统图标:
此步骤涉及以下知识系统:
此步骤涉及许多知识系统,需要对通信,远程调用,消息机制等有深入的了解和掌握. 这些要求来自理论,硬件级别,操作系统级别和使用的语言实现有一个清晰的认识.
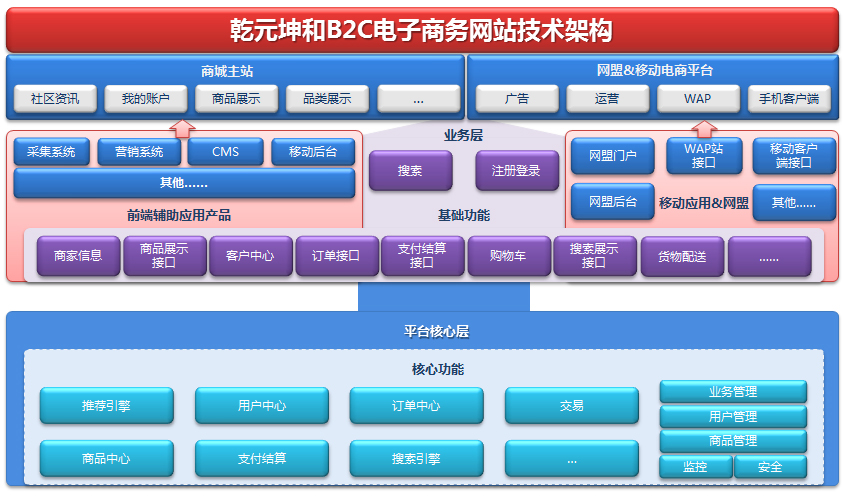
最后,附上一个大型网站架构图:
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-249124-1.html
-

-
明元帝拓跋嗣
图四炸了
-
思无邪
从当年替八国联军运输
 “喜欢某人”有多少个翻译?
 cs生化狂潮4_cs1.6生化狂潮3_cs生化狂潮下载
 2019年电动自行车行业的大事件!
 宅米skt?宅米为什么破产啊?宅米网iPhone版
浪费材料与资金