Python练习的第九个问题,爬行帖子栏的图片
电脑杂谈 发布时间:2020-06-07 19:32:01 来源:网络整理优化阅读Python练习的第九个问题贴吧 吧图片,爬行帖子栏的图片
杉本有美丽_杉本有美丽_
打开网站Sugimoto Yumei_Sugmoto Yumei_Biedu Tieba,F12

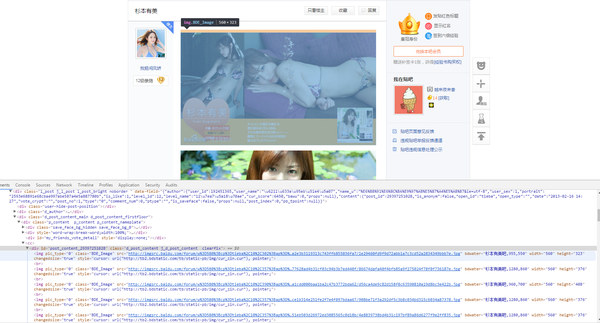
我发现图像链接都在标签
中
<cc>
    <div...>
       <img...>
       <img...>
测试发现src中的链接是图片链接. 然后非常简单,只需在中取出src的链接即可.
环境: Python3,Pycharm
使用请求和xpath,我最近学习了xpath,发现它超级好用. 它比bs4简单. 我有兴趣查看此爬虫条目,以进行熟练的网页分析(xpath)-了解该列
import requests
from lxml import etree
url = http://tieba.baidu.com/p/2166231880
header = {User-Agent:Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87 Safari/537.36}
r = requests.get(url,headers=header).content
s = etree.HTML(r)
print(s.xpath(//div/img/@src))
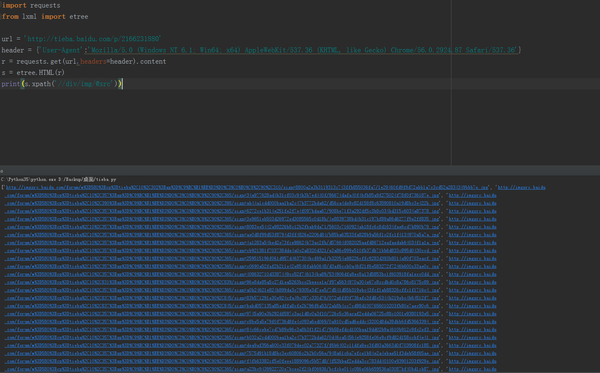
我发现所有链接都可用,下一步就是下载〜
下载图片的声明:
import urllib.request
path = ...... #下载链接
jpg_link = ......  #图片链接
request.urlretrieve(jpg_link, path)
一起完成了.

经过测试,帖子栏中的其他网页如下: [Sabra] [08-04]严格限制女孩为早妃
顺便提一下贴吧 吧图片,可以下载此代码.
1. 图片名称使用图片链接中的名称,其中包含大量数字和字母,可以进行优化.
2. 如您所见,下载文件包含一个图释. 检查它是否由用户发送,表明过滤存在问题.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-237497-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论

每日福利
 局域网管家监控 V2014.05 绿色破解版最新无限制版测试可用[联网软件]
 做用ip地址干嘛用 网上找赚钱靠谱吗?正规网络是怎么做的
 游戏充值平台代理加盟 【图】牛大王平台新款游戏 拼三大王 诚招总代理锦州太和
 超级兔子杀毒_无法连接虚拟磁盘服务_超级兔子虚拟磁盘
热点图片
也绝不会再让国人蒙羞的