如果pdf将文本复制为乱码,该怎么办?
电脑杂谈 发布时间:2020-05-13 17:07:49 来源:网络整理
Pdf是一种常用的文件格式,它可以确保同一文件在不同平台和不同终端上的布局效果相同.
据一般用户理解,pdf可分为两种类型,一种是图片型pdf,另一种是文本型pdf. 图片类型pdf通常是通过扫描获得的pdf文件. 其特点是每个pdf都是图片,并且上面的文本信息不能直接复制pdf文本怎么复制文字,如下所示.
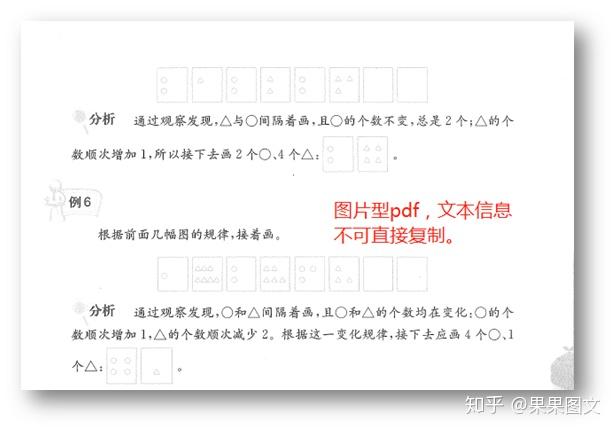

文本pdf通常由word,indesign和其他图形和文本编辑软件生成. 功能是pdf页面非常清晰. 文本可以直接复制并粘贴到其他编辑器中,例如word. 可以直接复制的性能是可以使用文本工具直接在pdf中选择文本. 如下所示.
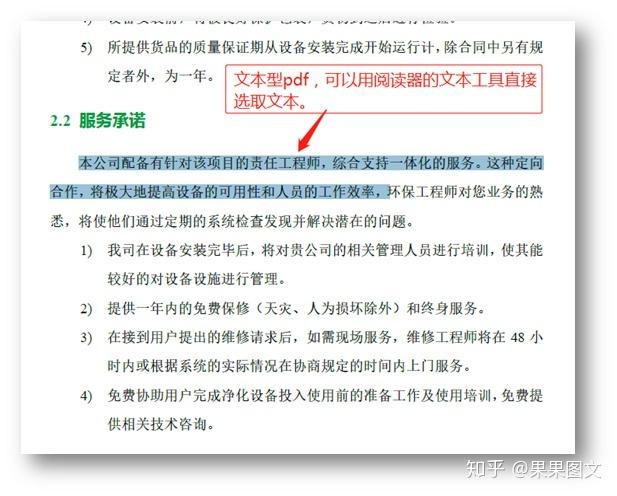
我们获得了pdf,不仅用于阅读,而且用于内容. 可以直接复制的pdf文本当然是最容易获得文本信息的方法,但是有时仍然会遇到这种情况: 在pdf文件中选择文本并将其粘贴到其他软件中时,例如单词,乱码. 以下列出了我遇到的两种情况以供参考.

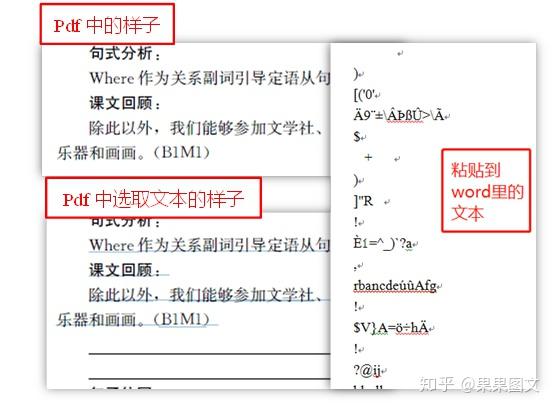
第一种情况,如下图所示.
PDF格式的文本非常清晰且正常. 但是,使用文本工具选择时,没有出现正常的浅蓝色背景颜色选择状态pdf文本怎么复制文字,但是出现了浅蓝色的不规则下划线状态. 粘贴到单词中后,显示的是非常奇怪且无关的字符,并且行数明显多于原始文本.

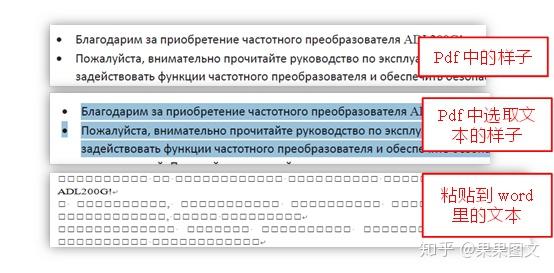
情况二,如下图所示.
这是俄语. 文本非常清晰且以pdf格式正常显示. 使用文本工具进行选择时,将选择普通的浅蓝色背景. 粘贴到单词中后,几乎会显示所有框,并且某些英文字母和数字是正确的. 您可能认为这是一种字体问题,但是在更改了几种支持俄语的字体之后,情况没有改变. 这不应该是字体问题.

粘贴pdf文本后出现乱码问题,本质上应该是文本符号编码的问题. 唐彤非常的答案中有一些详细的说明,链接如下
zhihu.com/question/21662770/answer/44317847
了解文本编码的人们应该能够很好地理解和解决此问题,但是他们必须具有一些知识. 对于普通的图形工作者来说,这很难做到.
因此,在这种情况下,最简单,最无礼的方法仍然是使用OCR软件进行识别,就像处理pdf图片一样. 由于这些pdf文件非常清晰,因此OCR识别也可以获得令人满意的结果.
OCR是指光学字符识别技术,著名的软件是ABBYY FineReader.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-208841-1.html
-

-
藤村歩
免得百拳来
-
王美霞
实在不行拍拍屈股跑路
-
 什么时候报名参加2020年福建函授学院漳州函授学院?
 在假期期间,证券公司高层的高层变化经历了悲伤和喜悦!光大来到新任总裁,东海证券从监管部门接任主管.
 下载unYYWS V1.30,它是用于反编译电子书的强大工具,电子书的反破解版本
 如何为Windows 10下载OneNote 2016
超喜欢千玺