尚书7号(文本识别软件)下载简体中文版
电脑杂谈 发布时间:2020-05-04 16:10:33 来源:网络整理
标签: OCR识别文本识别软件
如何使用尚书7号?尚书7号ocr,尚书7号软件,尚书7号官方下载,尚书7号破解版,尚书7号下载,此软件系统使用OCR(光学字符识别)技术,以便结识书籍,报纸和杂志,报告记录,为满足正式文件等输入要求而设计的软件系统.
此软件系统是OCR(光学字符识别)技术,旨在满足书籍,报纸和杂志,报告笔记,正式文件等的输入要求. 当前,许多信息资料需要转换为电子文件为了方便各种应用程序和管理,但由于信息的数字处理方式落后,不仅耗时费力尚书七号ocr识别pdf,而且资本消耗巨大,导致大量的文档积压,因此,快速高效的软件系统满足这种大量输入的要求.
上书7号下载系统是适用于个人,小型图书馆,小型档案馆和小型企业进行文档输入,书籍重印和大量数据数字化的软件系统.

可识别的字符简体字符集: GB2312-80的一年级和二年级的6800多个汉字. 纯英文字符集. 简体字和繁体字: 除了简体字之外尚书七号ocr识别pdf,您还可以混合使用5,400多个繁体字,以及繁体字和GBK汉字.
识别字体类型. 它可以识别上百种字体,例如“歌曲”,“模仿歌曲”,“凯”,“黑”,“魏贝”,“李书”,“原书”,“兴凯”,并且支持多种字体.
识别字体大小,初始编号和小的第六种字体.
表单识别它可以自动判断,拆分,识别和恢复各种常规打印表单.
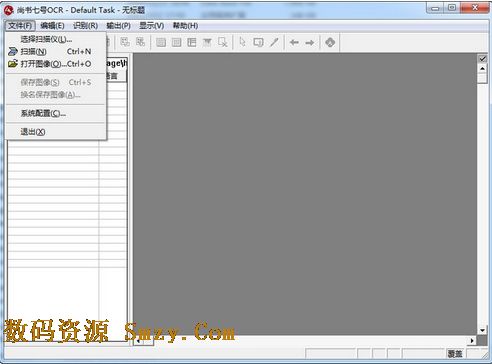
尚书7号下载ocr可以支持传统的WINDOWS系统
使用扫描仪扫描的文本图像无法编辑或修改单个文本. 在教学中,需要使用文本识别软件来识别文本图像并将图像格式转换为文本格式. 普通的文本识别软件很多,主要功能基本相同,尚书7号就是其中的佼佼者. 尚书7号的文本和图像识别和转换过程可以很容易地通过其主菜单完成: “文件”,“编辑”,“识别”和“输出”.
第1步: 获取文本图像文件.
在“文件”菜单下选择“扫描”或“打开图像”(打开扫描的图像文件)命令以打开图像文件. 如果连接了多台扫描仪,则可以通过选择“文件”菜单下的“选择扫描仪”命令来调用扫描仪.

第2步: 调整扫描的图像页面
在“编辑”菜单下的“图像页面处理”子菜单下选择命令“图像页面的倾斜校正”(提供自动和手动实现方法)和“旋转”,以调整扫描的图像页面.
第3步: 布局分析和文本识别转换
布局分析,选择识别范围,然后选择识别范围,然后再执行文本识别. 识别过程的核心是“布局分析”. 尚书7号的自动版面分析功能非常强大,可以对报纸和杂志等复杂版面保持较高的分析准确率.

设置后,直接单击“开始识别”按钮以执行文本识别.
第4步: 校对和修改
自动识别后,将弹出识别结果的“文本窗口”. 该窗口可以提供对识别结果的校对. 为了方便校对,Shangshu 7添加了一种校对方法,使光标跟随原始图像行(如图3所示,显示提示行).
提供的校对方法,您可以一目了然地看到原始文本和可识别文本之间的差异,如果发现识别错误,则可以对其进行修改.
第5步: 输出
如果您检查修改并确认修改正确,请选择识别结果的“输出”菜单. 输出文件格式为: RTF,HTML,XLS,22238. 可以根据需要选择相应的格式. 如果用户希望获得类似原始文本的识别结果,请选择RTF格式. 用WORD打开RTF格式的输出文件后,您会发现几乎所有原始文本的痕迹,包括原始页面上的彩像,都保留在WORD中.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-198811-1.html
-

-
肖鑫
感觉世界就是美国家开的
 qq炫舞记忆助手免费高分最新版?qq炫舞心动值一天上限?qq炫舞怎么开挂啊?qq炫舞记忆助手免费高分
 独家率先支持Win8 驱动精灵2011 SP2发布!
 酒店管理系统 金有哪些赌牌技术-”高校与行业企业的信息不对称
却患了重病