尚书7月ocr V2018免费版
电脑杂谈 发布时间:2020-05-04 16:08:51 来源:网络整理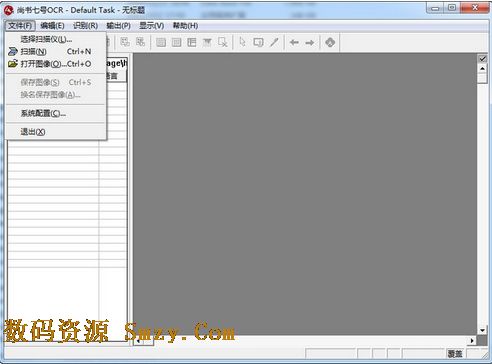
尚书7号ocr是一款非常实用的文本识别软件. 它可以支持GB2312-80的所有第一级和第二级汉字,总共支持6800多种,并且可以将图片中的文本转换为通用格式,例如用于编辑操作的单词. 它还提供了超过100种字体的标识,例如Song,Imitation,Kai,Hei,Weibei,Lishu,Round尚书七号ocr识别pdf,Xingkai等. 它非常且功能强大,通常用于扫描书籍,报纸,报纸和杂志. ,正式文件和报价单欢迎免费下载其他文本文件.
PS: 提供尚书7号的ocr破解版,并提供序列号和详细的教程供用户参考.

1. 在此站点上下载并解压缩软件安装包后,双击其中的“ Setup.exe”以开始安装软件,然后单击“下一步”.
2. 输入序列号: SSH7020020307. 通常,它将默认显示. 如果没有,请自行输入,然后单击“下一步”.
3. 选择软件安装目录,默认安装目录为: C: \ SHOCR2002.

4. 最后,等待尚书7 ocr文本识别软件的安装和破解,您可以永久免费使用尚书7 ocr破解版.
1. 可识别的字符简化的字符集: GB2312-80的所有第一级和第二级汉字都超过6,800.
2. 纯英文字符集.
3. 简体中文和繁体中文字符: 除了简体中文字符,您还可以混合使用5,400多个繁体中文字符以及繁体中文和GBK汉字.
4. 识别字体类型. 它可以识别上百种字体,例如“歌曲”,“模仿歌曲”,“凯”,“黑”,“微贝”,“李书”,“原书”,“兴凯”等,并支持多种字体.
5. 识别字体的初始编号. 小六号字体.

6. 表单识别可以自动判断尚书七号ocr识别pdf,拆分,识别和还原各种常规打印表单.
7. 尚书7号的ocr破解版可以支持传统的WINDOWS系统.
1. 运行该软件,然后在文件菜单的下拉列表中打开图像.
2. 从打开的图像文件中找到文件,选择它,然后单击打开按钮.
3. 如果我只需要识别一些文本,请在编辑区域中选择要识别的文本.
4. 然后在菜单项点开始识别,或直接按F8功能键.

5. 识别完成后,将显示以下内容,然后单击菜单输出以输出为指定的格式.
6. 现在我们输出文本格式,选择TXT,文件名为123,并将其保存到桌面.
7. 保存后,将显示记事本中的内容显示页面,可以将其视为已识别的文本.
8. 关闭软件程序后,我们会发现文本格式的识别结果已自动保存在桌面上.
1. 上书7号OCR文本识别系统中的绿色框发生了什么?
“您可以直接使用扫描仪上的文本进行编辑”与扫描仪无关,可以使用任何扫描仪. 能够“直接使用它进行编辑”属于汉字识别,并且是通过OCR(光学字符识别)软件实现的.

2. 如何从尚书七号的ocr破解版中提取文本?
您只需要在打开的文档中选择要用鼠标提取的目标文本,然后修改识别框的属性,即水平,垂直,表格和图片. 然后,只需识别它即可. 最后,选择输出.
3. 识别效果差的原因?
①扫描设置不正确. 扫描图像时的扫描分辨率(分辨率)应设置为300dpi. 如果文档字体较小,则需要将扫描分辨率设置为较高的值,例如400dpi或600dpi. 缩放比例(Scaling)设置为100%,并且需要根据纸张和打印质量来调整亮度阈值(阈值,亮度),以避免扫描图像太暗或太亮.
②如果自动布局分析有误,请用鼠标划分正确的布局块;布局块的布局错误,例如将水平版本设置为垂直版本,将垂直版本设置为水平版本等. 这时,请自行更正块布局.
③原件的打印质量太差,笔划严重破裂,墨水太浓,字符之间的附着力严重等,也可能会大大降低识别率.
④识别语言选择不当,应根据原文选择“简体”,“简体中文”或“英语”
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-198806-1.html
-

-
姜奕汝
早上看到系统有更新提示
-
-
绿川光
没办法
 福建农林大学材料工程学院院长介绍: 陈立辉
 2016年驾驶考试书中有多少道题,而2016年驾驶考试书中有多少道题
 “LiveUpdate360.exe”进程
 lg电视电源板价格_lg电视主板板价格
主权都没了