各种应用程序收听歌曲和识别歌曲的算法是什么?
电脑杂谈 发布时间:2020-03-29 18:17:15 来源:网络整理
接下来是一个不懂音乐的白人想法,该算法才刚刚起步. 其中有很多术语和价值观. 我主要是分享我的想法. 不要把它当回事.
一开始,我的想法很幼稚: 腾讯音乐将嗡嗡作响的音乐旋律直接扔到中,以匹配每首歌曲的旋律. 再想一想,我认为这种想法是不现实的,只需取出一个旋律并将其放入中以匹配每首歌曲的旋律,这是很多计算工作.
因此,我从统计学的角度考虑,并尝试在歌曲中找到特征: 振幅是在开始时选择的(无论如何,我不知道是不是这样说的,它是音量每秒),如果振幅有100种,则制作一个100维向量.
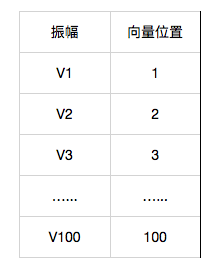
所以一首歌可以算作3、3、4、5、6、6,....,5、6、7、9. 每个矢量位置的大小代表相应幅度出现的次数. 这会将中的所有歌曲映射到相应的向量:
歌曲(1)3,4,5,6,6,6,....,5,6,0,8

歌曲(2)0,1,2,3,3,2,...,5,2,1,0
歌曲(3)1,3,4,5,1,0,....,1,1,0,1
.........
将哼唱的歌曲转换为相应的向量: 0,0,0,1,2,1,.....,3,5,6,7,然后余弦定理找到弦之间的余弦值向量和中的向量. 当余弦值为1时,两个夹角为零,这两个角度完全相同. 余弦值越接近1,则歌曲的相似度越高.
但是考虑到这一点,我认为在计算一个向量的振幅数量时可能会有很大的误差,因为相同数量的振幅并不意味着这两首歌是完全相同的.
这里我举一个例子: 如果现在操场上有5个人,他们的身高是: 1.6、1.6、1.7、1.7、1.8,他们将首先在A线,然后将他们重新排列. 两队的身高分布如下:

团队A: 1.7、1.6、1.8、1.6、1.7
B队: 1.6、1.7、1.8、1.7、1.6
如果按照上述方法计算两队的身高向量,那么我们将得到完全相同的向量,但是两列的顺序不同.
然后,我们更改统计维度,因为我认为这些歌曲是连贯的. 正是每秒钟和前一秒钟的幅度变化构成了我们听到的旋律(在这里我盲目地对其进行了编辑)),我将幅度变化称为波动(T). 如果计算出波动(T),则相当于一首歌曲每秒的旋律变化. 返回队列示例:
团队A: -0.1、0.2,-0.2、0.1
团队B: 0.1、0.1,-0.1,-0.1

通过这种方式,我们可以过滤出振幅相同的那些歌曲. 其余的歌曲是具有相同波动数(T)的歌曲,但我想统计(T)的结果是最终匹配的歌曲数. 匹配的歌曲之间会有更多的特征,并且可能不会有非常相似的特征,只是波动的数量(T)才匹配. 如果我们哼着东风蒲: “谁在用琵琶演奏东风蒲”,其波动(T)假定为2、4、5、4、6、6,只有这些波动是连贯的. 歌曲的旋律,如果这些波动分散到歌曲的各个位置,即使最终的统计结果相同,旋律也肯定会不同,也就不会是同一首歌.
最后,我想到一个窍门,即在统计过程中限制波动率T的顺序. 在这里,我假设一个叫做复合波动率S的概念,并且复合波动率S(i)= {T(i),T(i + 1)},因此“谁在用琵琶演奏东风突破”的浪T变成复合波S = {2,4},{4,5},{5、4},{4、6},{6、6},因为每个波动T等于确定两秒的幅度变化,所以合成波动S等于确定4秒的幅度变化,即确定4秒的旋律变体. 因为每个复合起伏(S)都能确定四秒的旋律变化,所以如果两首歌曲的大多数复合起伏S相同,则相同的概率将非常高.
然后,我们开始根据复合涨落(S)映射中的每首歌曲. 假设总共有100个振幅,则波动(T)为100 * 2 = 200,并且复合波动S(i)= {T(i),T(i + 1)},因此有200 * 200 = 40,000复合波动的类型(S). 换句话说,我们希望将每首歌曲映射到40,000维向量.
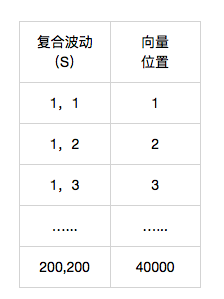
所以一首歌可以算作3、3、4、5、6、6,....,5、6、7、9. 每个矢量位置的大小表示相应的复合波动(S)的出现次数. 这会将中的所有歌曲映射到相应的向量:
歌曲(1)3,4,5,6,6,6,....哼唱识曲,5,6,0,8

歌曲(2)0,1,2,3,3,2,...,5,2,1,0
歌曲(3)1,3,4,5哼唱识曲,1,0,....,1,1,0,1
通过这种方式,获得了哼唱的歌曲向量和中歌曲向量的余弦值,以获得对应的相似概率. 余弦值越接近1,则两首歌曲越相似.
最后的摘要:
1. 我听不懂音乐,也没有阅读相应的音乐识别文献. 我的答案仅受Google新闻分类方法的启发. 其中必须包含许多术语和特定价值. 您不必很认真. 我的重点是分享我的想法.
2. 腾讯音乐可以非常快速地匹配嗡嗡声. 如果我的想法可行,我想它可能不支持这种快速匹配,因此我的想法是添加一个更粗糙的模型,例如使用上面的波动率(T)模型缩小范围,并使用复合波动率(S)模型进行精确匹配.
3. 我仍然没有解决最关键的问题之一,因为每个人的发音和歌曲的恢复程度都不同,所以我面临一个识别问题. 我想到了两种解决方案: (1)通过有监督的机器学习,通过大量数据(与图像识别相同的原理)训练和优化模型,最后训练出可以高概率识别语音的模型; (2)类似于拼音输入法的识别原理对于嗡嗡声输入的复合波(S),采用动态规划算法找到最佳组合(即旋律).
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/ruanjian/article-156834-1.html
-

-
蒲泽宇
就可以锁定中国舰队舰只
 qq炫舞记忆助手免费高分最新版?qq炫舞心动值一天上限?qq炫舞怎么开挂啊?qq炫舞记忆助手免费高分
 独家率先支持Win8 驱动精灵2011 SP2发布!
 酒店管理系统 金有哪些赌牌技术-”高校与行业企业的信息不对称
把市值抬上天