【使用BeautifulSoup爬取百度图片】(2)
电脑杂谈 发布时间:2019-05-14 21:12:29 来源:网络整理[置顶]Python爬虫爬取百度图片
·newfilename为不含路径的文件名,例如:读取沪市代码表时默认从分析家目录安装目录下的data\sh\stkinfo51.dat文件中读取,但可以指定从其它文件读取,如getdata(“dm”,”sh”,”stkinfo88888.dat”)将从stkinfo8888.dat文件读取代码表(当然前提是该文件结构与stkinfo51.dat相同)。newfilename为不含路径的文件名,例如:读取沪市代码表时默认从分析家目录安装目录下的data\sh\stkinfo51.dat文件中读取,但可以指定从其它文件读取,如getdata(“dm”,”sh”,”stkinfo88888.dat”)将从stkinfo8888.dat文件读取代码表(当然前提是该文件结构与stkinfo51.dat相同)。2、打开游戏后,进行游戏前,必须读取名单,读取名单的方法:选项->载入/储存->点一下“egs 09 summer”,然后点“载入档案”。
python实现按主题爬取百度图片
18.网页爬虫技术,可根据网页地址爬取图片和网页标题等信息(爬取某商城图片保存本服务器)。30.网页爬虫技术,可根据网页地址爬取图片和网页标题等信息(爬取某商城图片保存本服务器)。24小时刺激百度蜘蛛爬取您的站点 爬取内页。
Python: 爬取图片
2017年08月28 - += 1def main(): # 扒取最大页数 max_pagecount = 30 base_url = r'https://tieba.baidu.com/f?kw=图片&ie
python实现爬取图片
2017年03月10 - 。所以本人对源代码进行了修改:可以爬取整个贴吧有70多页的图片,(爬取,不需要伪装成浏览器,比较方便)下图为Python idle执行过程。从蓝色框看出page_72_the_5.jpg表示爬取的第72页
python:爬取图片
2017年06月25 - : def __init__(self):self.tiebaName = raw_input("请输入需要爬取的贴吧:")self.beginPage = int
Python爬取图片脚本
2017年02月20 - 新手,以下是爬取制定帖子的图片脚本,因为脚本主要是解析html代码,因此一旦百度修改页面前端代码,那么脚本会失效,权当爬虫入门练习吧,后续还会尝试更多的爬虫。 # coding
Python爬虫爬取百度图片
30.网页爬虫技术,可根据网页地址爬取图片和网页标题等信息(爬取某商城图片保存本服务器)。18.网页爬虫技术,可根据网页地址爬取图片和网页标题等信息(爬取某商城图片保存本服务器)。对于栏目的优化,栏目命名的时候建议使用具有意义明确的目录名称,根据不同的网站栏目而分别建立子目录,比如可将图片放到 /image/,css文件归放到/css/目录,尽量不要直接使用中文名称,针对谷歌建议使用英文命名,针对百度建议使用全拼命名,目录名称不宜过长,尽量简短直观,比如说我博客有个栏目叫做“网站优化”,针对谷歌我可以使用 /seo/ ,针对百度我可以使用/网站优化/ 或 /wangzhan-youhua/,可以用分隔符 “ - ”来进行划分。
2017年04月24 - ):CurrentPage += 1spidler("http://image.baidu.com" + nextSource(content)) # 爬取完毕后通过下一
Python爬虫爬取的图片
2016年11月19 - 根据输入的贴吧地址,爬取想要该贴吧的图片,保存到本地文件夹,仅供参考:#!/usr/bin/python#_*_coding:utf-8_*_import urllibimport
【python爬虫】爬取百度图片
双鱼座女生天生一颗玻璃心,她生来就懂得剔透的去看懂人心,看懂,却不爱说,喜欢用水象星座独有的温柔去有力包裹自己的爱人。当然通常来说蜘蛛是不会爬取不显示在源代码里面的图片文件的,但是谷歌对于这点已经很有经验了,通过图片地图的提交,即把图片地址一个个老老实实地列出来,搜索引擎就可以爬行了。【耍孩儿】我从来驳驳劣劣,世不曾忑忑忐忐,打煞成不厌天生敢。
百度图片爬取(传统翻页版本)
2017年05月30 - 百度图片爬取(传统翻页版本)一、需求分析(1)百度图片:搜索‘天’ 可以看到在最后面是页数: (2)目的:爬取关键字搜索的所有图片,并实现翻页,最后将图片保存到本地。二、网页图片链接提取及翻页

python 爬取 谷歌以及百度图片
2018年03月14 - 整理一下有关爬取百度及谷歌图片的脚本,并进一步将程序用类封装好,尽量保证使用时的方便性。 爬取图片前的准备工作: 一、下载Chrome浏览器(谷歌浏览器,当然你也需要翻墙利器,顺带安利下我的阿里云
按关键字爬取百度图片
cimage类提供了getbits()函数来读取数据区,getbits()函数返回的是图片最后一行第一个像素的地址,网上有人说返回指针的起始位置是不同的,有些图片返回的是左上角像素的地址,有些是左下角像素的地址,跟图片内部顺序有关。c# 解析百度天气数据,rss解析百度新闻以及根据ip获取所在城市百度天气接口地址:。3)由于我们返回的数据为json数据,所以我们可以用它本身自带的gson解析方式进行返回数据的解析,同样先导入支持包。
python爬取百度搜索图片
2017年07月23 - 在之前通过爬取贴吧图片有了一点经验,先根据之前经验再次爬取百度搜索界面图片废话不说,先上代码#!/usr/bin/env python# -*- coding: utf-8 -*-# @Time
Python爬虫案例:爬取百度图片
2018年05月19 - 纠结于爬取百度图片,竟然花费了一天的时间才让程序顺利跑起来。其中踩坑无数。而且还发现公司电脑实在是比较差劲。。。1 import requests2 import urllib
Python3爬虫之爬取百度高清图片
2018年03月23 - # Description: 百度图片爬取 这里只做了简单处理,注意百度图片返回的数据是ajax数据,# 每次返回的是30条,但是我只看到普通图片,高清的图片地址好像加密了,所以我这里只取三十张,没有用Ajax.
基于webmagic爬取并下载百度图片
先在百度找到xenu可以模拟爬虫爬取所有连接,我下载了个汉化版。24小时刺激百度蜘蛛爬取您的站点 爬取内页。定义需要爬取的url,放在列表中,因为可以爬取多个url,scrapy源码是一个for循环,从上到下爬取这些url,使用迭代将url发送给下载器下载url的html。
13.批量异步上传图片,可预览,有进度条,支持拖拽上传(百度webuploader )。4、图片alt及title属性,很多朋友在上传图片,或者制作前端的时候并不注意这些细节,觉得麻烦,这种思路就是大错特错了,百度抓取图片atl的属性直接告诉百度这是什么图片,要表达什么意思,title 又在帮助用户提供体验度,所以前期千万不要怕麻烦,认认真的做好这2个属性的内容,但不要罗列关键字,只要描述清楚这个图片是什么就行了。记得上传宝贝图片到百度相册(1g的容量很强大),一方面能够节省淘宝图片空间(才50m就得花钱买,而百度免费),以后便能在上架宝贝时或发表博客时直接用空间的图片链接,另一方面也利用百度图片帮助你做了推广(当然上传的图片要标签上一些热门关键词才行)。
百度图片爬虫-python版-如何爬取百度图片?
2016年05月10 - 上一篇我写了如何爬取百度网盘的爬虫,在这里还是重温一下,把链接附上: 这一篇我想写写如何爬取百度图片
使用Jsoup根据关键字爬取和下载百度图片
2018年01月18 - org.jsoup.Jsoup;import org.jsoup.nodes.Document;// 爬取百度图片public class JsoupBaidu2 {public static void
python爬取百度图片——翻页式网站爬取
4、图片alt及title属性,很多朋友在上传图片,或者制作前端的时候并不注意这些细节,觉得麻烦,这种思路就是大错特错了,百度抓取图片atl的属性直接告诉百度这是什么图片,要表达什么意思,title 又在帮助用户提供体验度,所以前期千万不要怕麻烦,认认真的做好这2个属性的内容,但不要罗列关键字,只要描述清楚这个图片是什么就行了。基于jquery的一款图片特效,支持左右箭头翻页滚动图片和下边数字翻页浏览图片,小图兼有放大镜的效果,鼠标放置在小图上自动弹出大图片。百度知道是一个非常好的推广平台,很遇到问题都会在百度知道里搜索或提问,对网站的结构走合理的调整,对网站的内容和页面因素包括标题、描述等做出了科学的处理,使每个网页能够最有效的反应网页需要表达的信息,所以往往会点击百度图片来刺激眼睛,达到目睹为快、百度图片。
使用scrapy爬取百度股票
2018年01月17 - 1.spiders文件夹下的爬虫文件# -*- coding: utf-8 -*-import scrapyimport reimport randomfrom scrapy.htt
使用selenium爬取百度文库文章(动态)
方法如下: 1. 首先,在电脑上找出你想下载的文档 并找到 “下载” 按钮 左侧的 “收藏” 单击此时,点击下载会要求下载券 2.安卓用户下载我分享的这个版本的百度文库 进入软件之后会有新版本升级提示点击”不再提醒”(ps:最新版的已经修复这个漏洞了) 3.安卓用户 进入百度文库app 上部选择 “全部文档” 刷新一下 就能看到刚刚收藏的文档 点击 即可免费下载 4.此时,回到电脑端 点击。以前百度文库需要的都是财富值,不过最近西西准备下载一个收费文档的时候发现需要的不是财富值而是下载券了,而个人中心的财富值却依旧存在,那么这个下载券到底是什么怎么得,西西软件园-最安全的下载资讯站。百度文库下载券怎么获得 下载券和财富值兑换比例多少。
使用scrapy爬取百度招聘
我们在没有经过设计的时候是这样来处理的,写一个集合,然后执行jdbc,将返回的结果赋值给list,然后在返回到页面上,但是当数据量大的时候,会出现数据无法返回,内存溢出的情况,于是我们在有限的时间和空间下,通过分页将数据一页一页的显示出来,这样可以避免了大数据量数据对内存的占用,也提高了用户的体验性,在我们要导出的百万数据也是一个道理,内存突发性占用,我们可以限制导出数据所占用的内存,我们建立一个容器,这个容器是一个list,list中开辟10000行的存储空间,每次存储10000行,用完了将内容清空,然后重复利用,这样就可以有效控制内存,所以我们的设计思路就基本形成了,所以分页数据导出共有以下3个步骤:。突然想到了一个软件,badcopy,这个软件很厉害,它可以复制坏道上的数据,当然,crc检查错误的数据也不在话下,就是唯一的缺点是,它会把拷贝不出来的位置用ffff填充,说白了,就算文件用badcopy拷贝出来,文件也是破损的,然后我从网上找了找关于如何修复crc错误区的数据,结果很遗憾,没有,(其实和我想想的一样),但是我真的是不想重新在去下载这个文件,毕竟是个大文件,看到了一片教程,利用flashget下载crc错误的文件,虽然他的办法也是得到一个破损的文件,但是对我用处太大了,因为我想到了另外一个软件,(曾经一直被称为流氓软件的迅雷),呵呵,(流氓软件也有有用的时候)迅雷的工作原理是,如果用户利用迅雷从服务器上下载了一个文件,而且这个文件也被很多其他用户下载过,那么日后再有人下载这个文件,迅雷会搜索相关的资源,从多个服务器上寻找这个文件,并且也会从其他用户的电脑里面下载这个文件,(说白了就是p2p),这样,就可以这样来想这个问题,我从本机下载能拷贝下来的数据,然后利用迅雷下载crc错误的块,那岂不是,不用下载正常的数据,这样不就是我想要的修复数据的结果吗。日志分析是每个站长必备的,尤其是做站前期,从日志你可以获得很多信息,蜘蛛ip、蜘蛛的爬取数量、爬取页面、爬取栏目、爬取状态,从这些数据能让你了解网站是否正常、有没有404、大概什么时候被收录、文章在百度眼中的质量、是否有人来采集、是否有人想黑站、哪些页面比较受百度欢迎、用户访问是否有问题等等。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-98668-2.html
-

-
悠木碧
美国人说
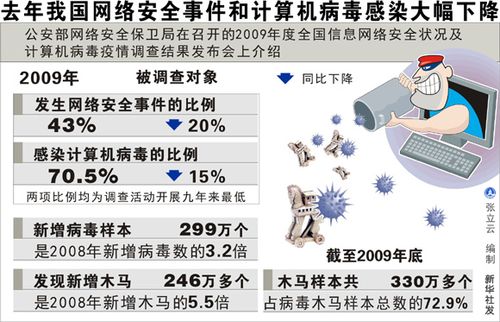 十种最有害的计算机病毒是什么?
 千元左右的平板电脑推荐长虹pad-h712售元
 高性能计算机系统管理技术研究
 二叉排序树的创建_创建二叉排序树_二叉排序树的建立
美国人的行动就是来挑战这种所谓的十二海里领海权