windows并行文件系统 python3之协程(3)
电脑杂谈 发布时间:2018-02-22 14:45:48 来源:网络整理在 Linux 的缓存 I/O 机制中,操作系统会将 I/O 的数据缓存在文件系统的页缓存( page cache )中。
数据会先被拷贝到操作系统内核的缓冲区中,然后才会从操作系统内核的缓冲区拷贝到应用程序的地址空间。
缓存 I/O 的缺点:

数据在传输过程中需要在应用程序地址空间和内核进行多次数据拷贝操作,这些数据拷贝操作所带来的 CPU 以及内存开销是非常大的。
对于一次IO访问(以read举例),数据会先被拷贝到操作系统内核的缓冲区中,然后才会从操作系统内核的缓冲区拷贝到应用程序的地址空间。
一个IO(如read)操作会经历以下两个阶段:
1. 等待数据准备 (Waiting for the data to be ready)
2. 将数据从内核拷贝到进程中 (Copying the data from the kernel to the process)
因为有了这两个阶段,linux系统产生了下面五种网络模式的方案。
1.阻塞 I/O(blocking IO)
2.非阻塞 I/O(nonblocking IO)
3.I/O 多路复用( IO multiplexing)
4.信号驱动 I/O( signal driven IO)
5.异步 I/O(asynchronous IO)
阻塞 I/O(blocking IO)
在linux中,默认情况下所有的socket都是blocking,一个典型的读操作流程大概是这样:
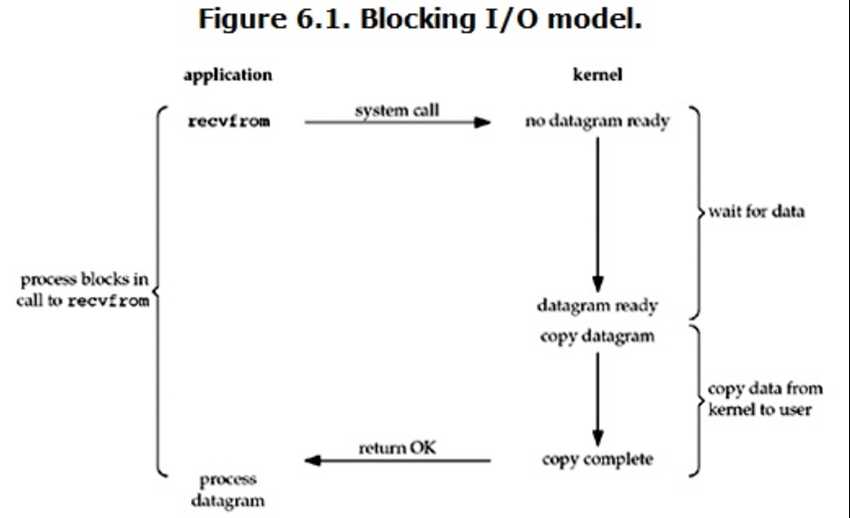
当用户进程调用了recvfrom这个系统调用,kernel就开始了IO的第一个阶段:准备数据(对于网络IO来说,很多时候数据在一开始还没有到达。比如,还没有收到一个完整的UDP包。这个时候kernel就要等待足够的数据到来)。这个过程需要等待,也就是说数据被拷贝到操作系统内核的缓冲区中是需要一个过程的。而在用户进程这边,整个进程会被阻塞(当然,是进程自己选择的阻塞)。当kernel一直等到数据准备好了,它就会将数据从kernel中拷贝到用户内存,然后kernel返回结果,用户进程才解除block的状态,重新运行起来。
所以,blocking IO的特点就是在IO执行的两个阶段都被block了。
非阻塞 I/O(nonblocking IO)
linux下,可通过设置socket使其变为非阻塞IO。当对一个non-blocking socket执行读操作时,流程是这个样子:
当用户进程发出read操作时,如果kernel中的数据还没有准备好,那么它并不会block用户进程,而是立刻返回一个error。
从用户进程角度讲 ,它发起一个read操作后,并不需要等待,而是马上就得到了一个结果。用户进程判断结果是一个error时,它就知道数据还没有准备好,于是它可以再次发送read操作。一旦kernel中的数据准备好了,并且又再次收到了用户进程的system call,那么它马上就将数据拷贝到了用户内存,然后返回。
所以,nonblocking IO的特点是用户进程需要不断的主动询问kernel数据好了没有。
I/O 多路复用( IO multiplexing)
IO multiplexing就是我们说的select,poll,epoll,有些地方也称这种IO方式为event driven IO。
select/epoll的好处就在于单个process就可以同时处理多个网络连接的IO。
它的基本原理就是select,poll,epoll这个function会不断的轮询所负责的所有socket
当某个socket有数据到达了,就通知用户进程。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-88904-3.html
-

-
陈深
那就是死不足惜了
-
 JavaScript 数据类型
 恒智天成资料软件官方版下载【工程建筑】
 中国号码验证
 分布式文件系统GFS .... ppt的云计算原理免费全文阅读
羞辱中国