critical section Linux内核同步 - spin_lock(5)
电脑杂谈 发布时间:2018-02-14 08:19:43 来源:网络整理static inline void do_raw_spin_lock(raw_spinlock_t *lock) __acquires(lock)
{
__acquire(lock);
arch_spin_lock(&lock->raw_lock);
}
__acquire和静态代码检查相关,忽略之,最终实际的获取spin lock还是要靠arch相关的代码实现。

四、ARM平台的细节
代码位于arch/arm/include/asm/spinlock.h和spinlock_type.h,和通用代码类似,spinlock_type.h定义ARM相关的spin lock定义以及初始化相关的宏;spinlock.h中包括了各种具体的实现。
1、回忆过去
在分析新的spin lock代码之前,让我们先回到2.6.23版本的内核中,看看ARM平台如何实现spin lock的。和arm平台相关spin lock数据结构的定义如下(那时候还是使用raw_spinlock_t而不是arch_spinlock_t):
typedef struct {
volatile unsigned int lock;
} raw_spinlock_t;
一个整数就OK了,0表示unlocked,1表示locked。配套的API包括__raw_spin_lock和__raw_spin_unlock。__raw_spin_lock会持续判断lock的值是否等于0,如果不等于0(locked)那么其他thread已经持有该锁,本thread就不断的spin,判断lock的数值,一直等到该值等于0为止,一旦探测到lock等于0,那么就设定该值为1,表示本thread持有该锁了,当然,这些操作要保证原子性,细节和exclusive版本的ldr和str(即ldrex和strexeq)相关,这里略过。critical section立刻临界区后,持锁thread会调用__raw_spin_unlock函数是否spin lock,其实就是把0这个数值赋给lock。
这个版本的spin lock的实现当然可以实现功能,而且在没有冲突的时候表现出不错的性能,不过存在一个问题:不公平。也就是所有的thread都是在无序的争抢spin lock,谁先抢到谁先得,不管thread等了很久还是刚刚开始spin。在冲突比较少的情况下,不公平不会体现的特别明显,然而,随着硬件的发展,多核处理器的数目越来越多,多核之间的冲突越来越剧烈,无序竞争的spinlock带来的performance issue终于浮现出来,根据Nick Piggin的描述:
On an 8 core (2 socket) Opteron, spinlock unfairness is extremely noticable, with a userspace test having a difference of up to 2x runtime per thread, and some threads are starved or "unfairly" granted the lock up to 1 000 000 (!) times.
多么的不公平,有些可怜的thread需要饥饿的等待1000000次。本质上无序竞争从概率论的角度看应该是均匀分布的,不过由于硬件特性导致这么严重的不公平,我们来看一看硬件block:
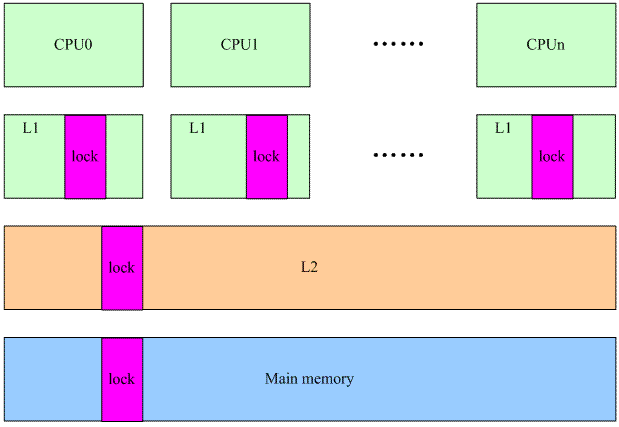
lock本质上是保存在main memory中的,由于cache的存在,当然不需要每次都有访问main memory。在多核架构下,每个CPU都有自己的L1 cache,保存了lock的数据。critical section假设CPU0获取了spin lock,那么执行完临界区,在释放锁的时候会调用smp_mb invalide其他忙等待的CPU的L1 cache,这样后果就是释放spin lock的那个cpu可以更快的访问L1cache,操作lock数据,从而大大增加的下一次获取该spin lock的机会。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-77053-5.html
-

-
郭季
让它行退为难
-
杨灵
 win8音频服务未运行怎么办usb音频硬件-驱动与驱动程序大全
 华为畅享5s园卡/插卡? 畅享5s手机sim卡安装图文方法
 大容量存储系统概述
 麦浚龙新片《风林火山》发布 梁家辉演心理专家
再一个盗版盛行