并行文件系统 spark和hadoop的区别
电脑杂谈 发布时间:2018-02-12 15:39:37 来源:网络整理
Apache Spark 是专为数据处理而设计的快速通用的计算引擎。Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源的类Hadoop MapReduce的通用并行框架,Spark,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是——Job中间输出结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的MapReduce的算法。
Spark 是一种与 Hadoop 相似的开源集群计算环境,但是两者之间还存在一些不同之处,这些有用的不同之处使 Spark 在某些工作负载方面表现得更加优越,换句话说,Spark 启用了内存分布数据集,除了能够提供交互式查询外,它还可以优化迭代工作负载。
Spark 是在 Scala 语言中实现的,它将 Scala 用作其应用程序框架。与 Hadoop 不同,Spark 和 Scala 能够紧密集成,其中的 Scala 可以像操作本地集合对象一样轻松地操作分布式数据集。
尽管创建 Spark 是为了支持分布式数据集上的迭代作业,但是实际上它是对 Hadoop 的补充,可以在 Hadoop 文件系统中并行运行。通过名为 Mesos 的第三方集群框架可以支持此行为。Spark 由加州大学伯克利分校 AMP 实验室 (Algorithms, Machines, and People Lab) 开发,可用来构建大型的、低延迟的数据分析应用程序。
Hadoop
Hadoop是一个由Apache基金会所开发的分布式系统基础架构。
用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。
Hadoop实现了一个分布式文件系统(Hadoop Distributed File System),简称HDFS。HDFS有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。HDFS放宽了(relax)POSIX的要求,可以以流的形式访问(streaming access)文件系统中的数据。
Hadoop的框架最核心的设计就是:HDFS和MapReduce。HDFS为海量的数据提供了存储,则MapReduce为海量的数据提供了计算。
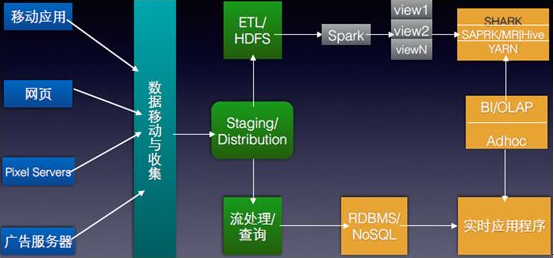

spark和hadoop的区别
解决问题的层面不一样
首先,Hadoop和Apache Spark两者都是大数据框架,但是各自存在的目的不尽相同。并行文件系统Hadoop实质上更多是一个分布式数据基础设施: 它将巨大的数据集分派到一个由普通计算机组成的集群中的多个节点进行存储,意味着您不需要购买和维护昂贵的服务器硬件。
同时,Hadoop还会索引和跟踪这些数据,让大数据处理和分析效率达到前所未有的高度。Spark,则是那么一个专门用来对那些分布式存储的大数据进行处理的工具,它并不会进行分布式数据的存储。
两者可合可分
Hadoop除了提供为大家所共识的HDFS分布式数据存储功能之外,还提供了叫做MapReduce的数据处理功能。所以这里我们完全可以抛开Spark,使用Hadoop自身的MapReduce来完成数据的处理。
相反,Spark也不是非要依附在Hadoop身上才能生存。但如上所述,毕竟它没有提供文件管理系统,所以,它必须和其他的分布式文件系统进行集成才能运作。这里我们可以选择Hadoop的HDFS,也可以选择其他的基于云的数据系统平台。但Spark默认来说还是被用在Hadoop上面的,毕竟,大家都认为它们的结合是最好的。
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-73793-1.html
-

-
党翊菀
屈臣氏的广告
 底部剪切定律问题
 面向对象的PHP(OOP)
 c# 图书管理系统源代码_窗体图书管理系统代码
 软件测试教程-软件测试技术和工具
几次讲话让人感觉水平差了点