如何为数据集选择正确的聚类算法
电脑杂谈 发布时间:2020-07-18 18:18:46 来源:网络整理
[IT168复习]应用聚类算法比选择最佳算法要容易得多. 每种类型都有其优点和缺点. 如果您想要一个整洁的群集结构,则必须认真考虑.
数据聚类是正确安排整个数据模型的重要步骤. 为了进行分析,应该根据共同性来组织信息. 主要问题是哪种公开参数可提供最佳结果,“最佳”是什么意思.
本文介绍了最广泛的聚类算法及其深入的说明. 根据每种方法的特殊性,提出了使用方法的建议.
四种基本算法以及选择方法
根据聚类模型,可以区分四个常见的算法类别. 一般来说,算法不少于100种,但它们的流行度和应用领域并不广泛.
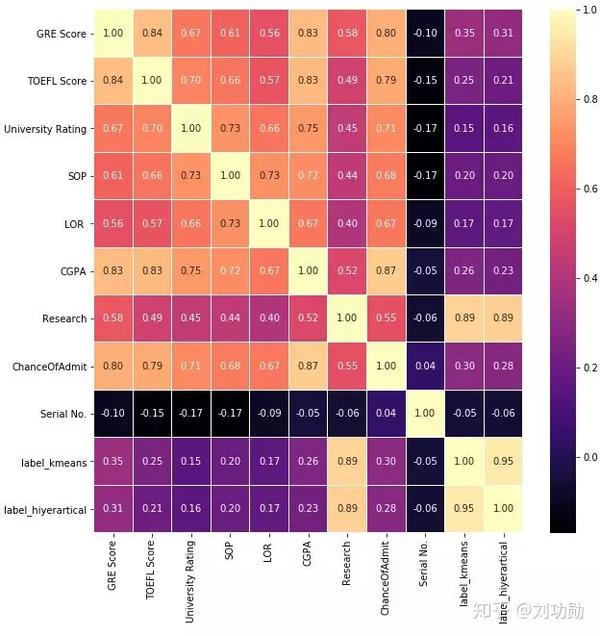
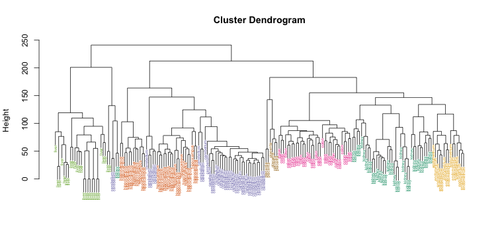
基于整个数据集中对象之间的距离进行的计算称为基于连接或分层的. 根据算法的“方向”,它可以联合拆分信息数组,反之亦然-聚合和拆分的名称来自此精确的更改. 最受欢迎或最合理的类型是聚合类型. 您首先输入数据点的数量,然后将这些数据点合并到越来越大的群集中,直到达到限制为止.
基于连接的聚类最突出的例子是植物的分类. 数据集的“树”从特定物种开始聚类测试数据集,以某些植物“王国”结束. 每个“王国”都由较小的簇(门,类别,顺序等)组成.
应用了一种基于连接的算法后,您将收到一个数据树图,该图将向您显示信息的结构,而不是其在群集上的明显分隔. 此功能既有优点也有缺点: 算法的复杂性可能变得太复杂,或者可能不适用于层次结构很少或没有层次结构的数据集. 性能也会很差: 由于重复很多,因此整个处理将花费大量时间. 最重要的是无法使用分层算法获得准确的结构.
同时,需要从计数器输入的数据被精简为数据点的数量,这对最终结果不会有实质性的影响,或者它是一个预设的距离测量,这是一个粗略的测量.
根据我的经验,基于中心体的群集是最常见的模型,因为它相对简单. 该模型旨在将数据集的每个对象分类为一个特定的群集. 群集数(k)是随机选择的,这可能是此方法的最大“弱点”. 由于该算法与k最近邻法(k-nearest neior,kNN)相似,因此在机器学习中特别受欢迎.
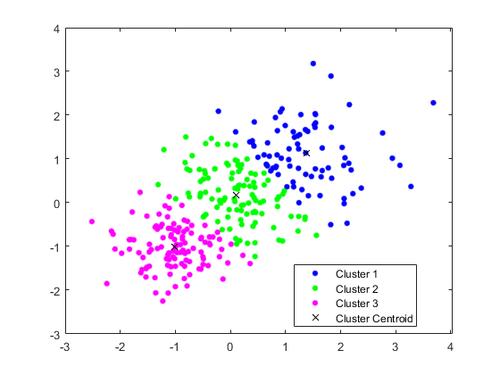
计算过程包括多个步骤. 首先,选择输入数据和近似的簇数以划分数据集. 群集的中心应放置在尽可能远的位置,这样可以提高结果的准确性.
第二,该算法找到数据集中每个对象与每个聚类之间的距离. 最小坐标确定将对象移动到哪个簇.
之后,将根据所有对象坐标的平均值重新计算聚类的中心. 重复算法的第一步,但重新计算群集的新中心. 除非满足某些条件,否则此类迭代将继续. 例如,当簇的中心距上次迭代还没有移动或移动不明显时,该算法可能会结束.

尽管数学和编码很简单,但k均值仍然存在一些缺点,因此我无法在所有可能的地方使用它. 其中包括:
忽略每个群集的边缘聚类测试数据集,因为优先级设置在群集的中心而不是边界;
不可能创建数据集结构,该结构的对象可以以相同的方式分为多个集群;
需要猜测最佳的k值,或者需要进行初步计算以指定此标题.
同时,期望最大化算法可以避免那些复杂的情况,同时提供更高的准确性. 简而言之,它将计算每个数据集点与我们指定的所有聚类的关联概率. 假设数据集的点通常遵循高斯分布,则用于该聚类模型的主要“工具”是高斯混合模型(GMM).

k-means算法基本上是EM原理的简化版本. 他们都需要手动输入群集数,这是此方法面临的主要问题. 此.
与基于质心的模型不同,EM算法允许对两个或多个聚类中的点进行分类-它仅向您显示每个事件的可能性,可将其用于进一步分析. 更重要的是,每个聚类的边界构成了具有不同度量的椭球,这不同于k-均值,在k-means中,聚类在视觉上表示为圆形. 但是,对于对象不遵循高斯分布的数据集,此算法根本不起作用. 这是此方法的主要缺点: 比实际的测量或观察结果更适合于理论问题.
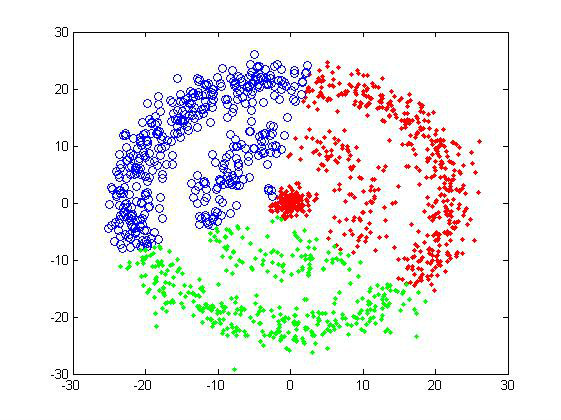
最后,基于数据密度的聚类已经成为数据科学家心目中最流行的非正式方法,包括模型的要点,将数据集划分为聚类,并且计数器将输入ε参数,即“邻居”距离. 因此,如果对象位于ε半径的圆(球)内,则与聚类有关.
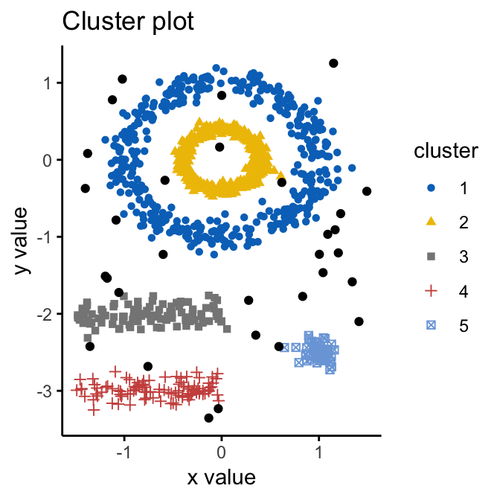
DBSCAN(基于密度的应用程序噪声空间聚类)算法会逐步检查每个对象,将其状态更改为“已查看”,将其分类为聚类或噪声,最后处理整个数据集. 使用DBSCAN确定的聚类可以具有任何形状,因此非常准确. 此外,该算法不会让您计算群集数,而是自动确定的.
但是,即使像DBSCAN这样的杰作也有缺点. 如果数据集由可变密度数据集组成,则此方法的结果很差. 如果对象的位置太近,并且无法轻松估计epsilon参数,那么这也不是您的选择
总而言之,没有错误选择的算法-其中一些算法更适合特定的数据集结构. 为了选择最佳和更合适的算法,您需要充分了解它们的优缺点和特征.
某些算法可能从一开始就被排除在外,例如,它们不符合数据集规范. 为了避免重复工作,您可以花一些时间来组织和存储信息,而不用选择反复试验的路径.
原始作者: 乔什·汤普森
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-284994-1.html

 分布式文件传输有什么差异?深度剖析Gartner关键素养报告
 最新版:Edge浏览器win7版本v85.0.564.51正式版
 JSP框架和JSP开发工具的优缺点比较
 updateprogress_updatepanel_net updatepanel
这次国家必须要做坚决的回应