TiKV在京东云对象存储元数据管理中的实践
电脑杂谈 发布时间:2020-07-17 07:07:53 来源:网络整理
作者简介: JD Cloud产品研发部专家架构师崔灿目前主要负责JD Cloud对象存储产品.
JD Cloud Object Storage在2016年作为公共云进行了公开. 其主要功能是可靠性,安全性,大容量和低成本. 它用于某些常见的业务场景中,例如JD Cloud Public Cloud之外的开发人员. 服务,针对政府和企业的私有云服务,甚至是混合云服务.
本文将介绍JD Cloud Object Storage Service的体系结构演变以及迁移到TiKV的经验.

图1什么是“对象”
首先,在此处举一个示例说明“对象”的概念. 例如,如果我们将照片作为“对象”,则除了照片本身的二进制数据外,它还应包含一些元信息(照片数据长度,最后修改时间等)以及与照片相关的数据用户(射击者,拍摄设备数据等待). 对象存储的特点是这些数据不会被频繁修改.
如果图片存储的数量相对较少,我们可以使用LVM之类的东西在一个节点上使用多个磁盘. 此方法通常适用于1M〜10M数量级的图片. 随着业务的增长,将有越来越多的图片甚至视频存储,因此我们使用分布式文件系统进行存储. 此方法基于DFS架构(如下图所示).
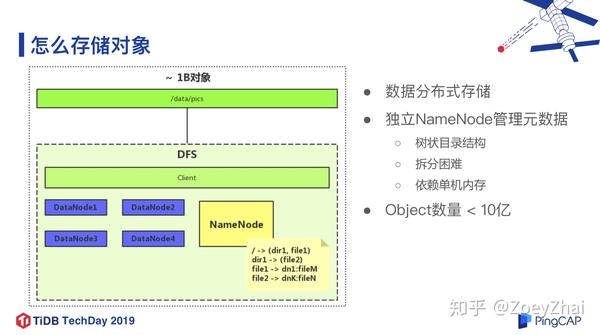
图2如何存储对象(数据量1B)
此方法的前提是限制一台计算机的容量,必须将数据存储在多台计算机上,并使用一个或多个独立节点来存储元数据,并且元数据将维护树的结构. 目录. 积分比较难. 但是,这种体系结构通常适合存储多达10亿个级别的对象,并且存在两个相对较大的问题:
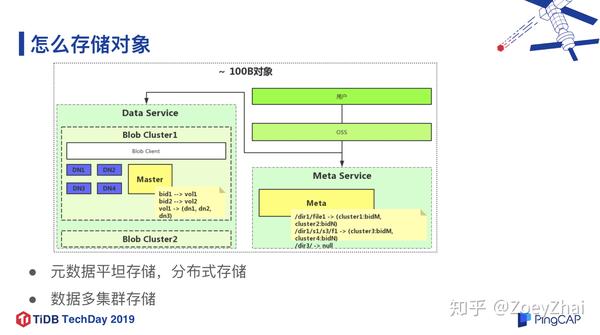

图3如何存储对象(数据量100B)
那么如果您需要进行1000亿个对象存储,该如何实现呢?想到它的最简单方法是以分布式方式存储元数据. 它不再像文件系统那样存储在单独的计算机上. 它是树形结构,但是平面结构.
回到上面的示例,我们主要对图片对象进行四种类型的操作: 上载(Put),下载(Get),删除(Delete),扫描. 扫描操作是相对传统的操作,例如检查当前有多少图片对象可用并获取所有图片名称.

图4元数据管理系统v1.0(1/4)
以上是最简单和原始的解决方案之一. 此处Bucket等同于命名空间. 这是许最初设计的结构元数据管理,但是当以后的数据量增加时,您将遇到一些问题,如下所示.
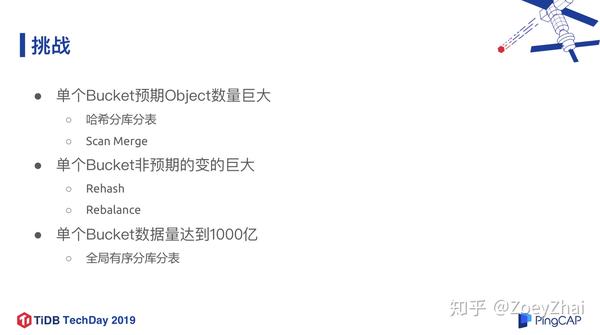
图5元数据管理系统v1.0(2/4)
第一个问题是,当初始数据量较小时,只能将其分为4个存储区. 随着业务的增长,需要再次将其拆分为400个存储桶. 数据迁移是一个Rehash过程. 这是一件非常复杂和麻烦的事情. 那么,我们正在考虑如何进行对象存储的连续扩展,跨数量级的无限扩展?下图是一个相对复杂的解决方案. 核心思想是静态处理大多数数据,因为静态存储(无论是迁移还是拆分)都相对简单. 例如,每天将前一天写入的数据静态合并为历史数据.
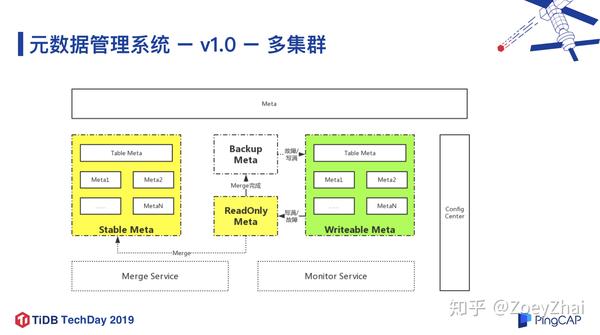

图6元数据管理系统v1.0(3/4)
对于第二个问题,如果单个存储桶具有大量数据,则在向Stable Meta(上图中的部分)进行静态迁移时,需要执行深度拆分. 单个存储桶中的对象数量非常大. 它不能存储在一个中,因此需要将其存储在多个中,然后建立另一层索引以按每个中存储的时间间隔存储数据. 同时,当我们运行它时,实际上会出现铲斗数量增加的情况. 这是意外的增加. 在这种情况下,我们的方法是获得许多外部监视程序来监视存储桶. 卷,当存储桶卷太大时,它将主动触发一系列过程,例如表拆分和迁移.
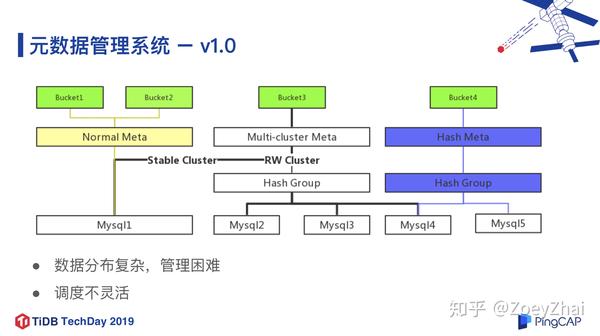
图7元数据管理系统v1.0(4/4)
此解决方案有两个明显的问题. 首先,数据分发复杂且管理困难;其次,调度不灵活,给以后的维护带来很大困难.
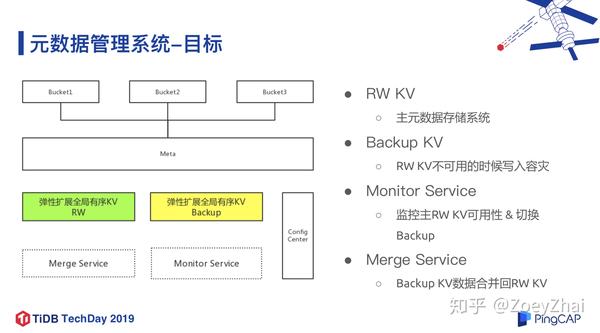
图8元数据管理系统的改进目标
因此,我们认为这件事的实质是成为全球订购的KV,并且它必须“足够大”以能够弹性扩展. 这将使系统架构非常简单(如上图所示). 当然,最后我们找到了分布式KVTiKV.
我们在早期研究了很多产品,最后选择TiKV的主要原因有四个:
在上线之前,我们主要进行了以下测试:

通过上述测试,我们认为TiKV可以从性能和系统安全性的角度满足要求,因此我们已经实现了基于TiKV的对象元数据管理系统v2.0,如下图所示.
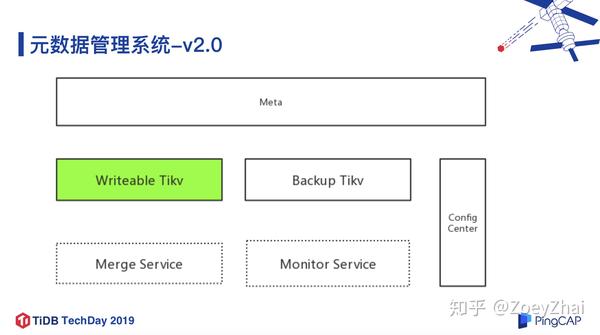
图9元数据管理系统v2.0
在用TiKV替换v1.0中的一堆复杂的和逻辑结构之后,整个系统变得非常简洁.
许多用户可以直接将MySQL迁移到TiDB. 这个迁移过程已经非常成熟,但是由于迁移到TiKV的经验较少,因此我们在迁移过程中也做了很多探索性工作.
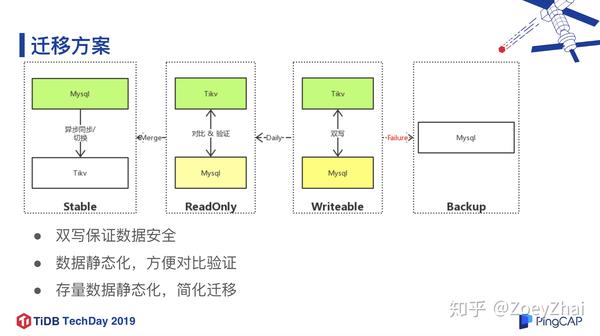
图10迁移计划
上图是我们设计的迁移计划. 首先,所有数据都必须被双重写入以确保数据安全. 其次,我们将库存数据设置为只读元数据管理,然后迁移到TiKV. 同时,迁移过程中的增量数据被直接写入TiKV,并且每天静态处理前一天的增量数据,然后MySQL中的数据比较并验证数据的正确性. 另外,如果两次写入失败,将启用MySQL备份.
以下详细介绍了实际操作过程中的相关细节.
在库存数据切换方面,我们首先将库存数据设为静态,从而简化了迁移,数据比较和回滚的过程;在增量数据交换方面,我们首先将增量数据双重写入TiKV和MySQL,并确保发生异常,以便在不影响业务的情况下快速回滚到MySQL. 值得一提的是,由于TiKV在测试环境中的验证结果非常好,因此我们将TiKV用作双重写入的Primary.
整个切换过程分为三个步骤:

数据验证过程中最大的困难是增量数据的验证. 因为增量数据每天都在变化,所以我们将MySQL和TiKV双重写入,并且每天使用MySQL中的记录对增量数据进行静态处理,以验证TiKV数据是否可靠(无数据丢失或错误),如下图.
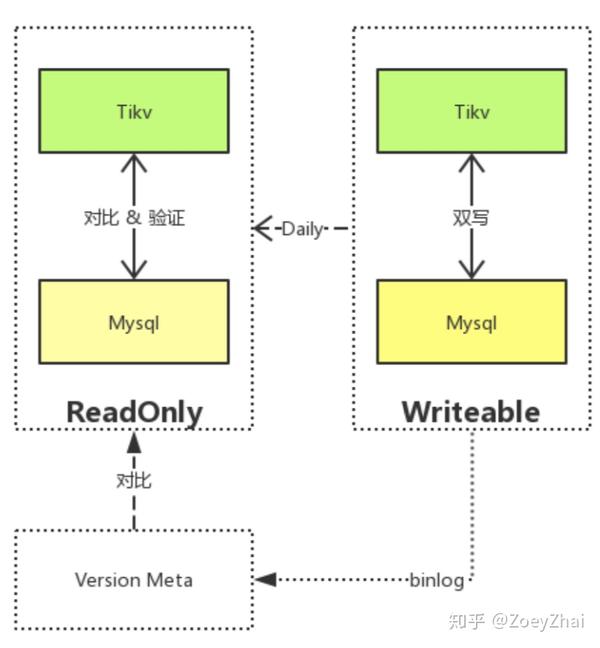
图11双重验证
因为可能存在这样的情况,即同时写入MySQL和TiKV,成功写入TiKV,但是写入MySQL失败,因此两次写入不在同一事务中,因此无法保证它们将同时成功或失败,尤其是在业务量相对较大时. 对于这种不一致性,我们将使用业务层的操作记录来确定它是由业务层中的问题引起还是由TiKV引起的.
目前,TiKV是JD Cloud Object Storage业务中的主,计划到2019年底使原始脱机. 已部署的群集总数为10个以上,生产环境为单个群集QPS峰值为40,000(读写1: 1),最大的单个群集数据量为20+十亿,并且有超过500,000个区域. 我们的元数据管理业务需要等待时间相对较高,可以保证当前等待时间约为10ms. 此外,我们正在测试TiKV 3.0,预计将于2019年第四季度上市.
根据当前的业务运营,我们将来会做一些优化工作.
第一点是灾难恢复. 目前,我们正在业务层进行灾难恢复. 将来,我们可能会直接在TiKV层执行灾难恢复. 我们也期待TiKV的未来版本中提供此功能.
第二点是优化群集的大小. 由于对象存储是一项存储密集型业务,因此我们希望压缩硬件成本. 例如,可以使用8T和10T磁盘,也可以使用便宜的磁盘. 研发学生考虑如何共同优化和改进.
第三点是优化区域调度. 当前,整个TiKV调度更加复杂,这对于存储密集型企业而言尤其麻烦,尤其是在数据量特别大的情况下. 我们不希望出现小幅波动. 只需将数据移至其他计算机即可.
本文摘自崔灿老师在TiDB TechDay 2019杭州站的演讲.
原始阅读: pingcap.com/cases-cn/user-case-jingdongyun /
更多用户习惯:
案例| PingCAP pingcap.com
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-283260-1.html
-
 武尚尚
-
皇太极
别太当回事
-
-
娄明明
在伊拉克
-
藤原启治
应当击沉
 360浏览器批量下载并保存图片
 网络嗅探器(视频侦探)正式版
 W764位旗舰版和纯版本系统下载
 图书销售系统参考