您是否渴望元数据管理实践
电脑杂谈 发布时间:2020-07-16 23:21:31 来源:网络整理
讲师介绍
王金海
饥饿的大数据平台架构师
一个,背景
大数据挑战
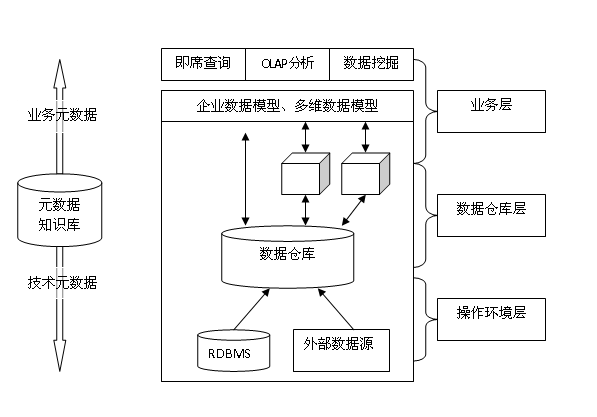
在大数据时代元数据管理,您是否渴望面对诸如数据管理,数据使用和数据问题之类的多重挑战?有关详细信息,请参见下图:
元数据定义和值
元数据打开数据源,数据仓库和数据应用程序,并记录从数据生成到使用的完整链接. 它包含静态表,列和分区信息(即MetaStore). 动态任务和表相关的映射关系;数据仓库模型定义,数据生命周期;和ETL任务计划信息,输入和输出.
元数据是数据管理,数据内容和数据应用程序的基础. 例如,您可以使用元数据在任务,表,列和用户之间构造数据图;构造任务DAG依赖关系并安排任务执行顺序;制作任务画像并执行任务质量管理;并在数据分析过程中使用数据图进行字典检索;根据表名,每个表的源和目的地,每个字段的处理逻辑,查看表的详细信息;提供个人或业务部门资产管理,计算资源消耗概述等.
开源解决方案
LinkedIn的开源元数据治理解决方案在哪里. Azkaban调度程序获取作业执行日志(即Hadoop的JobHistory),在日志解析器之后保存,并提供REST查询. 如果方法太繁琐,则需要部署诸如Azkaban之类的调度程序,并且仅支持血液表,功能限制.
Atlas是Apache的开源元数据管理解决方案. 在Hook执行期间收集数据(例如HiveHook),发送Kafka,使用Kafka数据,生成Relation关系存储图Titan,并提供REST接口查询功能,支持表血液关系,列级支持不完善.
第二,元数据系统体系结构多么饥饿
SQL掩埋点和集合
饥饿的SQL数据主要在保存之前的执行+提交期间收集. 因为任务的SQL可能包含一些时间变量,例如dt,hour,所以该任务可能每天或每小时进行调度. 执行过程中收集的SQL更加实时,更易于处理.
EDW是一个饥饿的调度系统,类似于开源AirFlow. 调度系统执行任务,并将与任务相关的信息(例如appId,jobId,所有者和SQL)存储到中.
计算引擎实现了相关的监视接口,例如Hive实现了Execute With Hook Context接口; Spark实现了Spark Listener接口; Presto实现了事件器接口. 将与计算引擎相关的信息(例如Context,MetaData和Statistics)存储到中.
SQL解析
SQL解决方案分析,以Hive为例. 首先定义词法规则和语法规则文件,然后使用Antrl进行SQL词法和语法分析,生成AST语法树,并遍历AST语法树以完成后续操作.
但是对于SELECT *,CTAS等操作,直接遍历AST,而没有获取Schema信息来检查表名,列名元数据管理,就无法确定SQL的正确性,从而导致数据污染.
总而言之,饥饿的SQL解析解决方案直接引用Hive的基础源代码实现.
以本地为例,首先使用Semantic Analyzer Factory类进行语法分析,然后根据Schema生成执行计划QueryPlan. 关于表和列的血统线,可以从LineageInfo和LineageLogger类获得解决方案.
当然,您需要为某些类型的SQL设置Hive Conf,例如“打开动态分区非严格模式”. 对于CTAS类型,需要设置上下文. UDF函数需要修改部分Hive源代码,以避免UDF注册表检查.
你饿了吗? SQL支持的用于解析血液的操作是: 查询(包括select \ insert \ insert overwrite),CreateTable,CreateTableAsSelect,DropTable,CreateView,AlterView. 基本上涵盖了饥饿的生产环境中超过99%的SQL语法.
选择栗子
拿一个栗子,根据上面的SQL,分别生成表,列的血液结构.

输入是表和列的输入值;输出是表和列的输出值;操作代表操作类型. 例如,表A + B通过插入生成表C,然后扩展为A插入C. B插入C.
此列也是如此:
输入: 名称
操作: 合并(名称,计数(id)),
输出: lineage_name;
输入: id
操作: 合并(名称,计数(id)),
输出: 沿袭名称
表面血液结构
列血统结构
图形存储
具有输入,操作和输出关系,将输入和输出保存为图节点,将操作保存为图边. 图形使用Gremlin + Neo4j.
克里姆林宫是一种图形语言,并且有许多存储实现解决方案. 密码查询不直观,只能由Neo4j使用. Neo4j的社区版本只能在单台计算机上运行,我们正在测试OrientDB.

三个,你饿吗?
以下是您急需元数据应用程序的一些情况:
静态Hive MetaStore表(例如DBS,TBLS,SDS,COLUMNS_V2,TABLE_PARAMS,PARTITIONS)保存表,字段,分区,所有者等基本信息,并简化了表和字段的信息检索功能.
提供依赖于动态表的血液关系查询. 节点是表的基本信息,节点之间的边缘是操作信息. 同时,添加任务执行ID,执行时间和其他属性. 列的血液结构与血液结构相同.
依靠SQL的输入和输出来建立表的依赖关系,进一步建立任务的DAG依赖结构. 您可以对任务执行DAG调度,并重新安排任务执行顺序.
问与答
第一季度: 如何管理我们的数据生命周期,您能具体一点吗?
A: 对表级数据进行热分析,例如在过去三个月中是否没有人访问过它,它是否可以脱机,尤其是某些临时表需要定期清理.
Q2: 质量监控会影响任务安排吗?
A: 这会影响质量流程,而DAG的构建取决于执行.
Q3: 如何计划将SQL中的掩埋数据存储到MySQL?是否应该像日志数据一样处理该埋藏点信息? MySQL中是否存储有一个自递增的全局ID?还是您有用于任务和表的单独的MySQL表,然后更新MySQL表中的任务,表甚至列的信息?这里的MySQL表是您所说的DataSet吗?
A: Jobid是唯一的. MySQL仅保存执行的SQL和作业本身的信息,例如所有者时间jobid等.
Q4: 您当前是否支持非SQL表单生成表?例如,直接使用Spark RDD任务还是Spark MLlib任务来获取并生成表?

A: 仅支持SQL表达式.
Q5: 您如何进行热分析?在目前的解释中,这一点相对较小.
A: 任务操作SQL生成输入输出表. 可以在表到顶部的计数器上执行计数器,并且列相同.
Q6: 您管理的表分为表和表吗?处理时如何处理一些临时表?
A: 是的,或离线,任务计划系统被掩埋,并且临时表根据温度已知.
Q7: 如果使用Hive钩子方法获得了血液关系,是否需要在每个执行节点中捕获它?
A: 在执行过程中调用Hive挂钩,您可以去了解底层.
Q8: 要分析高度复杂的HQL血统,您平台的分析思路是什么?如何确保正确的费率?
A: 将有许多复杂的ppt代码示例,并且需要修改某些SQL才能实现Hive解析.
Q9: 血表中上下级之间的关系是数据流吗?从上到下?该领域的血统与手表的血统有何不同?有野外血统吗?
A: 您可以在分析ppt时看到,该字段是相同的,输入output列然后进行操作
Q10: SQL隐含点,引擎隐含点,是否需要重写Hive的源代码等?
A: 重写是不够的,只要实现ppt中的接口,它就非常简单.
精彩回放
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-282880-1.html
-

-
缘无止境
有道理
 全局钩子_全局钩子c语言_解除全局钩子
 JS 3D模型库
 什么是电脑病毒 欢迎关注“创事记”的微信订阅号:sinac
 渠道效能分析 应加快深化开发区管理体制改革创新
说白了就是要个面子