数据仓库构建-OLAP和数据多维数据集概念
电脑杂谈 发布时间:2020-07-15 05:06:32 来源:网络整理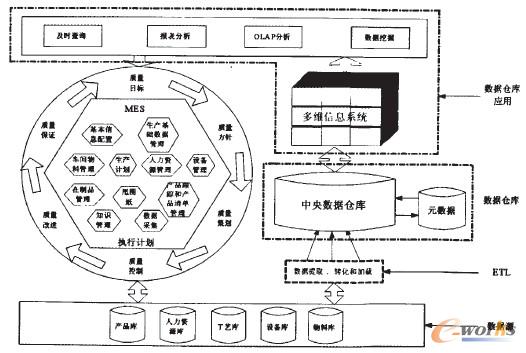
I. OALP概述
数据立方体,他是用于OLAP和OLAP操作(例如上滚,下钻,切片和切割)的多维数据模型. 数据多维数据集存储主要是聚合信息. 每个单位存储一个聚合值,该值对应于多维空间中的一个数据点. 每个属性都可能存在概念层次结构,从而可以在多个抽象级别进行数据分析.
在最低抽象级别创建的多维数据集称为基本多维数据集. 基本多维数据集应对应于感兴趣的单个实体,例如销售或客户. 换句话说,最低级别应该对分析可用或有用. 最高的抽象立方体称为顶点立方体. 为不同层创建的数据多维数据集称为多维数据集,因此可以将数据多维数据集视为多维数据集. 每个更高的抽象将进一步减小结果数据的大小. 在回答OLAP查询或数据挖掘查询时,应使用与给定任务相关的最小可用多维数据集.
OLTP: 交易物理系统,主要任务是执行交易和查询处理.
OLAP: 分析处理,在数据分析和决策过程中为用户或“知识工作者”提供服务. 该系统可以组织和提供不同格式的数据,以满足不同用户的不同需求.
OLTP和OLAP之间的主要区别总结如下:
第二,OLAP系统构建

外部数据源: 外部数据源主要包括分散在各个业务部门中的业务数据源系统,用于报告数据的应用程序掩埋点以及从网络爬网的一些数据. 业务通常是一个关系系统,用于记录业务方的业务信息. 应用掩埋点报告数据是企业方法的一些应用系统,以及通过这些应用系统收集的一些用户行为信息;在网络上爬网的数据,包含比赛数据,权威机构发布的数据以及一些有用的辅助信息. 底层数据仓库服务器: 通过一些后端工具和实用程序,从操作和其他外部数据源中提取数据,并将其放入底层. 这些工具和实用程序执行数据提取,清理和转换以及加载和刷新,以更新数据仓库. 中间层是OLAP服务器: 它的典型实现使用关系OLAP模型或多维OLAP模型. 顶层是前端客户端层: 它包括查询和报告工具,分析工具或数据挖掘工具(例如趋势分析,预测等).
三,了解数据仓库
1. 数据仓库简介
从结构的角度来看,存在三种数据仓库模型: 企业仓库,数据集市和虚拟仓库.

企业仓库: 企业仓库收集有关主题的所有信息,并覆盖整个企业. 他通常在一个或多个运行中的系统或的数据集成,并且功能多样. 通常,它包含详细数据和摘要数据,其范围从几TB到数百TB,数千TB甚至更大. 企业数据仓库可以在传统的大型机,超级计算机服务器或并行体系结构平台上实现. 它需要广泛的业务建模,并且可能需要多年的构建和设计.
数据集市: 数据集市包含企业范围数据的子集,这对于确定用户组很有用. 现在将其范围设置在所选主题上. 例如,销售数据集市可以将其主题限制为客户,商品和销售. 通常会汇总数据集市中包含的数据.
虚拟仓库: 虚拟仓库是操作上的视图的集合. 为了有效地处理查询,仅实现了一些可能的摘要视图. 虚拟仓库易于设置,但是仍然有备用电源来操作服务器.
2. 数据仓库建设
数据仓库开发是自上而下还是自上而下?
自上而下的企业仓库开发是一种系统的解决方案,可以最大程度地减少集成问题. 但是,它昂贵,开发周期长且缺乏灵活性,因为整个组织很难就通用数据模型达成共识.
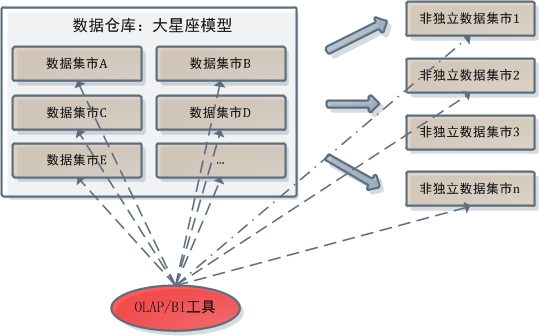
独立数据集市的自下而上的设计,开发和配置可提供灵活性,低成本和快速的投资回报. 但是,集成去中心化数据集市以形成一致的企业数据仓库可能会引起问题.
对于数据仓库系统的开发,推荐的方法是以增量和演进的方式实现数据仓库. 首先,在合理的短时间内定义一个更高级别的企业数据模型,该模型提供企业范围内,不同主题和可能应用程序之间数据的一致,集成的视图. 尽管需要在企业数据仓库和部门数据集市的开发中进一步完善,但这种高级模型将大大减少将来的集成问题. 其次,基于上述相同的企业数据模型,可以并行实现独立的数据集市和企业数据仓库. 第三,您可以通过中央服务器集成不同的数据集市olap与数据仓库互补,以构建分布式数据集市. 最后,构建多层数据仓库. 在这里,企业仓库是所有仓库数据的唯一管理者,并且仓库数据分布在某些相关的数据集市中.

3. 数据提取,转换和加载
数据仓库系统使用后端工具和实用程序来加载和刷新他的数据. 这些工具和实用程序包括以下功能:
数据仓库通常还提供一组数据仓库管理工具. 数据清理和数据转换是提高数据质量以及后续数据挖掘结果质量的重要步骤.

4. 元
元数据是关于数据的数据. 在数据仓库中,元数据是定义仓库对象的数据. 元数据位于数据仓库体系结构的底部. 对于给定的数据仓库数据名称和定义,创建元数据. 其他元数据包括添加到提取的数据的时间戳,提取的数据的源,通过数据清理或集成处理添加的缺失字段等.
配置应包括以下内容:
数据仓库包含不同的摘要层,元数据就是其中之一. 其他类型包括当前的详细数据,旧的详细数据,稍微汇总的数据和高度汇总的数据.
四个数据仓库模型: 数据立方体和OLAP
数据仓库和OLAP工具基于多维数据模型. 此模型将数据视为数据多维数据集. 主要包括: 数据多维数据集建模n维数据,各种多维模型-星型模型,雪花模型和事实星座. 还可以进行分层和测量,以及上下滚动.
1. 什么是数据立方体
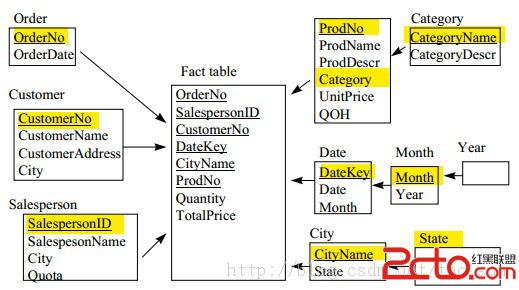
数据多维数据集允许对数据进行建模和多维查看. 它是由维持和平事实定义的. 通常,维是单位要记录的透视图或实体. 通常,多维数据模型是围绕诸如销售之类的中心主题组织的. 主题由事实表表示. 事实是用数字来衡量的. 事实表包括事实的名称或度量,以及每个相关维度表的代码. 存储最低级别摘要的多维数据集称为基本多维数据集.
2. 多维数据模型
数据仓库中最受欢迎的数据模型是多维数据模型. 这样的模型可以是星形模型,雪花模型或事实上的星座模型.
3. 维度: 概念分层的作用
概念层次结构定义了一个映射序列,该序列将基础概念集映射到更高级别,更一般的概念. 例如,时间: 小时->周->月->年. 概念分层允许用户根据他们的特定需求减少预定义的分层. 还可以通过给定维度或属性的离散化或分组来定义概念层次结构,以产生集合组层次结构. 您可以定义值组合之间的总顺序或部分顺序.
概念层次结构可以由系统用户,领域专家和知识工程师手动提供,也可以根据数据分布的统计分析自动生成.
4. 指标的分类和计算
数据多维数据集空间中的多维点可以由一组维值对定义. 数据多维数据集指标是一个数字函数,可以评估数据多维数据集空间中的每个点. 通过给定点的每个维值对汇总数据,计算该点的度量值.
根据所使用的聚合函数,度量可以分为三类: 分布式,代数和全局.
大多数数据多维数据集应用程序都需要有效地计算分布式度量和代数度量,并且对此有许多有效的技术. 相反,更难于有效地计算总体指标. 但是,对于某些全局函数的近似计算,存在有效的技术.
5. 典型的OLAP操作
在多维数据模型中,数据是在多维空间中组织的,每个维都包含由概念层次结构定义的多个抽象层. 该组织为用户提供了从不同角度查看数据的灵活性. 有一些OLAP数据多维数据集操作用于实现这些不同的视图,从而允许交互式查询和分析手头的数据. 因此,OLAP为交互式数据分析提供了一个友好的环境.
6. 用于查询多维的星形网络查询模型
多维查询可以基于星形网络模型. 星形网络模型由从中心点发出的射线组成,每条射线代表一个概念上的层次维度. 概念层次结构中的每个“抽象级别”都称为足迹,表示可用于OLAP操作(例如上滚,下钻等)的粒度.
例如: 星形网络由四条射线组成,代表维度位置,客户,项目和时间的概念. 每条线都由一些覆盖区组成,这些覆盖区代表维度的抽象级别. 例如,时间线有4个足迹: 日,月,季度和年. 概念层次结构可以包含一个或多个属性. 要调查产品销售情况,用户可以从一个月到每个季度沿时间维度向上滚动,或者从一个国家到城市沿位置维度进行追溯.
通过用较高级别的抽象值替换较低级别的抽象值,概念层次结构可以用于概括数据. 通过将高级抽象值替换为低级抽象值,概念层次结构还可以使数据专用化.
7. 多维数据挖掘
多维数据挖掘将数据挖掘与OLAP集成在一起,以发现多维中的知识. 在许多不同的数据挖掘示例和结构中,多维数据挖掘特别重要,原因如下:
8. 有效计算数据立方体
多维数据分析的核心是有效地计算多维集合上的聚合. 用SQL术语,这些聚合称为分组依据. 每个分组都可以由一个长方体表示,并且分组的集合形成一个网格,该网格定义了数据多维数据集的多维数据集.
①计算多维数据集运维灾难
多维数据集计算的一种方法是扩展SQL以包括计算多维数据集操作. 计算多维数据集操作将计算指定维的所有子集上的聚合. 这可能需要大量的存储空间,尤其是对于大量尺寸. 例如: 存在一个包含城市,项目,年份的数据多维数据集,该数据多维数据集计算的多维数据集或组的总数为2乘以3 = 8的幂. 基本多维数据集是最低的广义多维数据集. 顶点立方体是最通用的立方体. 从顶点多维数据集开始,向下浏览该多维数据集,这等效于在数据多维数据集中进行向下钻取. 从基本多维数据集向上浏览类似于滚动.
不分组的SQL查询是0维操作. 包含组的SQL查询是一维操作. n维的多维数据集运算等效于一组分组语句,每个语句对应于n维的子集. 对于不同的查询,OLAP可能需要访问不同的多维数据集. 因此,预先计算所有或至少一部分立方体. 预计算带来了快速的响应时间,并避免了一些多余的计算. 但是,预先计算的挑战在于,如果预先计算了数据多维数据集中的所有多维数据集,则所需的存储空间可能会爆炸,尤其是当多维数据集包含许多维时. 当许多维具有关联的概念层次结构并具有多个层时,存储需要更多. 这是维吾尔族灾难.
②部分理化: 立方体的选择计算
多维数据集或子多维数据集的部分实现应考虑三个因素: 确定要实现的多维数据集的子集或子多维数据集;在查询处理期间使用实体化的多维数据集或子多维数据集;在加载和刷新时有效. 更新的实例化多维数据集或子多维数据集. 实体化多维数据集或子多维数据集的选择需要考虑工作负载下的查询,以及查询的频率和访问开销. 此外,还必须考虑工作负载的特性,增量更新的成本以及整个存储需求. 选择还必须考虑物理的设计.
另一种常见策略是实现壳立方. 这涉及仅计算几个维度的数据多维数据集. 可以临时计算其他尺寸组合的查询.
③通用OLAP索引: 位图索引和连接索引
位图索引: 在OLAP产品中非常流行,因为它允许在数据多维数据集中快速搜索. 位图索引是record_ID(RID)列表的替代表示. 在给定属性的位图索引中,属性字段中的每个值v具有不同的位向量Bv. 如果给定的属性字段包含n个值,则位图索引中的每个项目都需要n位. 如果属性值在数据表的给定行上为volap与数据仓库互补,则位图索引中的相应行指示该值的位为1,而该行的其他位均为0.
连接的索引: 该方法的流行源于他在关系查询处理中的应用. 传统索引将给定列上的值映射到具有该值的行列表. 相反,联接索引从关系中注册两个关系的可连接行. 例如: 如果两个关系R(RID,A)和S(B,SID)连接在属性A和B上,则连接索引记录包含(RID,SID)对,其中RID和SID来自关系R和S,分别记录标识符. 因此,连接索引记录可以标识可连接的元组,而不必执行昂贵的连接操作. 连接索引对于维护可连接关系中的外部代码与匹配的主代码之间的连接特别有用.
④有效处理OLAP查询
实现多维数据集和构造OLAP索引结构的目的是加快数据多维数据集查询处理. 给定一个实例化视图,查询处理应按以下步骤进行:
例如: 以sales_cube [time,item,location]: sum(sales_in_dollars)“的形式定义一个数据多维数据集. 使用的维层次结构为day
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-280807-1.html
-

-
卢象
降息后
 2015年氪估值排行榜top500_2015游戏钱排行榜_中国公司估值排行榜
 FPS低的原因是什么
 在N个元素中查找第k大的元素,有什么方法最快?
 这篇文章完美解决Win7声卡驱动安装失败的问题!
也许美帝就是来溜一圈立马就滚出12海里