Linux对象存储文件系统研究
电脑杂谈 发布时间:2020-07-12 01:33:54 来源:网络整理
吴庆波
2004年10月1日发布
高性能计算已从传统的主机模式逐渐演化为集群模式. 例如,在TOP500中,1998年只有两个系统是集群模式,到2003年,有208个单元是集群系统. 随着高性能计算体系结构的发展和变化,传统的基于主机的存储体系结构已成为新的瓶颈,无法满足集群系统的需求. 集群存储系统必须有效解决两个主要问题: (1)提供共享的访问数据,以方便集群应用程序的编写和存储的负载平衡; (2)提供I / O级别和数据吞吐率的高性能存储,可以满足数十万个Linux群集服务器的总体访问需求. 目前,网络存储已成为集群系统中高性能存储的有效技术手段.
世界上有两种主要类型的网络存储体系结构,它们通过命令集来区分. 第一种是SAN(存储区域网络)结构,它使用SCSI块I / O命令集通过磁盘或FC(光纤通道)级别的数据访问提供高性能的随机I / O和数据吞吐量. 凭借高带宽和低延迟的优势,它在高性能计算中占有一席之地. 例如,SGI的CXFS文件系统基于SAN,以实现高性能的文件存储. 但是,由于SAN系统的价格较高和可扩展性较差,因此已经无法满足系统成千上万的CPU规模. 第二种是NAS(网络附加存储)结构,它使用NFS或CIFS命令集访问数据,使用文件作为传输协议,并通过TCP / IP实现网络存储. 它具有良好的可扩展性,低廉的价格,并且易于用户管理,例如,目前在集群计算中使用了更多的NFS文件系统,但NAS协议开销大,带宽低,时延大,不利于高带宽应用. 性能集群.
为了满足Linux群集对高性能存储系统和数据共享的需求,国外已经开始研究新的存储体系结构和新的文件系统,希望有效地结合SAN和NAS系统的优势,并支持直接访问. 磁盘以提高性能. 共享文件和元数据以简化管理. 目前,对象存储文件系统已经成为Linux集群系统中高性能文件系统的研究热点,例如Cluster File Systems的Lustre和Panasas的ActiveScale file system. Lustre文件系统使用基于对象的存储技术,该技术源自卡耐基梅隆大学的Coda项目研究工作. Luster 1.0版于2003年12月发布,而2.0版预计于2005年发布. Luster最初用于劳伦斯·利弗莫尔国家实验室的美国能源部(美国能源部)的高性能计算系统中. ,洛斯阿拉莫斯国家实验室,桑迪亚国家实验室,太平洋西北国家实验室,IBM正在开发中的Blue Gene系统还将使用Luster文件系统来实现其高性能存储. ActiveScale文件系统技术来自卡内基梅隆大学的Garth Gibson博士. 这是DARPA支持的第一个NASD(网络附加安全磁盘)项目. 它是目前业界最具影响力的对象存储文件系统,并获得了ComputerWorld 2004创新技术奖.
对象存储文件系统的核心是将数据路径(读取或写入数据)和控制路径(元数据)分开,并基于每个对象的基于对象的存储设备(OSD)构建存储系统存储该设备具有一定的智能,可以自动管理其上的数据分发. 对象存储文件系统通常由以下部分组成.
1. 对象
对象是系统中数据存储的基本单位. 对象实际上是文件数据和一组属性的组合. 这些属性可以定义基于文件的RAID参数,数据分布和服务质量. 传统存储系统文件或块用作基本存储单元. 在块存储系统中,还必须跟踪系统中每个块的属性. 该对象通过与存储系统通信来维护其自己的属性. 在存储设备中,所有对象都有一个对象ID,并且可以通过对象ID OSD命令访问该对象. 通常有多种类型的对象. 存储设备上的根对象标识存储设备和设备的各种属性. 组对象是共享资源管理策略的存储设备上的对象的集合.
对象存储设备具有一定的智能. 它具有自己的CPU,内存,网络和磁盘系统. 当前,刀片存储结构在世界上通常用于实现对象存储设备. OSD提供了三个主要功能:
(1)数据存储. OSD管理对象数据并将其放置在标准磁盘系统上. OSD不提供块接口访问方法. 客户端在请求数据时使用对象ID和偏移量来读写数据.
(2)智能分配. OSD使用其自己的CPU和内存来优化数据分配并支持数据预取. 由于OSD可以智能地支持对象的预取,因此可以优化磁盘的性能.
(3)每个对象的元数据管理. OSD管理存储在其上的对象的元数据. 此元数据类似于传统的inode元数据,通常包括对象的数据块和对象的长度. 在传统的NAS系统中,这些元数据由文件服务器维护,而对象存储体系结构则通过OSD完成系统中的主要元数据管理,从而减少了客户端的开销.
MDS控制Client和OSD对象之间的交互,主要提供以下功能:
(1)对象存储访问. MDS构造和管理描述每个文件分布的视图,从而允许客户端直接访问该对象. MDS使客户端能够访问文件中包含的对象. OSD将在接收每个请求之前验证此功能,然后才能对其进行访问.
(2)文件和目录访问管理. MDS在存储系统上构建文件结构,包括配额控制,目录和文件的创建和删除以及访问控制.
(3)客户端缓存一致性. 为了提高客户端的性能,通常在对象存储文件系统的设计中支持客户端缓存. 由于在客户端上引入了缓存,因此带来了缓存一致性问题. MDS支持基于客户端的文件缓存. 当缓存文件更改时,将通知客户端刷新缓存,从而避免了由缓存不一致引起的问题.
为了有效地支持客户端访问OSD上的对象,有必要在计算节点上实现对象存储文件系统的客户端. 它通常提供POSIX文件系统接口,使应用程序能够像标准文件系统操作一样执行.
1. 分布式元数据传统的存储结构元数据服务器通常提供两个主要功能. (1)提供用于存储数据的逻辑视图(虚拟文件系统,VFS层)lustre并行文件系统,文件名列表和计算节点的目录结构. (2)组织物理存储介质(inode层)的数据分发. 对象存储结构将存储的数据的逻辑视图与物理视图分开,并分配负载以避免元数据服务器(例如NAS系统)引起的瓶颈. 元数据的VFS部分通常是元数据服务器负载的10%,其余90%的工作(inode部分)是在存储媒体块数据的物理分布上完成的. 在对象存储结构中,将索引节点工作分配给每个智能OSD,每个OSD负责管理数据的分发和检索,从而将90%的元数据管理工作分配给智能存储设备,从而提高系统元数据管理的性能. . 此外,分布式元数据管理在向系统添加更多OSD时,可以同时提高元数据性能和系统存储容量.
2. 并发数据访问对象存储体系结构定义了一个新的,更智能的磁盘接口OSD. OSD是连接到网络的设备. 它包含存储介质(例如磁盘或磁带),并且具有足够的智能来管理本地存储的数据. 计算节点直接与OSD通信并访问其存储的数据. 因为OSD是智能的,所以它不需要文件服务器的干预. 如果文件系统的数据分布在多个OSD上,则总I / O速率和数据吞吐速率将线性增加. 对于大多数Linux群集应用程序,连续的I / O聚合带宽和吞吐率都相对较大. 计算节点的目的非常重要. 当前,对象存储结构提供的性能是其他存储结构难以实现的,例如ActiveScale对象存储文件系统的带宽可以达到10GB / s.
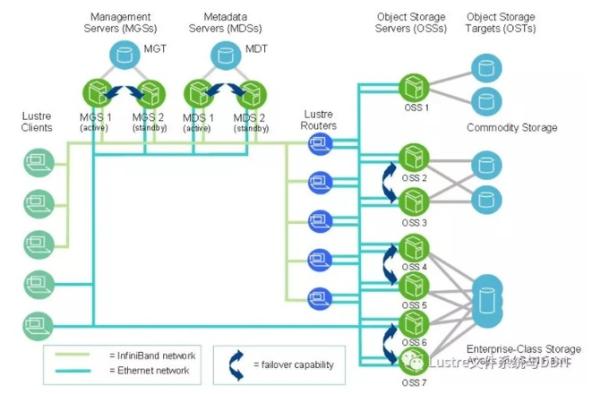
Lustre对象存储文件系统由三个主要部分组成: 客户端,存储服务器(OST,对象存储目标)和元数据服务器(MDS). Lustre客户端运行Lustre文件系统,该文件系统与OST交互以进行文件数据I / O,并与MDS进行命名空间操作. 为了提高Lustre文件系统的性能,通常将Client,OST和MDS分开,当然,这些子系统也可以在同一系统中运行. 它的三个主要部分如图1所示.

Lustre是透明的全局文件系统. 客户端可以透明地访问群集文件系统中的数据,而无需知道数据的实际存储位置. 客户端通过网络读取服务器上的数据,存储服务器负责实际文件系统的读写操作以及存储设备的连接,元数据服务器负责文件系统的目录结构,文件文件的权限和扩展属性,并维护整个文件系统的数据一致性和对客户端请求的响应. Lustre将文件视为元数据服务器定位的对象. 元数据服务器将实际文件I / O请求定向到存储服务器lustre并行文件系统,该服务器管理基于对象的磁盘组上的物理存储. 由于元数据和存储数据的分离,计算和存储资源可以完全分离,因此客户端计算机可以专注于用户和应用程序请求. 存储服务器和元数据服务器专注于读取,传输和写入数据. 存储服务器端的数据备份和存储配置以及存储服务器扩展等操作不会影响客户端,并且存储服务器和元数据服务器都不会成为性能瓶颈.

Lustre的全局名称空间为文件系统的所有客户端提供了有效的全局唯一目录树,并阻止了数据,然后将数据分发到每个存储服务器,提供了比传统SAN更多的功能. “块共享”是一种更灵活的共享访问方式. 全局目录树消除了客户端上的配置信息,并在更新配置信息时保持有效.
对于对象存储文件系统,我们对Luster文件系统进行了初步测试,具体配置如下:
3个双Xeon系统: CPU: 1.7GHz,内存: 1GB,千兆以太网
Lustre文件系统: lustre-1.0.2
Linux版本: RedHat 8
测试程序: iozone
测试结果如下:
块写入(MB / s /线程)单线程两个线程
1 OST
2个OST
1 OST

2个OST
21.7
50
12.8
24.8
NFS
12
5.8
以上测试表明,单个OST的写带宽优于NFS,两个OST的可扩展性非常好,显示了条带化的效果. 两个线程的总带宽基本上等于饱和带宽,但是光泽客户端的CPU使用率很高(超过90%),并且测试系统的规模(三个节点)受到限制,因此OST和客户端的数量没有增加. 此外,Lustre的缓存比NFS更好地改善了文件写入性能. 通过bonnie ++,我最初测试了lustre的元数据处理能力. 与NFS相比,文件创建速度相对较快,而readdir速度较慢.
(文件写入测试,单位KB / s):
硬件: Dual Xeon1.7,GigE,SCSI Ultra160软件: RedHat8,iozone


从初步测试来看,Lustre的性能和可伸缩性都不错. 与传统文件系统相比,对象存储文件系统具有以下优点:
(1)性能. 对象存储体系结构没有其他共享存储系统中元数据管理器的瓶颈. NAS系统使用集中式文件服务器作为元数据管理器,而某些SAN文件系统使用集中式锁管理器. 最后,元数据管理将成为瓶颈. 对象存储体系结构类似于SAN,每个节点都可以直接访问其存储设备. 对象存储体系结构对SAN的改进是RAID控制器没有瓶颈问题. 当计算节点的大小增加时,优势将非常明显. 所有节点的总吞吐量最终将受到存储系统的大小和大小的限制. 网络的性能. 存储对象节点将数据发送到OSD. OSD自动优化数据分配,从而减轻了计算节点的负担,并允许对多个OSD进行并行读写,以最大化单个客户端的吞吐量.
(2)可伸缩性. 将负载分配给多个智能OSD,并使用网络和软件将它们有机地结合在一起,从而消除了可伸缩性问题. 对象存储系统具有内存,处理器,磁盘系统等,使它们可以增加其存储处理能力,而与系统的其余部分无关. 如果对象存储系统没有足够的存储处理能力,则可以增加OSD以确保性能线性增加.
(3)OSD共享主要的元数据服务任务. 元数据管理功能通常是共享存储系统的瓶颈,所有计算节点和存储节点都需要访问它. 在对象存储结构中,元数据服务由两部分组成: inode元数据,它管理介质上存储块的分配;文件元数据,它管理文件系统的文件层次结构和目录. 对象存储结构增加了元数据访问的可伸缩性. OSD负责自己的inode元数据. 添加OSD可以增加磁盘容量,并可以增加元数据管理资源. 尽管传统的NAS服务器添加了更多磁盘,但性能将会降低. 对象存储系统可在扩展容量时确保连续的吞吐率.
(4)易于管理. 智能分布式对象存储结构可以简化存储管理任务,简化数据优化分发的任务. 例如,由于OSD可以接受来自计算节点的对象请求,因此可以将新添加的存储容量自动合并到存储系统中. 系统管理员不需要创建LUN,重新调整分区,重新平衡逻辑卷或更新文件服务器. RAID块可以自动扩展到新对象,从而充分利用新添加的OSD.
(5)安全性. 传统存储系统通常依赖于客户端的身份认证和专用网络来确保系统安全性. 对象存储结构在每个级别提供安全功能,主要包括存储设备的身份验证,计算节点的身份验证,计算节点命令的身份验证,所有命令的完整性检查,私有数据和基于IPSec的命令,等. 这些安全级别可以确保用户使用更高效,更易访问的网络,例如以太网. 目前Panasas已推出商业对象存储全局文件系统ActiveScale,对象存储受到重视,Lustre也已应用于(ALC,MCR)或将(RedStorm)应用于多个大型集群,因此对象存储文件系统将成为集群存储的重要发展方向.
并行文件系统研究团队大力支持本文的测试工作,尤其是周恩强,董勇,林松涛和陈思坚为本文提供了详细的数据.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-277111-1.html
-

-
王成伟
我见过好
 weixin_30480583
 计算机OCR字符识别技术的原理和未来发展趋势
 semaphore java.util.concurrent常用类(Cou
 C语言中的Static和内联函数
看来米国已经把中国摸了很透彻了