简要描述搜索引擎的工作原理
电脑杂谈 发布时间:2020-06-29 14:13:14 来源:网络整理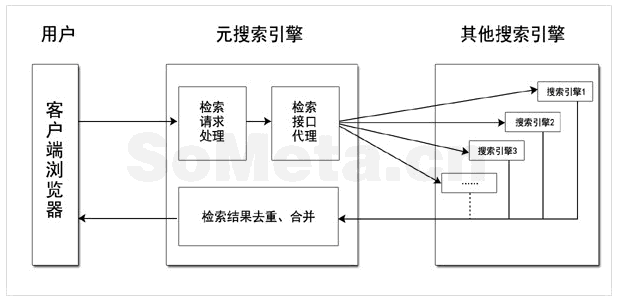
搜索引擎原理
搜索引擎的原理编辑搜索引擎通常指的是全文搜索引擎,它可以在万维网上收集数百到数百亿个网页,并对网页上的每个单词(即关键字)建立索引,索引. 当用户搜索关键字时,页面内容中包含该关键字的所有页面都将被搜索出来作为搜索结果. 通过复杂的算法(或包括商业出价排名,商业促销或广告)进行排序后,将根据与搜索关键字的相关程度(或与相关无关)对这些结果进行排序.
原理概述

原理概述编辑器位于搜索引擎的后台,有一些用于收集Web信息的程序. 所收集的信息通常是可以指示网站内容的关键字或短语(包括网页本身,网页的URL地址,构成网页的代码以及与网页之间的连接). 然后将该信息的索引存储在中.

搜索引擎的系统架构和操作方法吸收了信息检索系统设计中的许多宝贵经验,并对Web数据和用户的特征进行了许多修改,例如右侧所示的搜索引擎系统架构. . 核心文档处理和查询处理过程基本上类似于传统信息检索系统的操作原理,但是它处理的数据对象(即万维网数据)的复杂特性决定了搜索引擎系统必须调整系统结构以适应处理数据和用户查询需求.

编辑工作原理
爬行和爬行
搜索引擎发出一个程序,该程序可以查找新网页并在Internet上获取文件. 该程序通常称为蜘蛛. 从已知的开始,搜索引擎可以像访问普通用户的浏览器一样访问这些网页并抓取文件. 搜索引擎使用这些搜寻器来搜寻Internet上的外部链接,从该网站搜寻到另一个网站,跟踪网页中的链接以及访问更多网页. 此过程称为爬网. 这些新的URL将存储在要搜索的中. 因此,跟踪Web链接是搜索引擎蜘蛛发现新URL的最基本方法,因此反向链接已成为搜索引擎优化的最基本因素之一. 搜索引擎抓取的页面文件与用户浏览器获得的页面文件完全相同搜索引擎的主要工作原理,抓取的文件存储在中.

创建索引
由Spider爬网的页面文件将被分解,分析并以巨大表的形式存储在中. 这个过程是一个索引. 在索引中,将显示网页的文本内容,关键字的位置,字体和颜色,并相应记录粗体,斜体和其他相关信息.
搜索字词

管理用户在搜索引擎界面上输入关键字,然后单击“搜索”按钮,搜索引擎程序将处理搜索词,例如中文特殊词分割处理,删除停用词,确定是否有必要启动综合搜索,判断是否有拼写错误或错别字?搜索词必须很快处理.
排序
处理完搜索字词后,搜索引擎程序开始工作搜索引擎的主要工作原理,从索引中查找包含搜索字词的所有页面,并根据排名算法计算哪些页面应首先排名,然后返回到“搜索”以某种格式“页面”.
无论搜索引擎多么出色,它都无法与人们相提并论. 这就是为什么网站应该经过搜索引擎优化的原因. 没有SEO的帮助,搜索引擎通常无法正确返回最相关,权威和有用的信息.
最后,感谢您的耐心等待,请点击观看〜下次见!
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-262437-1.html
-

-
闫艺克
只要不是军用目的或者长期停靠
-
姚鹄
到你现在几千元
-
邓超
要闹到厂家厂家会赔他一张控告书
-
 冠状病毒会传染人吗 关于中东呼吸综合征(MERS)应该了解的那些事
 运维体系 实时计算平台 人工智能给云时代的智能运维带来了哪些创新
 [学习笔记]双向链表
你知道多少华人在美国服务吗