AWK简介
电脑杂谈 发布时间:2020-06-25 00:50:21 来源:网络整理
如何显示文本内容,而不是修改文件,
还逐行读取文件
格式:
awk [选项]“程序”文件
选项选项:
 -F  指明输入时用到的字段分隔符
 -v var=value   自定义变量
程序模式: 模式{动作.....}
 pattern:匹配到相应的行,不标注时匹配整个文件
 action: 匹配到匹配的行时,所要做的动作。常用的为打印 print printf(更复杂的打印时使用此选项)
例如:
awk –F: ‘{print $ 1,$ 2}’/ etc / passwd

awk -F: '{print $ 1“ \ t \ t \ t” $ 5}'/ etc / passwd
“ t”表示Tab键

awk -F: '{printf $ 1“ \ t \ t \ t” $ 5“ n”}'/ etc / passwd
printf打印默认情况下不支持换行符,您需要添加n
谨记:printf 打印内容时,变量不加”” 。

可以熟练使用多种锻炼方式
与-v一起使用
FS: 输入字段分隔符,默认为空白字符
awk-v FS =': ''{{打印$ 1,FS,$ 3}’/ etc / passwd
OFS: 输出字段分隔符,默认为空白字符
RS: 输入记录分隔符,输入时指定换行符,原始换行符仍然有效
ORS: 输出记录分隔符,输出时将行字符替换为指定的符号
NF: 字段数
NR: 行号
FNR: 每个文件的计数和行号分别
FILENAME: 当前文件名
ARGC: 命令行参数的数量
ARGV: 数组,保存命令行上给定的参数
以下是使用变量的示例:
bash中定义的变量也可以直接在awd中使用

NR行号
FNR分别计算每个文件
由NF拆分的字段数,此变量可用于数组
   NF和$结合起来有更好的妙用
   $NF
   print里面同样支持数值运算


ARGC: 命令行参数的数量,其中“程序”不被视为参数
如以下示例所示,
awk和最后一个文件被计为参数
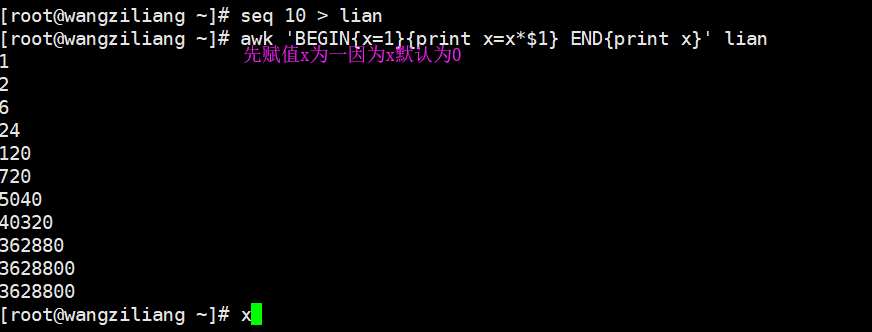


示例:
awk-v test ='hello gawk'{print test}'/ etc / fstab
awk-v test ='hello gawk'BEGIN {print test}'
awk'BEGIN {test =“ hello,gawk”; printtest}'
awk–F: “ {sex =“ male”; print $ 1,sex,age; age = 18}” / etc / passwd
printf中未添加字符串“”,默认情况下将printf识别为变量
默认情况下awk数组初始化,没有换行符,您需要在换行符中添加n
格式:
该格式应使用“”
括起来
%c: 显示字符的ASCII码
%d ,:显示十进制整数
%f: 显示为浮点数
%s: 显示字符串
%%: 显示%self
修饰符:
(#. #)第一个数字控制显示屏的宽度;第二个#表示小数点%3.1f
之后的精度
-: 左对齐(默认情况下为右对齐)%-15s,15表示宽度
+: 显示值%+ d
的符号
修饰符通常写在格式的中间,以进一步描述格式
格式和修饰符将在以后修改变量打印的格式
应用示例:
1)格式
全面使用%s%d n个字符宽度
左对齐宽度为25个字符

2)添加字符串显示

算术运算符:
x + y,x-y,x * y,x / y,x ^ y,x%y
-x: 转换为负数
+ x: 转换为数值
分配运算符:
=,+ =,-=,* =,/ =,%=,^ =
++,-
比较运算符:
==,!=,>,> =,<,<=
逻辑运算符: AND &&,OR ||,不是!
示例:
•awk –F: '$ 3> = 0 && $ 3 <= 1000 {print $ 1}'/ etc / passwd

•awk -F: '$ 3 == 0 || $ 3> = 1000 {print $ 1}'/ etc / passwd
•awk -F: ``!($ 3 == 0){print $ 1}'/ etc / passwd
•awk -F: ‘!($ 3> = 500){print $ 3}’/ etc / passwd
此块非常重要,归根结底,它仍然是常规的熟练使用方法
〜: 左匹配项和右匹配项包括!〜: 不匹配项
匹配的内容以“”或///
为框架
awk–F: '$ 0〜/ root / {print $ 1}'/ etc / passwd
awk'$ 0〜“ ^ root”'/ etc / passwd
awk'$ 0!〜/ root /‘/ etc / passwd
awk–F: “ $ 3 == 0” / etc / passwd
应用示例:
awk -F: '$ 0〜/ root / {printf $ 0“ n”}'/ etc / passwd

如何编写正则表达式:
awk -F: '$ 0〜/ ^ root / {printf $ 0“ n”}'/ etc / passwd


模式匹配和运算符的全面使用:
awk -F: '$ 3> = 500 {printf $ 0“ n”}'/ etc / passwd

awk -F: '$ 3> = 500 && $ 3 <= 1000 {printf“%-25s%-20dn”,$ 1,$ 3}'/ etc / passwd

如果逻辑不正确,则必须添加以下比较运算符()
awk -F: '!($ 3> = 500){printf“%-25s%-20d \ n”,$ 1,$ 3}'/ etc / passwd

选择器?if-true-expression: if-false-expression
awk格式:
awk选项“模式{action}”文件
模式: 根据模式条件,过滤匹配的行,然后进行处理,不匹配的行将不被处理
awk'/ ^ UUID / {print $ 1}'/ etc / fstab
打印以UUID开头的行的 第一个字段


awk'!/ ^ UUID / {print $ 1}'/ etc / fstab
打印不以UUID开头的行的第一个字段

打印分区利用率

如果结果为“ true”,则将处理结果
是: 结果是一个非零值,一个非空字符串
否: 结果是一个空字符串或0值
0,没有内容被视为0值


awk -F: -v n = 0'n ++ {printf“%-25s%sn”,$ 1,$ 5}'/ etc / passwd
此例子很有意思,因为awk是一行一行处理,所以此次输出的结果是第一行没有,后面的行都有输出 
注意: 打印多次,在中间添加;

不显示/ etc / passwd中以/ bin / bash结尾的行
1)awk -F: '$ NF!=“ / bin / bash”'/ etc / passwd

2)此措词使用〜匹配符号
awk -F: '$ NF!〜/ bash $ /'/ etc / passwd

起始行,结束行: / pat1 /,/ pat2 /不直接提供数字格式
一旦找到part1,它将打印并匹配,直到part2结束该循环
再次找到part1并开始打印,找到pqrt2并结束.......
例如:
awk'/ ^ r /,/ ^ h /'/ etc / passwd
匹配以r开头的行以h开头的行

awk'NR> = 10 && NR <= 20 {print NRawk数组初始化,$ 0}'/ etc / passwd
将第10行打印到第20行

在开始和结束时打印,与其他人无关
awk -F: 'BEGIN {print“ usernameuid”} NR> = 10 && NR <= 20 {printf“%-20s%-10sn”,$ 1,$ 3}'/ etc / passwd

添加标题
awk -F: 'BEGIN {打印“ usernameuidn -------------------------------”} NR> = 10 && NR <= 20 {printf“%-20s%-10sn”,$ 1,$ 3} END {print“ ---------------------------- -----“}'/ etc / passwd
添加列:
awk -F: 'BEGIN {打印“ usernameuidn -------------------------------”} NR> = 10 && NR <= 20 {printf“%-20s |%-10sn”,$ 1,$ 3} END {print“ --------------------------- ------“}'

常用: 动作
常用控制语句:
格式:
if(condition){statement;…} [else statement]
if(condition1){statement1}否则if(condition2){statement2}
else {statement3}
打印/ ets / fstab一行中有5个以上字段的示例

awk中的内置循环,而中进行循环处理
示例:
awk -F: '{i = 1; while(i <= NF){print $ i,length($ i); i ++}}}'/ etc / passwd


格式: 对于(1,2,3){4}
特殊用法是: 遍历数组中的元素,后续介绍
break中断循环;继续,跳出此循环并转到下一个循环

awk使用的数组是关联数组
awk通常使用for循环遍历数组中的元素
示例:

遍历ss --nat连接状态的发生次数
 ss -nat|awk '!/^State/{arr[$1]++}END{for(i in arr){print i,arr[i]}}'
 arr[$1]++: $1代表第一字段,++代表第一字段相同时加1
 for(i  in arr):i遍历数组arr的下标,并把下标的值赋给变量i
 另外此块很重要的另外一部分在于语法书写的格式,这个在于多写多练,写的多了,熟练之后,自然出错的地方就会越来越少
ss -nat | awk'!/ ^ State / {arr [$ 1] ++} END {for(i in arr){print i,arr [i]}}''

rand(): 返回0到1之间的随机数,但必须与srand一起使用
格式: srand()等同于,首先调用srand()rand()生效
例如:
1: 生成0到1之间的随机数
awk‘BEGIN {print srand(),rand()}’

2: 生成1-100之间的随机整数
awk'BEGIN {srand(); print int(rand()* 100)}'int可以将输出定义为整数

3: 生成10个1-100之间的随机整数
awk'BEGIN {srand(); for(i = 0; i <= 10; i ++){print int(rand()* 100)}}'


格式:
函数名称(参数,参数等){
声明
返回表达式
}
例如: #cat fun.awk
函数max(v1,v2){
v1> v2?var = v1: var = v2
返回变量
}
BEGIN {a = 3; b = 2; print max(a,b)}
$ awk -f fak.awk
1使用系统命令
2除了awk中定义的变量外,所有其他变量都包含在“”中
例如:
awk‘BEGIN {system(“ hostname”)}'
awk'BEGIN {score = 100; system(“ echo your score is” score)}'

本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-257314-1.html

 什么是邮件服务器?
 无锅天线_无锅卫星天线是真的吗
 Flying Fire动态壁纸(动态壁纸计算机桌面)v1.1.8.8正式版
 单人(单人模式)
老旧个毛啊好歹伯克级比弯弯那点家当高到不知道那里去了