Go语言实现了二进制搜索树
电脑杂谈 发布时间:2020-06-20 17:27:27 来源:网络整理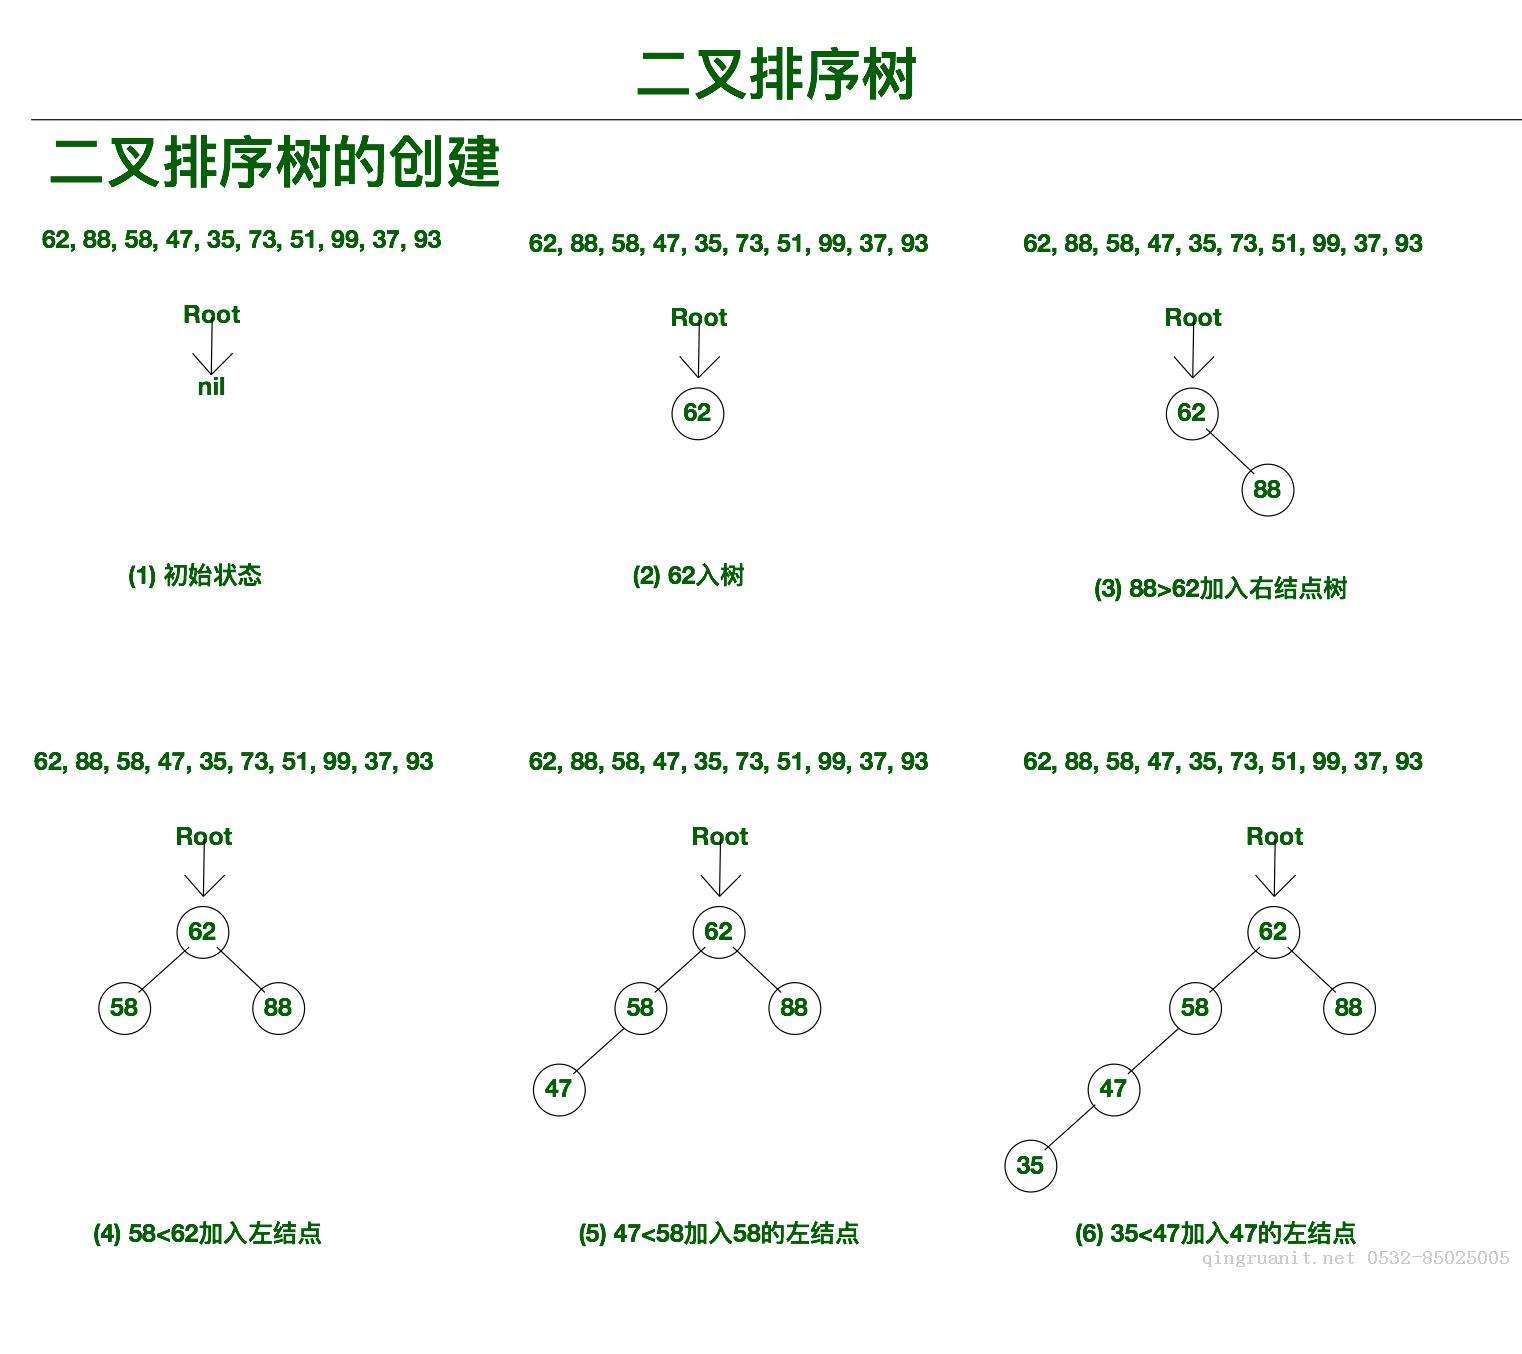
组织: 张帅博客: one8.one

1-1
文件系统和系统通常使用树(尤其是B树)数据结构数据二叉排序树的实现二叉排序树的实现,主要是为了提高排序和检索效率. 二叉树是一种最基本,最典型的排序树. 它在实践中很少用于学习和研究树的特性. 像气泡排序一样,由于效率问题,二叉树也不实用.
genny提供的代码的可重用性也是如此,树类型名为: ItemBinarySearchTree,树节点的结构定义如下:
在命令端使用
go get "github.com/cheekybits/genny/generic"
命令获取这个包
import (
    "fmt"
    "sync"
    "github.com/cheekybits/genny/generic"
)
type Item generic.Type   //generic.Type 为"github.com/cheekybits/genny/generic"这个包下面的一个空接口类型,type为generic.Type起别名为Item
type Node struct{
    key        int    //中序遍历的节点序号
    value      Item   //节点存储的值
    left       *Node  //左节点
    right      *Node   //右面节点
}
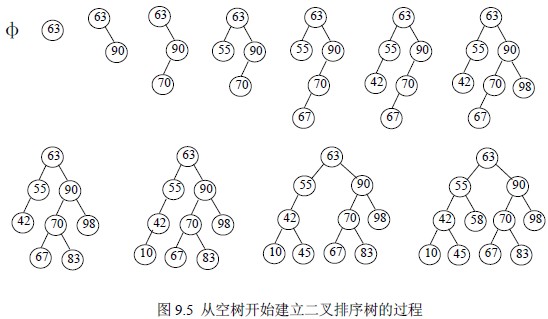
插入操作需要使用递归,插入操作需要从顶部到树中的适当位置查找新节点. 如果新节点的值小于任何节点,请继续搜索左子树,并搜索右子树. 直到再次插入叶节点.
有三种遍历操作的方式:
根据根节点的位置查看遍历的顺序

1-2
String()可视树结构


1-3
插入
//向二叉树合适的位置插入节点
func (tree *ItemBinarySearchTree) Insert(key int, value Item) {
//为了确保操作二叉树的数据安全,对数据操作进行读写上锁
    tree.lock.Lock()
    defer tree.lock.Unlock()
    newNode := &Node{key, value, nil, nil}
//如果当前的树为空,那么插入的节点作为根节点
    if tree.root == nil {
        tree.root = newNode
    } else {
    //调用下面的插入函数,另起一个方法
        insertNode(tree.root, newNode)
    }
}
//找到合适的位置
func insertNode(node, newNode *Node) {
//当新节点的值小于节点的值的时候,应该插入到节点的左侧
    if newNode.key < node.key {
    //如果旧节点左侧没有节点,那么旧节点直接赋值新节点
        if node.left == nil {
            node.left = newNode
        } else {
        //否则将左节点作为老节点,继续寻找左节点的左节点
            insertNode(node.left, newNode)
        }
    } else {
    //与上面同理
        if node.right == nil {
            node.right = newNode
        } else {
            insertNode(node.right, newNode)
        }
    }
}
搜索
//检查key的元素是否存在
func (tree *ItemBinarySearchTree) Search(key int) bool {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    return search(tree.root, key)
}
func search(node *Node, key int) bool {
    if node == nil {
        return false
    }
  //如果key的值小于节点的值,那么应该插入到左子树
    if key < node.key {
    //将左子树作为新节点,继续查询
        return search(node.left, key)
    }

    // 如果key的值大于节点的值,那么应该插入右子树
    if key > node.key {
    //将右子树作为新节点,继续查询
        return search(node.right, key)
    }
//如果当前key的值==node.key 返回true
    return true
}

删除
首先进行递归搜索,然后删除该节点. 但是,删除时,需要根据以下三种情况划分子节点的数量:

图片
func (tree *ItemBinarySearchTree) remove(key int) {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    remove(tree.root, key)

}
func remove(node *Node, key int) *Node {
    if node == nil {
        return nil
    }

   // 如果key< node.key 则向左寻找

    if key < node.key {

        // 将左节点作为新节点递归继续寻找

        node.left = remove(node.left, key)
        return node
    }
    // 如果key> node.key 则向右寻找
    if key > node.key {

    // 将右节点作为新节点递归继续寻找

        node.right = remove(node.right, key)
        return node
    }
//如果key==node.key 判断node有没有左右子树,如果没有,则直接删除
    if node.left == nil && node.right == nil {
        node = nil
        return node
    }
//如果key==node.key 判断node有没有左右子树,如果有右子树,则将右子树直接赋值给当前节点,完成覆盖删除
    if node.left == nil {
        node = node.right
        return node
    }

    //如果key==node.key 判断node有没有左右子树,如果有右子树,则将右子树直接赋值给当前节点,完成覆盖删除

    if node.right == nil {
        node = node.left
        return node
    }
    mostLeftMode := node.right
// 要删除的节点有2个字节点,找到右子树的最左节点,替换当前节点
    for {

    //一直遍历找到最左节点
        if mostLeftMode != nil && mostLeftMode.left != nil {
            mostLeftMode = mostLeftMode.left
        } else {
            break
        }
    }
// 使用右子树的最左节点替换当前的节点,即删除当前节点
    node.key, node.value = mostLeftMode.key,mostLeftMode.value
    node.right = remove(node.right, node.key)
    return node
}
最大

//获取最大节点即为二叉树最右节点,根据二叉树的性质
func (tree *ItemBinarySearchTree) Max() *Item {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    node := tree.root
    if node == nil {
        return nil
    }
    for {
        if node.right == nil {
            return &node.value
        }
        node = node.right
    }
}
Min
// 根据二叉树的性质,获取最大节点即为二叉树最右节点
func (tree *ItemBinarySearchTree) Min() *Item {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    node := tree.root
    if node == nil {
        return nil
    }
    for {
        if node.left == nil {
            return &node.value
        } else {
            node = node.left
        }
    }
}
横越
// 先序遍历:根节点 -> 左子树 ->右子树
func (tree *ItemBinarySearchTree) PreOrderTraverse(printFunc func(Item)) {
    tree.lock.Lock()
    defer tree.lock.Unlock()

    preOrderTraverse(tree.root, printFunc)
}
func preOrderTraverse(node *Node, printFunc func(Item)) {
    if node != nil {
    //先打印根节点
        printFunc(node.value)

        //然后递归调用自己,将左节点作为新节点,打印
        preOrderTraverse(node.left, printFunc)
        //然后递归调用自己,将右节点作为新节点,打印
        preOrderTraverse(node.right, printFunc)
    }
}
// 中序遍历: 左子树 ->根节点 ->右子树
func (tree *ItemBinarySearchTree) PostOrderTraverse(printFunc func(Item)) {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    postOrderTraverse(tree.root, printFunc)
}
func postOrderTraverse(node *Node, printFunc func(Item)) {
    if node != nil {
    //递归调用自己,将左节点作为新节点,打印
        preOrderTraverse(node.left, printFunc)
        //打印根节点
        printFunc(node.value)
        //递归调用自己,将右节点作为新节点,打印
        preOrderTraverse(node.right, printFunc)
    }
}
// 后序遍历: 左子树  ->右子树->根节点
func (tree *ItemBinarySearchTree) InOrderTraverse(printFunc func(Item)) {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    inOrderTraverse(tree.root, printFunc)
}
func inOrderTraverse(node *Node, printFunc func(Item)) {
    if node != nil {
     //递归调用自己,将左节点作为新节点,打印
        preOrderTraverse(node.left, printFunc)
        //递归调用自己,将右节点作为新节点,打印
        preOrderTraverse(node.right, printFunc)
        //打印根节点
        printFunc(node.value)
    }
}
字符串
//后序遍历打印树的结构
func (tree *ItemBinarySearchTree) String() {
    tree.lock.Lock()
    defer tree.lock.Unlock()
    if tree.root == nil {
        println("Tree is empty")
        return
    }
    stringify(tree.root, 0)
    println("----------------------------")
}
func stringify(node *Node, level int) {
    if node == nil {
        return
    }
    format := ""
    for i := 0; i < level; i++ {
        format += "\t" // 根据节点的深度决定缩进长度
    }
    format += "----[ "
    level++
    //  先递归打印左子树
    stringify(node.left, level)
    // 打印值
    fmt.Printf(format+"%d\n", node.key)
    //再递归打印右子树
     stringify(node.right, level)
}
对于二叉树操作,添加和删除检查都与递归相关,因此在实现时,请务必分析递归的终止条件,在正确的条件下返回,并避免无限循环.
本文来自电脑杂谈,转载请注明本文网址:
https://www.pc-fly.com/a/jisuanjixue/article-252371-1.html
相关阅读
发表评论 请自觉遵守互联网相关的政策法规,严禁发布、暴力、反动的言论

每日福利
 中国高性能计算机TOP100排名呈锕獾诎舜味峁?太平言网
 document.write( ); 四川乐山女交警谭霞10年坚守春节一线保路畅(图)
 在Ubuntu下设置您自己的“超级计算机集群”
 OGNL表达式的基本语法和用法
热点图片
超期待